Example04 / 09
与 ER 随机图和保度随机化零模型比较
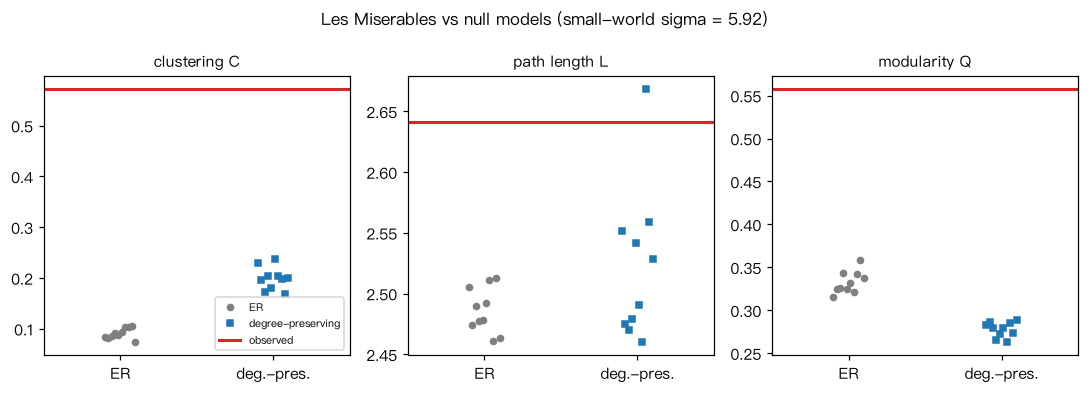
把《悲惨世界》网络(按无权图处理)与 (a) 同 N、M 的 ER 随机图、(b) 双边交换得到的保度随机化网络 各生成 10 次比较:计算平均聚集系数 C、平均最短路径 L、Louvain 模块度 Q 的均值与 z 分数, 并以 ER 为参照计算小世界系数 sigma = (C/C_rand)/(L/L_rand)。 解读:z 分数衡量真实值偏离零模型分布的程度。保度零模型更严格:它的平均 C 更接近真实值, 聚集系数的 z 随之变小;但 z 还取决于零分布的离散程度(如 Q),不宜跨零模型直接比较 z 的大小。 零模型网络若不连通,只在最大连通分支上计算指标。
Output输出图
Output文字输出
真实网络:      C = 0.573, L = 2.641, Q = 0.558
ER 零模型均值: C = 0.091, L = 2.487, Q = 0.333
保度零模型均值:C = 0.199, L = 2.522, Q = 0.278
z(ER)   C, L, Q = [48.5, 8.6, 18.8]
z(保度) C, L, Q = [17.9, 2.0, 33.2]
小世界系数 sigma = 5.92
Code代码
# 把《悲惨世界》网络(按无权图处理)与 (a) 同 N、M 的 ER 随机图、(b) 双边交换得到的保度随机化网络
# 各生成 10 次比较:计算平均聚集系数 C、平均最短路径 L、Louvain 模块度 Q 的均值与 z 分数,
# 并以 ER 为参照计算小世界系数 sigma = (C/C_rand)/(L/L_rand)。
# 解读:z 分数衡量真实值偏离零模型分布的程度。保度零模型更严格:它的平均 C 更接近真实值,
# 聚集系数的 z 随之变小;但 z 还取决于零分布的离散程度(如 Q),不宜跨零模型直接比较 z 的大小。
# 零模型网络若不连通,只在最大连通分支上计算指标。
import numpy as np
import networkx as nx

G = nx.Graph(nx.les_miserables_graph())
for u, v in G.edges():
    G[u][v].pop("weight", None)              # 去掉权重,做无权分析
N, M = G.number_of_nodes(), G.number_of_edges()

def lcc(H):
    return H.subgraph(max(nx.connected_components(H), key=len)).copy()

def measures(H, seed=0):
    H = lcc(H)
    Q = nx.community.modularity(H, nx.community.louvain_communities(H, seed=seed))
    return nx.average_clustering(H), nx.average_shortest_path_length(H), Q

real = measures(G)
er_list, ds_list = [], []
for s in range(10):
    er_list.append(measures(nx.gnm_random_graph(N, M, seed=s), seed=s))
    H = G.copy()
    nx.double_edge_swap(H, nswap=5 * M, max_tries=100 * M, seed=s)   # 保度随机化
    ds_list.append(measures(H, seed=s))
er, ds = np.array(er_list), np.array(ds_list)

z_er = (np.array(real) - er.mean(0)) / er.std(0)
z_ds = (np.array(real) - ds.mean(0)) / ds.std(0)
sigma = (real[0] / er[:, 0].mean()) / (real[1] / er[:, 1].mean())

print("真实网络:      C = %.3f, L = %.3f, Q = %.3f" % real)
print("ER 零模型均值: C = %.3f, L = %.3f, Q = %.3f" % tuple(er.mean(0)))
print("保度零模型均值:C = %.3f, L = %.3f, Q = %.3f" % tuple(ds.mean(0)))
print("z(ER)   C, L, Q =", np.round(z_er, 1).tolist())
print("z(保度) C, L, Q =", np.round(z_ds, 1).tolist())
print("小世界系数 sigma = %.2f" % sigma)

# 作图:每个指标的真实值与两种零模型的 10 次取值
import matplotlib.pyplot as plt
fig, ax = plt.subplots(1, 3, figsize=(10, 3.6))
for j, (a, nm) in enumerate(zip(ax, ["clustering C", "path length L", "modularity Q"])):
    a.plot(np.zeros(10) + np.linspace(-0.1, 0.1, 10), er[:, j], "o", color="0.5", ms=4, label="ER")
    a.plot(np.ones(10) + np.linspace(-0.1, 0.1, 10), ds[:, j], "s", color="C0", ms=4, label="degree-preserving")
    a.axhline(real[j], color="C3", lw=2, label="observed")
    a.set_xticks([0, 1]); a.set_xticklabels(["ER", "deg.-pres."]); a.set_xlim(-0.5, 1.5); a.set_title(nm, fontsize=10)
ax[0].legend(fontsize=7)
fig.suptitle(f"Les Miserables vs null models (small-world sigma = {sigma:.2f})", fontsize=11)
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。