小世界与无标度网络模型
用小世界、无标度、配置、适应度、复制–分化与空间模型解释真实网络的高聚类、短路径与枢纽,并讨论其统计判别。
以 ER 随机网络为尺子(见网络结构指标与随机图),可以量出真实网络的两个反常之处:一是聚集系数远高于同规模随机网络,二是度分布的尾巴远比泊松分布长,存在连接数极多的枢纽节点(hub)。随机网络解释不了这两件事。
本专题围绕“什么机制会产生这些结构”组织:
- 小世界:Watts–Strogatz(WS)模型说明高聚类与短路径可以并存;空间嵌入加少量长程连接是它在生物系统中最自然的实现。
- 无标度与枢纽:先介绍幂律分布本身的性质(矩的发散、自然截断、度指数决定的距离标度),再介绍两类生成思路——静态地按给定度分布连边(配置模型、隐变量模型),以及动态地让网络生长(Barabási–Albert 优先连接模型及其扩展)。
- 优先连接的来龙去脉:怎样从数据中测量优先连接、非线性优先连接会怎样改变网络、优先连接本身可能来自哪些局部机制(链接选择、复制、优化),以及适应度、初始吸引力、内部连边、节点删除、加速增长、老化对度指数的影响。
- 生物学中的生成机制:蛋白质相互作用网络的复制–分化模型及其证据与争议;脑网络等空间嵌入网络的距离依赖模型。
- 统计判别:在实际数据上怎样判断小世界性与无标度性,以及“无标度是否普遍”的争论。
这些结构性质对网络上的动力学有直接影响:度分布的二阶矩决定传播阈值(见网络上的传播与免疫),枢纽决定网络对随机失效与蓄意攻击的不同响应(见网络鲁棒性、渗流与级联失效与网络可控性与稳定性)。随机块模型等以社团为核心的生成模型见社团结构与社区发现;度相关(同配/异配)见度相关性与网络结构的高阶统计。
Contents知识页面
VIDEO讲解视频
文字稿
大家好,这一期的主题是小世界网络与无标度网络。在网络结构指标里,我们用随机网络当尺子,量出了真实网络的两处反常。这一期,我们来看两个模型怎样解释这两处反常。
第一个问题,朋友圈高度抱团,为什么任意两人之间仍然只隔几步?第二个问题,为什么少数节点能拥有成百上千条连接?第三个问题,拿到自己的数据,怎样判断它是不是小世界或无标度?
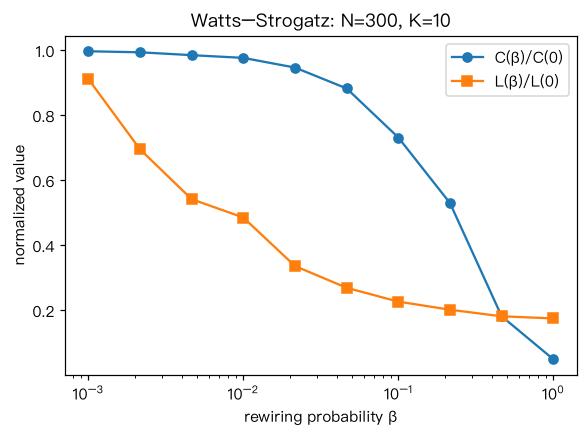
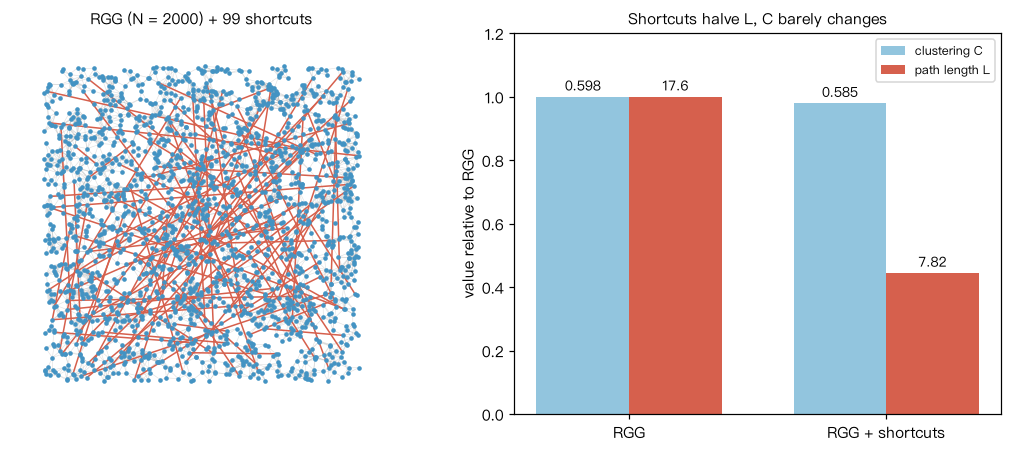
先看左边,这是一个环形规则网络,每个节点只连接身边的邻居。它的聚集系数很高,但要从一端走到另一端,需要走很多步。Watts 和 Strogatz 的做法很简单,让每条边以一定概率随机改连。注意右边两条曲线,横轴是重连概率,用的是对数刻度。重连概率只有百分之一时,平均路径已经下降了一大半。可是聚集系数几乎纹丝不动,要到概率接近十分之一以后才明显下降。原因在于,路径长度是全局量,一条捷径能让许多节点对同时受益。而聚集系数是局部量,一条边改连只破坏它附近的几个三角形。
所以我们可以这样记,要破坏聚类,需要大量的随机性。而要制造捷径,只需要一点点随机性。两者之间那片宽广的区间,就是我们说的小世界。
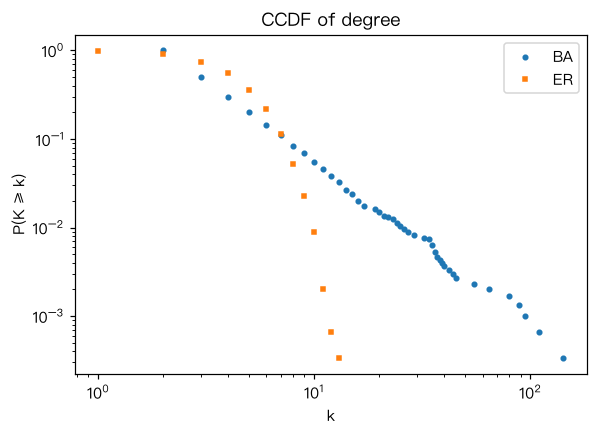
再来看第二处反常,也就是度分布。左边是随机网络,度分布集中在平均度附近,像一个鼓包。右边这种网络的分布在线性坐标下几乎贴着横轴,尾巴拖得很长。换成双对数坐标,它变成了一条近似的直线,这就是幂律分布。幂律分布没有典型尺度,随手抽一个节点,度可能是2,也可能是2000。这种度分布服从幂律的网络,我们称为无标度网络。
枢纽从哪里来?巴拉巴西和 Albert 给出了两个要素。第一是增长,网络不断加入新节点,就像不断有新论文发表。第二是优先连接,新节点更愿意连向本来连接就多的节点。大家看,节点的大小代表度,早来的节点越长越大。推导可以得到,度分布的指数等于3,而且和每次加几条边无关。如果去掉增长或者去掉优先连接,幂律就不再出现。
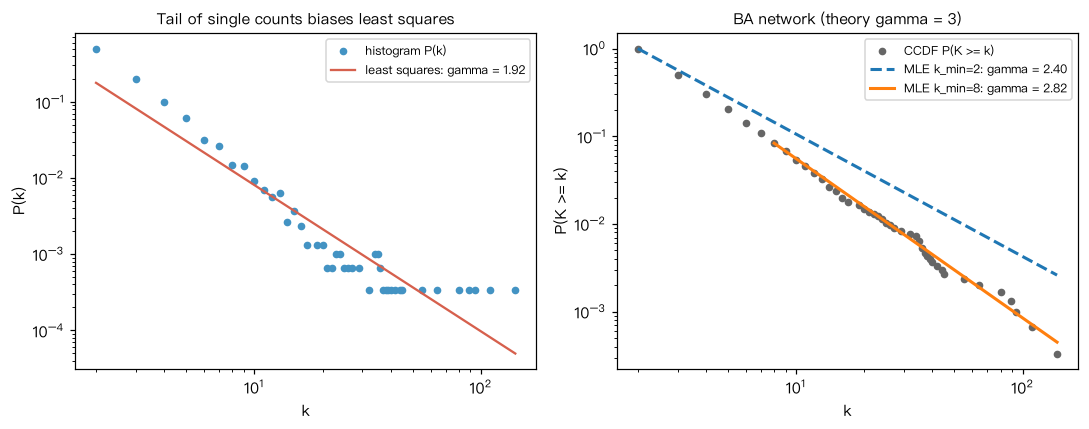
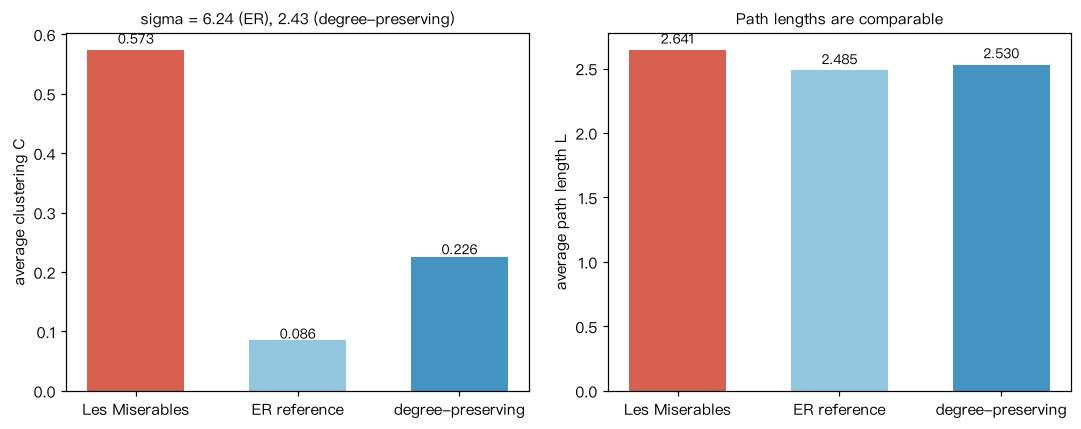
在自己的数据上怎么判断呢?小世界常用的是小世界系数。它是实际聚集系数与随机网络之比,再除以路径长度之比。要提醒大家,参照的随机网络最好保持度序列不变,结论才更严格。判断幂律,不要在双对数直方图上直接画直线拟合。应该用最大似然估计,并和对数正态等其他分布做比较。近年的研究发现,严格的无标度网络并不多,但重尾和枢纽很常见。
这些概念在生物医学里有什么用?来看蛋白质相互作用网络。在酵母中,研究者发现度越高的蛋白,敲除后越容易致死。红色标出的是枢纽,删掉它们,网络很快碎成许多小块。脑网络也是一样,它兼具小世界的高效和少数枢纽脑区。当然,这只是统计上的关联,解读时要考虑数据偏倚。
最后小结一下,小世界网络同时具有高聚类和短路径。Watts 和 Strogatz 模型说明,少量随机捷径就足以做到这一点。无标度网络的度分布是幂律,存在少数枢纽节点。巴拉巴西模型说明,增长加上优先连接就能产生枢纽。
接下来,请大家打开页面上的两个演示,亲手拖一拖重连概率。然后运行 Python 代码示例,自己画出这两条经典曲线。下一期,我们一起来看网络中的社团结构。
六度分隔:Milgram 实验与小世界现象 · 5 分 46 秒
文字稿
大家好,这是网络模型专题的第1段,我们从一个社会心理学实验讲起。这一段大约7分钟,我会讲清楚六度分隔到底测到了什么。也会告诉大家,这个著名的数字有哪些值得怀疑的地方。
1967年,社会心理学家 Milgram 设计了一个非常简单的实验。他请内布拉斯加州等地的志愿者,把一封信转交给波士顿的一位陌生人。规则只有一条,只能寄给自己直呼其名的熟人,再由熟人继续转寄。在最终送达的64封信里,平均转手大约6次。这就是六度分隔这个说法的来源,后来它还被写进了戏剧和电影。
2003年,Dodds、Muhamad 和 Watts 用电子邮件重做了这个实验。这一次的志愿者来自全世界,目标人物分布在13个国家。起始链条大约有2.4万条,真正到达目标的链条其实很少。但到达的那些链条,长度同样集中在5到7步。可见,短路径这个现象在不同年代、不同媒介下都能看到。
为什么路径会这么短?我们先做一个粗略的估算。假设每个人认识100人,那么1步之内就能联系到100人。2步就是1万人,3步就是100万人,5步就已经超过了世界人口。这种指数扩张,和随机网络的结论是一致的。随机网络的平均路径,大约是节点数的对数除以平均度的对数。代入10亿人、每人认识100人,算出来只有4.5步左右。
画面上演示的就是这个扩张过程,从一个源点出发做广度优先搜索。第一层是直接邻居,第二层是邻居的邻居,一层一层向外扩散。颜色代表到源点的距离,层数就是最短路径的长度。如果每一层碰到的都是全新的节点,只需要很少几层就能覆盖全网。大家可以数一数,画面上这个网络,最远的节点离源点只有几层。
后来,研究者在在线社交网络上直接计算了最短路径。2011年对 Facebook 约7亿活跃用户的分析,平均距离大约是4.7。2016年 Facebook 又报告了一次,平均距离降到了3.6左右。所以在今天的社交网络里,两个陌生人之间往往只隔三四个人。
但是这个估算有一个漏洞,大家先停下来想一想是什么?现实生活中,你朋友的朋友,很多本来就是你的朋友。画面上选中的这个节点,它的邻居之间也彼此相连,形成了许多三角形。这叫三角形闭合,所以社交网络的聚集系数通常很高。三角形越多,第二步认识的人重复得越多,扩张速度就远低于估算。比如你的100个朋友里,如果有一半彼此认识,第2步遇到的新人就会大打折扣。按理说高聚类会让路径变长,那社交网络为什么仍然是小世界?
在回答之前,我们先把要解释的现象说准确,这叫小世界现象。它说的是,在很大的网络里,任意两点之间的典型最短路径都很短。更准确地说,路径长度随节点数的对数增长,而不是线性增长。节点数从1000涨到100万,路径长度大约只翻一倍,而不是涨1000倍。
不过,Milgram 的实验本身有不少局限,我们要客观地看待它。第一,大部分信件没有送达,而没送达的链条往往更长,平均值被低估了。第二,起点的志愿者并不是随机抽样的,很多人本身就有一定社会资源。第三,许多信件是经过少数几个漏斗人物才到达目标的。所以六度是一个有启发性的数字,而不是一个精确的测量值。
这个实验其实还揭示了一件更微妙的事情,值得我们多想一步。每个转信人只知道自己的熟人,并不知道整张网络长什么样。可他们仅凭地理位置、职业这些局部线索,常常就能把信送到。Kleinberg 后来专门研究了这个问题,叫做网络的可搜索性。短路径存在是一回事,能不能靠局部信息找到它,又是另一回事。
这里要澄清一个常见误区,有人以为路径短就是小世界。其实随机网络的路径也很短,但它的聚集系数极低,不算小世界。小世界要求短路径和高聚类同时成立,这一点请大家牢牢记住。
生物网络里也能看到同样的现象,最经典的例子是秀丽隐杆线虫。它有302个神经元,是第一个被完整绘出接线图的神经系统。它的平均路径长度是2.65,同规模随机网络是2.25,几乎一样短。可它的聚集系数是0.28,是随机网络的5倍多。对神经系统来说,局部抱团利于专门化处理,短路径利于全身信息整合。在脑网络专题里我们会看到,人脑网络也有同样的特征。
最后小结一下,Milgram 实验让我们注意到,陌生人之间往往只隔几步。指数扩张能解释短路径,但三角形闭合又会让扩张明显变慢。高聚类和短路径怎样同时成立,就是下一段 Watts–Strogatz 模型要回答的问题。建议大家接着看这个专题的第2段,WS 模型。
Watts–Strogatz 模型:重连如何同时得到高聚类与短路径 · 6 分 10 秒
文字稿
大家好,这一段我们来讲 Watts 和 Strogatz 在1998年提出的小世界模型。上一段留下了一个问题,高聚类和短路径怎样才能同时成立?这一段我会用具体的数字,带大家看清楚其中的机制。
先看两个容易计算的极端情形,节点数1000,每个节点的度是10。第一个极端是环形规则网格,每个节点只连左右各5个最近邻。它的聚集系数大约是0.67,可平均路径大约有50步。第二个极端是同样规模的随机网络。它的聚集系数只有0.01左右,平均路径却只有3步。一个抱团但绕远,一个快捷但松散,真实网络更像哪一个呢?
Watts 和 Strogatz 在论文里给出了三组真实数据。电影演员合作网络,聚集系数0.79,同规模随机网络只有0.00027。美国西部电网,聚集系数0.08,随机网络是0.005。线虫神经网络,聚集系数0.28,随机网络是0.05。而这三个网络的平均路径,都只比随机网络稍长一点。所以真实网络既不是规则网格,也不是随机网络,而是落在两者之间。
WS 模型的构造只有两步,第一步,从刚才的环形规则网格出发。第二步,依次检查每条边,以一定概率把它的一个端点改连到随机节点。重连概率为0就是规则网格,为1就接近随机网络。重连不增加也不减少边,所以平均度始终保持不变。这样我们就得到一个可以连续调节的旋钮,从完全有序一直拧到完全随机。
在看曲线之前,我们先感受一下一条捷径有多大威力。在1000个节点的环上,正对面的两个节点相距大约50步。现在只加一条捷径,把环上正对面的两个区域直接连起来。从这一端出发做广度优先搜索,走到捷径口,跨过去,再走几步就到了。原来要走50步的节点对,现在只要十几步,而且附近成百上千的节点对都跟着受益。
现在来看动画,左边的环正按重连概率随机改连。右边两条曲线,分别是聚集系数和平均路径相对于初始值的比例。请注意,横轴是对数刻度,从万分之一一直到1。看路径这条线,重连概率还很小的时候它就掉下来了。而聚集系数这条线,在很长一段区间里几乎是平的。两条曲线之间那片宽广的区域,就是小世界区间。大致来说,重连概率在百分之一到十分之一之间,网络都处在这个区间里。
我们用一次模拟的数字,把这件事说得更具体。重连概率是百分之一时,聚集系数还保留着初始值的98%左右。而平均路径已经降到初始值的19%左右,也就是从50步降到了不到10步。重连概率到十分之一时,聚集系数还剩74%,路径只剩9%左右。换句话说,5000条边里只改连50条,路径就缩短了五分之四。
为什么两条曲线反应差这么多?关键在于一个是全局量,一个是局部量。路径长度是全局量,一条捷径能把环上相距很远的两片区域直接接通。所有经过这附近的最短路径,都会同时从这条捷径受益。聚集系数是局部量,一条边被改连,只破坏它所在的那几个三角形。有一个近似公式,聚集系数大约按1减重连概率的立方缓慢下降。代入百分之一,结果约是0.97,和模拟结果基本吻合。
所以请大家记住一句话,破坏聚类需要大量的随机性。而制造捷径,只需要一点点随机性。
这里补充一个变体,由 Newman 和 Watts 提出,叫做只加不删。它不删除原来的边,而是在规则网格上额外添加少量随机捷径。这样原有的三角形全部保留,聚集系数几乎不会下降。同时网络也不会被重连拆成几块,所以在数学上更容易分析。大家读 WS 原文时,可以想一想这个变体的两条曲线会是什么样子。
这里有一个常见误区,有人以为 WS 模型也能产生枢纽节点。其实重连之后,每个节点的度仍然集中在平均度附近,分布很窄。它也不是生长过程,节点数事先就固定了。所以 WS 模型只解释了高聚类加短路径,枢纽要靠后面讲的另一个机制。
来看一个生物医学的例子,人脑网络。用弥散成像追踪纤维,或用功能磁共振计算相关,都能构建脑网络。许多研究报告,脑网络的聚集系数远高于随机网络,路径却接近随机网络。高聚类支持局部脑区的专门化处理,我们叫它功能分离。短路径让信息几步之内传遍全脑,我们叫它功能整合。从布线成本看,少量长程纤维就换来了全局效率,这正是 WS 模型的启示。
最后小结一下,真实网络介于规则网格和随机网络之间,聚类高、路径短。WS 模型说明,只要少量随机捷径,路径就会大幅缩短。而聚集系数是局部量,在很宽的区间里基本保持不变。请大家打开页面上的 WS 演示,亲手拖动重连概率,看看两条曲线怎么变化。
幂律与无标度:枢纽节点从何而来 · 5 分 58 秒
文字稿
大家好,这一段我们离开小世界,来看真实网络的第二处反常。那就是度分布,也就是每个节点有多少条连接的统计规律。我们要回答,为什么少数节点能拥有成百上千条连接?
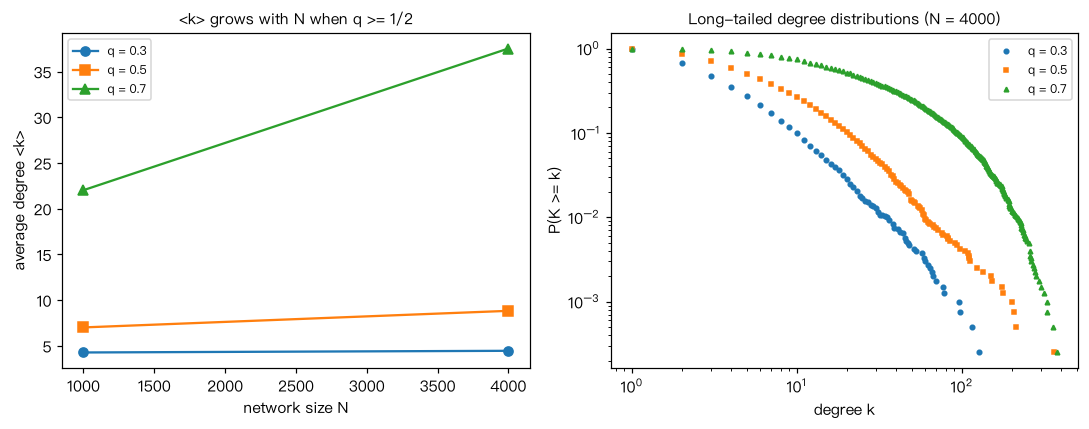
先回顾随机网络,它的度分布是泊松分布,集中在平均度附近。远离平均值的概率衰减得极快,几乎不会出现度为平均值10倍的节点。再看右边,这类网络的分布在线性坐标下几乎贴着横轴,尾巴拖得很长。换成双对数坐标,它近似变成了一条直线。1999年前后,研究者在万维网、论文引用和演员合作网络中都看到了它。不同领域的网络出现同一种形状,这在当时引起了很大的轰动。
双对数坐标下的直线,对应的就是幂律分布。度为某个值的概率,与这个度的若干次方成反比,这个幂次叫做度指数。真实网络的度指数常在2到3之间,比如万维网入度约2.1,演员网络约2.3。第二行是幂律最特别的性质,把度放大任意倍数,分布的形状都不变。所以它没有一个特征尺度,我们把这种网络叫做无标度网络。
打个比方,大家的身高集中在平均值附近,说平均身高是有意义的。没有人会比平均身高高出5倍,更不会有10米高的人。可城市人口就不一样了,从几千人的小镇到上千万人的超大城市,跨好几个数量级。小镇非常多,超大城市只有少数几个,这就是长尾分布的样子。随机网络的度像身高,无标度网络的度更像城市人口。
我们用数字比较一下两种分布有多不一样。在平均度为10的随机网络里,一个节点的度达到100,概率大约是10的负63次方。这意味着,即使把宇宙里所有的原子都当作节点,也几乎碰不到一个。而在度指数为3的幂律网络里,度不小于100的节点,是度不小于10的节点的百分之一。也就是说,枢纽在幂律网络里不是奇迹,而是必然会出现的常客。
为什么说没有典型尺度?我们算一下分布的各阶矩。当度指数在2和3之间时,平均度是有限的。但度的平方的平均值,会随着网络变大而不断增大,没有上界。也就是说方差发散,用平均度加减标准差来描述一个节点没有意义。随手抽一个节点,它的度可能是2,也可能是2000。
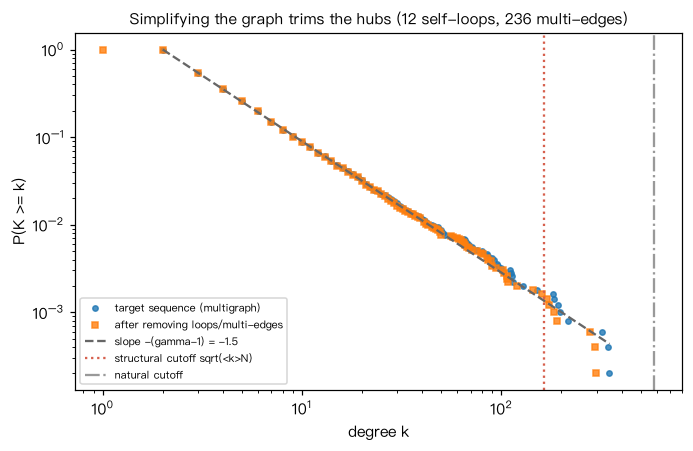
当然,真实网络是有限的,最大度也有一个自然的上限。度指数为3时,最大度大约随节点数的平方根增长。举个例子,节点数1万,枢纽的度约是最小度的100倍。节点数到100万,这个倍数就变成了1000倍。而同样规模的随机网络,最大度只比平均度高出几倍。
枢纽还有一个作用,它们是捷径的汇集点,能让路径变得更短。度指数在2和3之间时,平均路径随节点数的对数的对数增长,叫做超小世界。代入100万个节点,对数约是13.8,对数的对数只有2.6左右。也就是说,网络从1万个节点涨到100万,路径几乎感觉不到变化。
这些枢纽在生物网络里意味着什么?来看蛋白质相互作用网络。2001年,Jeong 等人分析酵母的蛋白质相互作用网络,发现度分布有长尾。更有意思的是,度越高的蛋白,敲除后致死的比例也越高。这就把枢纽从一个拓扑概念,变成了可以用实验检验的生物学假设。画面上删掉红色标出的枢纽,网络很快碎成了许多小块。不过要提醒大家,研究得越多的蛋白,测到的相互作用也越多,这里有数据偏倚。
再看代谢网络,2000年 Jeong 等人比较了43种生物的代谢网络。从细菌到真核生物,它们的度分布都有长尾。网络直径在不同物种之间几乎不变,并不随代谢物的数量增加而变长。处在枢纽位置的,是丙酮酸、辅酶 A 这类参与大量反应的核心代谢物。
枢纽的存在还带来一个重要后果,网络的鲁棒性变得很不对称。一条曲线是随机删点,删掉很多节点,巨分支仍然相当完整。另一条是专门攻击度最高的节点,只删一小部分,网络就迅速瓦解。原因很简单,随机删点多半删到的是度很小的节点,对整体影响不大。这一点在鲁棒性部分会详细展开,传播专题还会看到枢纽怎样让传染病更容易扩散。
这里有一个常见误区,看到几个度特别大的节点,就说网络是无标度的。其实对数正态等许多重尾分布,同样会产生枢纽。无标度是对整个尾部形状的判断,不是对几个节点的判断。反过来,一个网络不是严格的幂律,也完全可以有枢纽。怎样严格地判断,我们放到第5段专门讲。
最后小结一下,幂律分布在双对数坐标下近似一条直线,没有典型尺度。度指数在2和3之间时方差发散,枢纽不是奇迹而是常客。那么枢纽究竟是怎样长出来的?下一段的 BA 模型会给出答案。
BA 优先连接模型:增长 + 偏好 · 6 分 12 秒
文字稿
大家好,这一段我们来讲巴拉巴西和 Albert 在1999年提出的优先连接模型。上一段我们看到了枢纽和幂律,这一段要回答它们是怎样生成的。我会带大家一步步做一个平均场推导,只用到一点微积分,不用害怕。
巴拉巴西注意到,随机网络和 WS 模型都假设节点数是固定的。可真实网络大多在增长,网页不断被创建,论文不断被发表。所以模型的第一个要素是增长,每一步加入一个新节点,带着几条边。第二个要素是优先连接,新节点连向某个老节点的概率与它当前的度成正比。直观上就是富者愈富,被引用多的论文更容易被看到,也更容易被继续引用。这个思想并不新,Yule、Simon 和 Price 早就讨论过类似的机制。Price 在1965年研究论文引用时,就已经看到了引用次数的长尾。
我们先算一个小例子,体会一下优先连接的概率。假设现有3个节点,度分别是1、2、5,总度数是8。新节点连向度为5的那个节点,概率是8分之5,也就是六成多。而连向度为1的节点,概率只有8分之1。这条边连上之后,度为5的节点变成6,下一次被选中的机会就更大了。
来看动画,节点的大小代表它的度。每一步都有一个新节点加入,并按刚才的规则选择连接对象。大家注意,最早进入的几个节点越长越大,后来者很难追上。右边是度分布,在双对数坐标下逐渐呈现出一条直线。网络越大,这条直线的范围就越宽,尾部的枢纽也越大。请大家记住这个画面,接下来我们用推导来解释它。
下面做平均场推导,我们把每个节点的度看作时间的连续函数。每一步新增几条边,每条边贡献2个度,总度数就约等于2乘边数乘时间。某个节点的度增长速度,等于每步的边数乘以它被选中的概率。化简之后边数被约掉了,度的增长速度等于当前度除以2倍的时间。
对这个式子积分,初始条件是节点加入时的度等于每步的边数。结果是,每个节点的度都随时间的平方根增长。它还和加入时刻有关,加入越早度越大,这就是先到者优势。举个数字,每步带3条边,第100步加入的节点,到第1万步时度约为30。而第1步就进入的节点,到同一时刻度约为300,整整大了10倍。
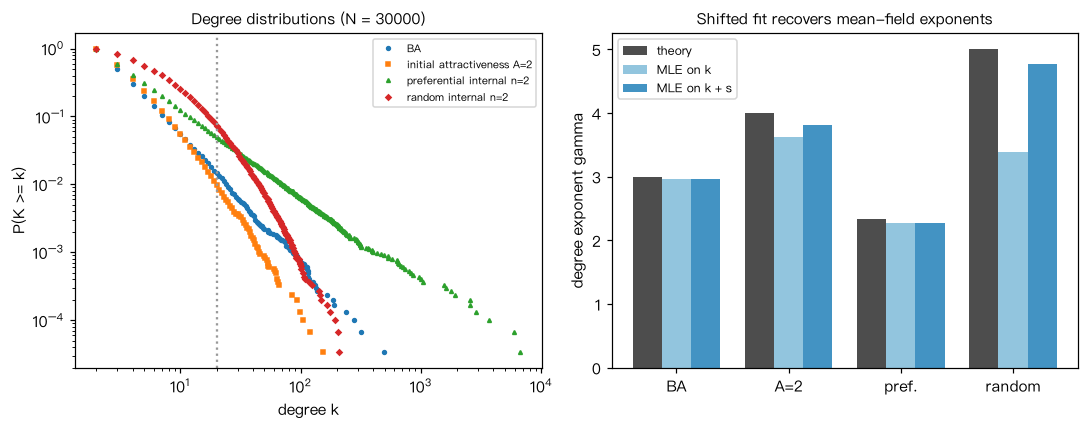
接下来求度分布,度小于某个值,等价于加入的时刻足够晚。节点按时间均匀加入,所以这个比例很好算,等于1减去一个与度平方成反比的项。再对度求导,就得到度分布与度的3次方成反比。所以 BA 模型产生度指数为3的幂律,而且与每步带几条边无关。每步的边数只决定最小度和平均度,平均度正好是它的2倍。
平均场是一种近似,这个模型其实还有精确解,就是第一行这个式子。我们代入每步2条边、度为20,精确解约是0.0013。平均场给出的是0.0010,两者已经很接近了。度越大,两者越接近,它们的尾部都与度的3次方成反比。所以平均场虽然粗糙,抓住的却是最关键的标度关系。
两个要素缺一不可,我们分别拿掉一个看看。只有增长、新节点均匀随机地连接老节点,度分布变成指数分布,没有长尾。只有优先连接、节点数固定,时间长了网络趋于几乎完全连接,幂律只是暂态。只有两者兼备,才能稳定地得到幂律。
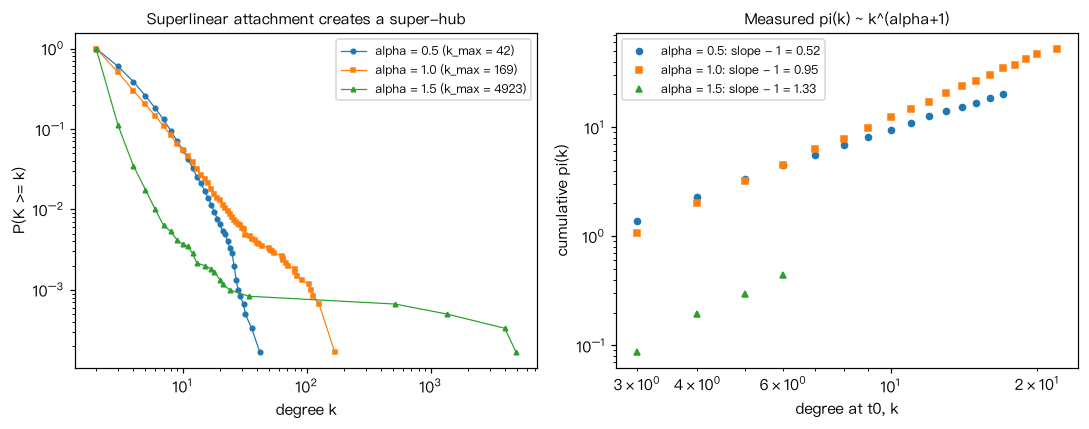
这里有两个常见误区,第一,以为每步带的边越多,度指数就越大。其实在线性优先连接下,度指数始终是3。第二,模型能产生幂律,并不代表真实网络就是按这个机制生成的。不同机制可以产生相似的分布,机制要靠独立的证据来检验。
在生物学里,什么过程像优先连接?一个有力的候选是基因复制。基因复制后,新基因继承了原基因的全部相互作用伙伴。随后在演化中分化,部分相互作用逐渐丢失。度大的蛋白邻居多,邻居被复制的机会也多,它就更容易获得新连接。所以复制分化模型在效果上等价于优先连接,同样能产生长尾度分布。当然,这是一个类比,复制之后还有选择和丢失,比 BA 模型复杂得多。
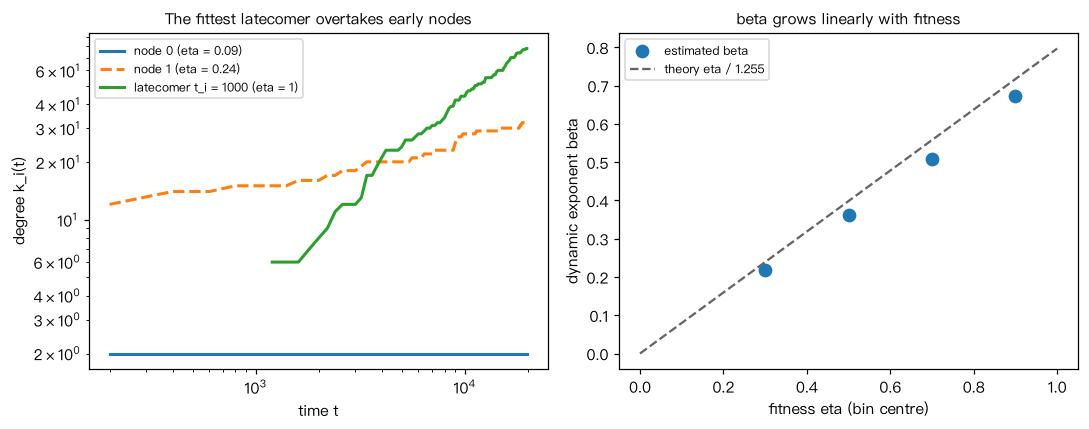
当然,BA 模型也有局限,它只能产生度指数为3,而真实网络差异很大。它的聚集系数随网络变大趋于0,和真实网络的高聚类不符。比如1万个节点时,它的聚集系数还不到0.01,远低于真实的蛋白网络。它预测老节点度最大,可现实中后来者常能反超,适应度模型就是为此提出的。
最后小结一下,BA 模型用增长加优先连接两个要素解释了枢纽的出现。平均场推导告诉我们,度按时间的平方根增长,度指数等于3,与边数无关。请大家打开 BA 演示,一步步加点,看看双对数度分布怎样变成直线。
怎样判断小世界与无标度 · 5 分 55 秒
文字稿
大家好,这是网络模型专题的最后一段,也是对大家做研究最有用的一段。拿到一个真实网络,怎样判断它是不是小世界,是不是无标度?我们先讲判据,再讲陷阱,最后讲一场至今仍有分歧的学术争论。
先看小世界,最常用的指标是小世界系数。它由 Humphries 和 Gurney 在2008年提出,用来量化小世界性。它等于实际与随机网络的聚集系数之比,再除以平均路径之比。算一个例子,线虫神经网络的聚集系数之比是0.28除以0.05,约等于5.6。路径之比是2.65除以2.25,约等于1.18。两者相除,小世界系数约为4.8,明显大于1,提示具有小世界性。
但小世界系数有个问题,随机网络的聚集系数随网络变大而趋于0。于是网络越大,这个系数越容易很大,几乎什么大网络都显得是小世界。Telesford 等人在2011年提出了另一个指标,同时与随机网络和规则网格比较。它的取值在负1到1之间,接近0表示小世界,接近1偏随机,接近负1偏规则。
无论用哪个指标,零模型的选择都决定了结论。用节点数和边数相同的随机网络当参照,是最宽松的做法。更严格的是保持度序列不变的随机化,反复交换两条边的端点就能生成。它能排除度分布本身造成的高聚类。一般至少生成100个随机网络,取它们的平均值作为参照,并报告波动范围。论文里要写清楚用了哪种零模型、生成了多少个、路径是否只在最大分支上算。
再看无标度,最常见也最不可靠的做法,是在双对数直方图上拟合直线。这样做有三个问题,第一,直方图尾部每个箱子里只有几个节点,噪声极大。第二,取对数后再做最小二乘,违反了回归的误差假设,估计是有偏的。第三,对数正态等分布,在一两个数量级内看起来也很像直线。而生物网络的度往往只跨两个数量级,这个陷阱就格外危险。
Clauset、Shalizi 和 Newman 在2009年给出了一套标准流程。第一步,画互补累积分布而不是直方图,它不需要分箱,尾部平滑得多。注意它的斜率是负的度指数减1,不要直接读成度指数。第二步,用最大似然估计度指数,公式就是第二行。第三步,用 KS 距离选出幂律开始成立的最小度。也就是只要求尾部服从幂律,低度部分可以不服从。第四步,用似然比检验,把幂律和对数正态、指数、截断幂律等逐一比较。
我们手算一个小例子,尾部有5个节点,最小度取10。它们的度分别是10、10、20、40和80。每个度除以10再取自然对数,得到0、0、0.69、1.39和2.08,加起来约4.16。用5除以4.16约等于1.2,再加1,估计的度指数约为2.2。真实数据要用几百个尾部节点,样本太少时这个估计的误差会很大。
2019年,Broido 和 Clauset 按这套严格标准,检验了近千个真实网络。他们把无标度的证据从超弱到最强分成了几级。结论是强意义上的无标度网络只占少数,对数正态往往拟合得一样好甚至更好。生物网络里,多数更接近对数正态或带截断的分布。巴拉巴西等学者随后回应,有限规模、采样不完整和度相关都会扭曲纯幂律。他们认为,重尾和枢纽的存在才是关键,不必苛求严格的幂律。说到底,双方的分歧有很大一部分来自对无标度的定义不同。
这场争论的共识可以概括为,重尾和枢纽很普遍。而严格的幂律,需要谨慎地论证。所以常见误区就是,双对数图上看着像直线,就说网络是无标度的。写论文时,与其断言无标度,不如报告分布形状、拟合方法和替代分布的比较。
这一点在脑网络研究中尤其重要。脑网络的度分布多为带指数截断的重尾分布,而不是严格的幂律。小世界指标对脑区划分方式和阈值选择也非常敏感。比较患者组和对照组时,必须控制网络密度,并使用同样的零模型。否则组间差异可能只是密度不同造成的,脑网络专题的阈值实验会专门讨论。
最后,把这一段浓缩成一张判断清单。是否小世界,看聚类和路径,用两个系数,并配上保度零模型。是否有枢纽,看互补累积分布有没有重尾。是否幂律,用最大似然、KS 距离和似然比检验。结论是否稳健,就换阈值、换数据源、换随机种子再做一遍。
网络模型专题的视频到这里就全部结束了。建议打开 Python 代码示例,亲手用最大似然拟合一次度分布。有兴趣的话,再读一读 Broido 和 Clauset 的文章,我们下一期再见。
INTERACTIVE交互可视化
CODE计算实现
10 个完整可运行的 Python 示例,每个都给出代码、输出图和解读;可在浏览器中直接运行,或下载 Jupyter Notebook · Python 脚本。
Papers论文精读
论随机图的演化
On the evolution of random graphs
Erdős P, Rényi A
让随机图的边数逐渐增加,系统刻画各种结构在何时“突然”出现,发现巨连通分支在平均度为 1 处涌现。
“小世界”网络的集体动力学
Collective dynamics of 'small-world' networks
Watts DJ, Strogatz SH
用随机重连在规则网格与随机图间插值,发现少量捷径即可使网络兼具高聚类与短路径,并在真实网络中验证。
随机网络中标度律的涌现
Emergence of scaling in random networks
Barabási A-L, Albert R
报告多个真实网络的度分布尾部近似幂律,并提出“增长 + 优先连接”模型,用平均场方法推出指数 γ=3。
复杂网络对随机故障与蓄意攻击的耐受性
Error and attack tolerance of complex networks
Albert R, Jeong H, Barabási A-L
比较随机图与无标度网络在随机删点和按度删点下的直径与碎裂过程,发现无标度网络“耐随机故障、怕蓄意攻击”。
蛋白质网络中的致死性与中心性
Lethality and centrality in protein networks
Jeong H, Mason SP, Barabási A-L, Oltvai ZN
在酵母蛋白质相互作用网络中发现度分布重尾,且度越高的蛋白敲除后越可能致死,提出“致死性–中心性”关系。
无标度网络上的流行病传播
Epidemic spreading in scale-free networks
Pastor-Satorras R, Vespignani A
用异质平均场分析无标度网络上的 SIS 模型,发现流行病阈值消失,解释了计算机病毒长期低水平流行的现象。
复杂网络的结构与功能
The structure and function of complex networks
Newman MEJ
网络科学第一个十年的系统综述:真实网络的统计特征、随机图与增长模型、网络上的渗流与传播。
复杂脑网络:结构与功能系统的图论分析
Complex brain networks: graph theoretical analysis of structural and functional systems
Bullmore E, Sporns O
系统梳理用图论分析脑结构与功能网络的流程与发现,总结小世界、枢纽、模块化等跨尺度、跨模态反复出现的特征。
经验数据中的幂律分布
Power-law distributions in empirical data
Clauset A, Shalizi CR, Newman MEJ
提出最大似然拟合、KS 选下界、自助法检验与似然比比较的幂律分析流程,并重新检验了 24 个数据集。
相互依存网络中的灾难性级联失效
Catastrophic cascade of failures in interdependent networks
Buldyrev SV, Parshani R, Paul G, Stanley HE, Havlin S
两个相互依赖的网络中,失效会来回传递并引发突变式崩溃;与单一网络相反,度分布越宽,相互依存网络越脆弱。
脑连接的复杂网络指标:用法与解读
Complex network measures of brain connectivity: uses and interpretations
Rubinov M, Sporns O
按神经科学含义整理脑网络常用图论指标及其解读,并发布 Brain Connectivity Toolbox。
无标度网络是罕见的
Scale-free networks are rare
Broido AD, Clauset A
用严格的统计检验分析 928 个真实网络数据集,发现强无标度结构很少见,对数正态往往拟合得同样好或更好。
References核心文献
Watts & Strogatz 1998:Collective dynamics of ‘small-world’ networks
- 出处:Nature 393: 440–442。DOI:10.1038/30918。论文精读:Watts 1998
- 背景:当时的网络模型要么是完全规则的,要么是完全随机的,社会学中的“六度分隔”缺少一个可计算的机制模型。
- 核心发现:提出以重连概率 在两者之间插值的模型;发现存在一个宽广的 区间,使网络同时具有高聚类和短路径;在演员网络、电网和线虫神经网络中都找到了这种特征;并用模拟说明小世界结构会加快传染病的传播。
- 阅读提示:重点看图 2( 与 随 的变化,注意横轴是对数坐标)和表 1;思考作者所说的“随机网络”具体是如何构造的。
- 思考题:如果把重连换成“只加捷径、不删原有边”(Newman–Watts 变体), 和 的曲线会怎样变化?为什么这个变体在数学上更容易分析?
Barabási & Albert 1999:Emergence of scaling in random networks
- 出处:Science 286: 509–512。DOI:10.1126/science.286.5439.509。论文精读:Barabási 1999
- 背景:多个领域的网络数据同时出现长尾度分布,而 ER 与 WS 模型都无法产生这种分布。
- 核心发现:报告演员网络、万维网和电网的度分布尾部近似幂律;提出“增长 + 优先连接”模型,用平均场方法推出 ;并证明两个要素缺一不可。
- 阅读提示:论文中幂律指数是从双对数图上读出来的,这在今天看来不够严格(参见 Clauset 等 2009);注意区分“模型能产生幂律”与“真实网络就是这样生成的”。
- 思考题:对于蛋白质相互作用网络,“新节点”和“优先连接”分别可能对应什么生物学过程?这个类比在哪里会失效?
Bianconi & Barabási 2001:Competition and multiscaling in evolving networks
- 出处:Europhysics Letters 54: 436–442。DOI:10.1209/epl/i2001-00260-6。姊妹篇:Bose–Einstein condensation in complex networks,Phys. Rev. Lett. 86: 5632–5635,DOI:10.1103/PhysRevLett.86.5632
- 背景:BA 模型中最早的节点永远领先,无法解释后来者居上。
- 核心发现:引入节点适应度,推出依赖适应度的动态指数 与自洽方程;姊妹篇建立了与玻色气体的映射,预言“适者富”与“赢家通吃”两种相。
- 阅读提示:先在均匀适应度下自己推一遍 ;再想想凝聚相对应的是哪类真实系统。
- 思考题:只给你一个时间点的网络快照,能否区分“早到”与“适应度高”?需要什么额外数据?
Newman, Strogatz & Watts 2001:Random graphs with arbitrary degree distributions and their applications
- 出处:Physical Review E 64: 026118。DOI:10.1103/PhysRevE.64.026118
- 背景:真实网络的度分布不是泊松分布,ER 网络的解析结果无法直接套用。
- 核心发现:用生成函数系统地求解配置模型的巨连通分支、分支大小分布、平均距离等性质,并推广到有向与二分网络。
- 阅读提示:生成函数 、 的含义(随机节点与随机边末端)是理解渗流与传播的钥匙,可与网络鲁棒性、渗流与级联失效对照阅读。
- 思考题:配置模型假设网络局部是树状的。对于聚类很高的生物网络,这一假设会让预测偏向哪个方向?
Vázquez, Flammini, Maritan & Vespignani 2003:Modeling of protein interaction networks
- 出处:ComPlexUs 1: 38–44。DOI:10.1159/000067642
- 背景:酵母双杂交数据显示 PPI 网络有长尾度分布,需要一个基于分子演化而非“新节点优先连接”的解释。
- 核心发现:提出基于基因复制与相互作用分化的网络生长模型,说明复制机制在效果上产生优先连接,并能再现 PPI 网络的度分布与聚类特征。
- 阅读提示:对照 Solé 等(2002)与 Pastor-Satorras 等(2003)的版本,注意各模型在“谁丢边”“是否加入新边”上的差别,以及这些差别对度指数的影响。
- 思考题:Wagner(2001)估计复制后相互作用丢失得很快。这对模型中的保留概率意味着什么?平均度还能保持稳定吗?
Broido & Clauset 2019:Scale-free networks are rare
- 出处:Nature Communications 10: 1017。DOI:10.1038/s41467-019-08746-5。论文精读:Broido 2019
- 背景:“无标度网络普遍存在”在 2000 年代几乎成为共识,但多数证据来自双对数图上的目测。
- 核心发现:用最大似然拟合和似然比检验分析近千个网络数据集,按证据强弱分级;严格意义上的无标度网络只占少数,生物网络中多数更接近对数正态或截断分布。
- 阅读提示:留意作者对“无标度”的定义层级(从“超弱”到“最强”);这篇文章发表后有多篇回应(如 Voitalov 等 2019;Holme 2019),可以对照阅读,体会“定义不同导致结论不同”。
- 思考题:如果你的研究结论依赖于“网络中存在枢纽”,那么它是否必须依赖“度分布严格服从幂律”?
补充文献
- Ohno S. Evolution by Gene Duplication. Springer, 1970.(专著)
- Penrose M. Random Geometric Graphs. Oxford University Press, 2003.(专著)
- Kleinberg J. Navigation in a small world. Nature, 2000, 406: 845. DOI: 10.1038/35022643
- Newman MEJ, Watts DJ. Renormalization group analysis of the small-world network model. Phys. Lett. A, 1999, 263: 341–346. DOI: 10.1016/S0375-9601(99)00757-4
- Barrat A, Weigt M. On the properties of small-world network models. Eur. Phys. J. B, 2000, 13: 547–560. DOI: 10.1007/s100510050067
- Cohen R, Havlin S. Scale-free networks are ultrasmall. Phys. Rev. Lett., 2003, 90: 058701. DOI: 10.1103/PhysRevLett.90.058701
- Molloy M, Reed B. A critical point for random graphs with a given degree sequence. Random Struct. Algorithms, 1995, 6: 161–180. DOI: 10.1002/rsa.3240060204
- Boguñá M, Pastor-Satorras R, Vespignani A. Cut-offs and finite size effects in scale-free networks. Eur. Phys. J. B, 2004, 38: 205–209. DOI: 10.1140/epjb/e2004-00038-8
- Goh K-I, Kahng B, Kim D. Universal behavior of load distribution in scale-free networks. Phys. Rev. Lett., 2001, 87: 278701. DOI: 10.1103/PhysRevLett.87.278701
- Caldarelli G, Capocci A, De Los Rios P, Muñoz MA. Scale-free networks from varying vertex intrinsic fitness. Phys. Rev. Lett., 2002, 89: 258702. DOI: 10.1103/PhysRevLett.89.258702
- Maslov S, Sneppen K. Specificity and stability in topology of protein networks. Science, 2002, 296: 910–913. DOI: 10.1126/science.1065103
- Price DJdS. Networks of scientific papers. Science, 1965, 149: 510–515. DOI: 10.1126/science.149.3683.510
- Price DJdS. A general theory of bibliometric and other cumulative advantage processes. J. Am. Soc. Inf. Sci., 1976, 27: 292–306. DOI: 10.1002/asi.4630270505
- Dorogovtsev SN, Mendes JFF, Samukhin AN. Structure of growing networks with preferential linking. Phys. Rev. Lett., 2000, 85: 4633–4636. DOI: 10.1103/PhysRevLett.85.4633
- Krapivsky PL, Redner S, Leyvraz F. Connectivity of growing random networks. Phys. Rev. Lett., 2000, 85: 4629–4632. DOI: 10.1103/PhysRevLett.85.4629
- Bollobás B, Riordan O, Spencer J, Tusnády G. The degree sequence of a scale-free random graph process. Random Struct. Algorithms, 2001, 18: 279–290. DOI: 10.1002/rsa.1009
- Bollobás B, Riordan O. The diameter of a scale-free random graph. Combinatorica, 2004, 24: 5–34. DOI: 10.1007/s00493-004-0002-2
- Fronczak A, Fronczak P, Hołyst JA. Mean-field theory for clustering coefficients in Barabási–Albert networks. Phys. Rev. E, 2003, 68: 046126. DOI: 10.1103/PhysRevE.68.046126
- Jeong H, Néda Z, Barabási A-L. Measuring preferential attachment in evolving networks. Europhys. Lett., 2003, 61: 567–572. DOI: 10.1209/epl/i2003-00166-9
- Holme P, Kim BJ. Growing scale-free networks with tunable clustering. Phys. Rev. E, 2002, 65: 026107. DOI: 10.1103/PhysRevE.65.026107
- Fabrikant A, Koutsoupias E, Papadimitriou CH. Heuristically optimized trade-offs: a new paradigm for power laws in the Internet. ICALP 2002, LNCS 2380: 110–122. DOI: 10.1007/3-540-45465-9_11
- Kong JS, Sarshar N, Roychowdhury VP. Experience versus talent shapes the structure of the Web. PNAS, 2008, 105: 13724–13729. DOI: 10.1073/pnas.0805921105
- Wang D, Song C, Barabási A-L. Quantifying long-term scientific impact. Science, 2013, 342: 127–132. DOI: 10.1126/science.1237825
- Dorogovtsev SN, Mendes JFF. Evolution of networks with aging of sites. Phys. Rev. E, 2000, 62: 1842–1845. DOI: 10.1103/PhysRevE.62.1842
- Dorogovtsev SN, Mendes JFF. Effect of the accelerating growth of communications networks on their structure. Phys. Rev. E, 2001, 63: 025101. DOI: 10.1103/PhysRevE.63.025101
- Moore C, Ghoshal G, Newman MEJ. Exact solutions for models of evolving networks with addition and deletion of nodes. Phys. Rev. E, 2006, 74: 036121. DOI: 10.1103/PhysRevE.74.036121
- Solé RV, Pastor-Satorras R, Smith E, Kepler TB. A model of large-scale proteome evolution. Adv. Complex Syst., 2002, 5: 43–54. DOI: 10.1142/S021952590200047X
- Pastor-Satorras R, Smith E, Solé RV. Evolving protein interaction networks through gene duplication. J. Theor. Biol., 2003, 222: 199–210. DOI: 10.1016/S0022-5193(03)00028-6
- Ispolatov I, Krapivsky PL, Yuryev A. Duplication-divergence model of protein interaction network. Phys. Rev. E, 2005, 71: 061911. DOI: 10.1103/PhysRevE.71.061911
- Wagner A. The yeast protein interaction network evolves rapidly and contains few redundant duplicate genes. Mol. Biol. Evol., 2001, 18: 1283–1292. DOI: 10.1093/oxfordjournals.molbev.a003913
- Wagner A. How the global structure of protein interaction networks evolves. Proc. R. Soc. B, 2003, 270: 457–466. DOI: 10.1098/rspb.2002.2269
- Eisenberg E, Levanon EY. Preferential attachment in the protein network evolution. Phys. Rev. Lett., 2003, 91: 138701. DOI: 10.1103/PhysRevLett.91.138701
- Teichmann SA, Babu MM. Gene regulatory network growth by duplication. Nat. Genet., 2004, 36: 492–496. DOI: 10.1038/ng1340
- Middendorf M, Ziv E, Wiggins CH. Inferring network mechanisms: the Drosophila melanogaster protein interaction network. PNAS, 2005, 102: 3192–3197. DOI: 10.1073/pnas.0409515102
- Presser A, Elowitz MB, Kellis M, Kishony R. The evolutionary dynamics of the Saccharomyces cerevisiae protein interaction network after duplication. PNAS, 2008, 105: 950–954. DOI: 10.1073/pnas.0707293105
- Kim WK, Marcotte EM. Age-dependent evolution of the yeast protein interaction network suggests a limited role of gene duplication and divergence. PLoS Comput. Biol., 2008, 4: e1000232. DOI: 10.1371/journal.pcbi.1000232
- Hakes L, Pinney JW, Robertson DL, Lovell SC. Protein-protein interaction networks and biology—what’s the connection? Nat. Biotechnol., 2008, 26: 69–72. DOI: 10.1038/nbt0108-69
- Stumpf MPH, Wiuf C, May RM. Subnets of scale-free networks are not scale-free: sampling properties of networks. PNAS, 2005, 102: 4221–4224. DOI: 10.1073/pnas.0501179102
- Pržulj N, Corneil DG, Jurisica I. Modeling interactome: scale-free or geometric? Bioinformatics, 2004, 20: 3508–3515. DOI: 10.1093/bioinformatics/bth436
- Higham DJ, Rašajski M, Pržulj N. Fitting a geometric graph to a protein–protein interaction network. Bioinformatics, 2008, 24: 1093–1099. DOI: 10.1093/bioinformatics/btn079
- Dall J, Christensen M. Random geometric graphs. Phys. Rev. E, 2002, 66: 016121. DOI: 10.1103/PhysRevE.66.016121
- Waxman BM. Routing of multipoint connections. IEEE J. Sel. Areas Commun., 1988, 6: 1617–1622. DOI: 10.1109/49.12889
- Kaiser M, Hilgetag CC. Spatial growth of real-world networks. Phys. Rev. E, 2004, 69: 036103. DOI: 10.1103/PhysRevE.69.036103
- Barthélemy M. Spatial networks. Phys. Rep., 2011, 499: 1–101. DOI: 10.1016/j.physrep.2010.11.002
- Bullmore E, Sporns O. The economy of brain network organization. Nat. Rev. Neurosci., 2012, 13: 336–349. DOI: 10.1038/nrn3214
- Ercsey-Ravasz M, Markov NT, Lamy C, et al. A predictive network model of cerebral cortical connectivity based on a distance rule. Neuron, 2013, 80: 184–197. DOI: 10.1016/j.neuron.2013.07.036
- Betzel RF, Avena-Koenigsberger A, Goñi J, et al. Generative models of the human connectome. NeuroImage, 2016, 124: 1054–1064. DOI: 10.1016/j.neuroimage.2015.09.041
- Vértes PE, Alexander-Bloch AF, Gogtay N, et al. Simple models of human brain functional networks. PNAS, 2012, 109: 5868–5873. DOI: 10.1073/pnas.1111738109
- Akarca D, Vértes PE, Bullmore ET, et al. A generative network model of neurodevelopmental diversity in structural brain organization. Nat. Commun., 2021, 12: 4216. DOI: 10.1038/s41467-021-24430-z
- Krioukov D, Papadopoulos F, Kitsak M, Vahdat A, Boguñá M. Hyperbolic geometry of complex networks. Phys. Rev. E, 2010, 82: 036106. DOI: 10.1103/PhysRevE.82.036106
- Papadopoulos F, Kitsak M, Serrano MÁ, Boguñá M, Krioukov D. Popularity versus similarity in growing networks. Nature, 2012, 489: 537–540. DOI: 10.1038/nature11459
- Voitalov I, van der Hoorn P, van der Hofstad R, Krioukov D. Scale-free networks well done. Phys. Rev. Research, 2019, 1: 033034. DOI: 10.1103/PhysRevResearch.1.033034
- Holme P. Rare and everywhere: perspectives on scale-free networks. Nat. Commun., 2019, 10: 1016. DOI: 10.1038/s41467-019-09038-8
- Lima-Mendez G, van Helden J. The powerful law of the power law and other myths in network biology. Mol. BioSyst., 2009, 5: 1482–1493. DOI: 10.1039/b908681a
Data & tools相关数据与软件
Further延伸资源
| 类型 | 资源 | 说明 |
|---|---|---|
| 教材 | Barabási《Network Science》第 3–6 章(networksciencebook.com;CC BY-NC-SA 2.0) | 免费在线教材。第 4 章 The Scale-Free Property(chapter/4:幂律、枢纽、超小世界、度指数的作用、配置模型与隐变量模型,进阶专题含幂律拟合);第 5 章 The Barabási–Albert Model(chapter/5:度动力学、测量与非线性优先连接、优先连接的起源、直径与聚集);第 6 章 Evolving Networks(chapter/6:适应度模型、玻色–爱因斯坦凝聚、初始吸引力、内部连边、删点、加速增长、老化)。本专题的覆盖面对照这三章整理 |
| 教材 | Newman《Networks》(第 2 版,Oxford University Press,2018) | 第 11–13 章(随机图、配置模型与生成函数、网络形成模型:Price 模型、BA 模型、复制模型、优化模型)给出比本页更完整的推导 |
| 公开课 | Stanford CS224W: Machine Learning with Graphs(主页) | 英文公开课;“小世界与网络模型”部分与本专题对应,视频在 YouTube(需境外网络) |
| 经典综述 | Albert & Barabási 2002, Rev. Mod. Phys.(DOI) | 小世界与无标度网络的系统综述,第 IV–VII 节对应本专题,适合需要推导细节的读者 |
| 经典综述 | Newman 2003, SIAM Review(论文精读见 Newman 2003) | 网络结构与功能的综述,配置模型、生成函数与网络生长模型部分与本专题直接相关 |
| 方法论文 | Clauset, Shalizi & Newman 2009, SIAM Review(DOI) | 幂律拟合的标准方法,第 3–5 节最重要;做度分布分析前必读。论文精读见 Clauset 2009 |
| 生物综述 | Barabási & Oltvai 2004, “Network biology”, Nat. Rev. Genet.(DOI) | 把小世界、无标度、模块性落到细胞网络上 |
| 批判性综述 | Lima-Mendez & van Helden 2009, Mol. BioSyst.(DOI) | 梳理网络生物学中关于幂律与枢纽的过度解读,与上面的综述对照阅读 |
| 空间网络综述 | Barthélemy 2011, Phys. Rep.(DOI) | 空间网络的模型、度量与零模型,适合研究脑网络、血管网络的读者 |
| 脑网络综述 | Bullmore & Sporns 2009, Nat. Rev. Neurosci.(DOI);Bullmore & Sporns 2012(DOI) | 脑结构与功能网络的图论分析,以及布线代价与拓扑效率的权衡;论文精读见 Bullmore 2009 |
| 软件文档 | NetworkX 图生成器文档(networkx.org) | watts_strogatz_graph、newman_watts_strogatz_graph、barabasi_albert_graph、powerlaw_cluster_graph(Holme–Kim)、configuration_model、expected_degree_graph(Chung–Lu)、duplication_divergence_graph、random_geometric_graph、waxman_graph
等函数,配合本专题代码示例使用 |
Open questions开放问题
- 选一个与你研究方向相关的生物医学网络(例如某种疾病的基因共表达网络、某个脑图谱下的功能网络)。你预期它是小世界网络吗?是否存在枢纽?如果要用数据检验,你会选择什么样的零模型(ER、保度随机化、空间零模型),结论可能对哪些分析选择(阈值、节点定义、数据来源)敏感?
- BA 模型用“富者愈富”解释枢纽的出现。在你熟悉的生物系统中,有没有类似的“累积优势”机制(例如基因复制、神经发育中的突触竞争、科研中的“热门基因”效应)?它与 BA 模型的假设有哪些相同与不同?
- 复制–分化、优先连接、空间几何与“晶体生长”模型都能部分解释蛋白质相互作用网络的结构。如果你能获得多个物种的相互作用组与基因系统发育信息,你会设计什么分析来区分这些机制?观测偏倚会如何干扰判断?
- 在脑网络中,空间约束可以单独产生高聚类与模块性。你会如何设计零模型,使得“患者组小世界性改变”的结论不被布线距离或图谱分辨率的差异所解释?