Example06 / 10
非线性优先连接 Π(k) ∝ k^α 与“测量”优先连接
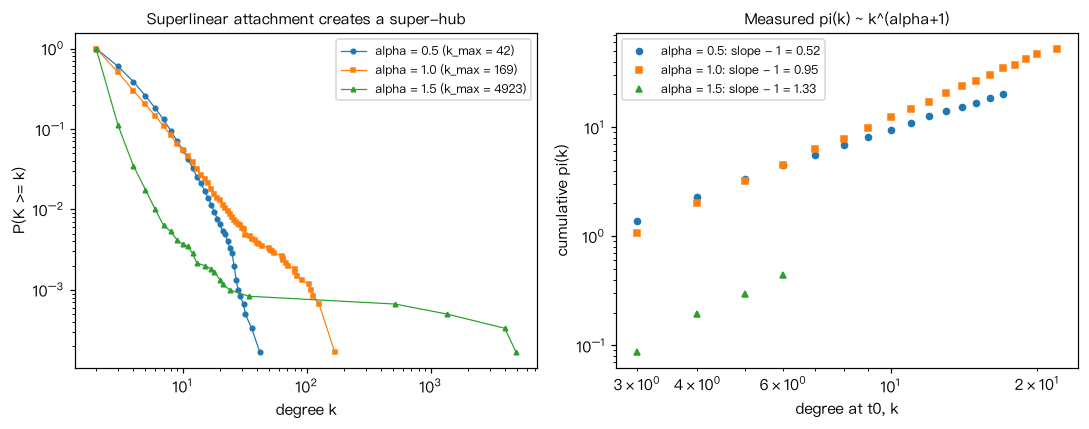
用同一个生长过程(每步加入 1 个节点、带 m=2 条边)分别取 α=0.5、1、1.5,比较最大度与 CCDF 尾部: 亚线性时枢纽受限(拉伸指数),超线性时出现“赢家通吃”的超级枢纽。 然后按 Jeong、Néda、Barabási(2003)的思路测量 Π(k):记录 t0 时各节点的度,统计此后 Δt 内各度类获得新边的数目, 得到累积函数 π(k)=Σ_{k’<k}Π(k’),在双对数下拟合斜率 ≈ α+1。 输出:k_max 依次约为 40、170、近 5000(α=1.5 时一个节点连到了绝大多数新节点); 由 π(k) 估计的 α 依次接近 0.5、1、1.5,超线性时因度类稀疏而低估。
Output输出图
Output文字输出
α=0.5: k_max=   42, 最大节点占全部边端点的比例=0.002, 由 π(k) 斜率估计 α≈0.52
α=1.0: k_max=  169, 最大节点占全部边端点的比例=0.007, 由 π(k) 斜率估计 α≈0.95
α=1.5: k_max= 4923, 最大节点占全部边端点的比例=0.205, 由 π(k) 斜率估计 α≈1.33
Code代码
# 用同一个生长过程(每步加入 1 个节点、带 m=2 条边)分别取 α=0.5、1、1.5,比较最大度与 CCDF 尾部:
# 亚线性时枢纽受限(拉伸指数),超线性时出现“赢家通吃”的超级枢纽。
# 然后按 Jeong、Néda、Barabási(2003)的思路测量 Π(k):记录 t0 时各节点的度,统计此后 Δt 内各度类获得新边的数目,
# 得到累积函数 π(k)=Σ_{k'<k}Π(k'),在双对数下拟合斜率 ≈ α+1。
# 输出:k_max 依次约为 40、170、近 5000(α=1.5 时一个节点连到了绝大多数新节点);
#       由 π(k) 估计的 α 依次接近 0.5、1、1.5,超线性时因度类稀疏而低估。
import numpy as np


def grow(n, m, alpha, seed=0, record_at=None):
    """非线性优先连接生长;返回最终度数组,以及(可选)在 record_at 时刻之后各节点按初始度统计的新增边数。"""
    rng = np.random.default_rng(seed)
    deg = np.zeros(n)
    deg[: m + 1] = m                       # 初始:m+1 个节点的完全图
    k_at_t0, gained = None, None
    for t in range(m + 1, n):
        if record_at is not None and t == record_at:
            k_at_t0 = deg[:t].copy()
            gained = np.zeros(t)
        w = deg[:t] ** alpha
        targets = rng.choice(t, size=m, replace=False, p=w / w.sum())
        deg[targets] += 1
        deg[t] = m
        if gained is not None:
            gained[targets[targets < len(gained)]] += 1
    return deg, k_at_t0, gained


n, m = 6000, 2
results = []                                # 存下结果用于作图
for alpha in [0.5, 1.0, 1.5]:
    deg, k0, g = grow(n, m, alpha, seed=1, record_at=4000)
    # 测量:度为 k 的节点在 Δt 内平均获得的新边数 ∝ Π(k)
    ks = np.unique(k0)
    Pi = np.array([g[k0 == k].mean() for k in ks])
    cum = np.cumsum(Pi)                     # π(k) 的离散近似
    sel = (ks >= 3) & (ks <= np.percentile(k0, 99))
    slope = np.polyfit(np.log(ks[sel]), np.log(cum[sel]), 1)[0]
    print("α=%.1f: k_max=%5d, 最大节点占全部边端点的比例=%.3f, 由 π(k) 斜率估计 α≈%.2f"
          % (alpha, deg.max(), deg.max() / deg.sum(), slope - 1))
    results.append((alpha, deg, ks[sel], cum[sel], slope))

# 作图:左为三种 α 的度分布 CCDF;右为测得的累积优先连接函数 π(k) 及其斜率
import matplotlib.pyplot as plt

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10, 4))
for (alpha, deg, kk, cc, sl), mk in zip(results, ["o", "s", "^"]):
    xs = np.sort(np.unique(deg))
    ax1.loglog(xs, [(deg >= x).mean() for x in xs], mk + "-", ms=3, lw=0.8, label="alpha = %.1f (k_max = %d)" % (alpha, deg.max()))
    ax2.loglog(kk, cc, mk, ms=4, label="alpha = %.1f: slope - 1 = %.2f" % (alpha, sl - 1))
ax1.set_xlabel("degree k"); ax1.set_ylabel("P(K >= k)"); ax1.legend(fontsize=8)
ax1.set_title("Superlinear attachment creates a super-hub", fontsize=10)
ax2.set_xlabel("degree at t0, k"); ax2.set_ylabel("cumulative pi(k)"); ax2.legend(fontsize=8)
ax2.set_title("Measured pi(k) ~ k^(alpha+1)", fontsize=10)
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。