网络构建与统计验证
从影像、量表、表达谱和相互作用数据库到网络,再到可信结论:节点与边的定义、连接估计、阈值、零模型、统计推断与稳定性检验。
网络分析中最容易被低估的一步,是“网络从哪里来”。一个脑网络、症状网络、共表达网络或蛋白质相互作用网络,都不是直接测量得到的对象,而是一连串建模决定的产物:什么算一个节点,什么算一条边,边权用什么统计量估计,保留哪些边,和什么样的参照对象比较,用什么方法控制假阳性。每一步都可能改变后面所有的拓扑指标,因此“网络构建”本身就是一个需要报告、检验和论证的统计推断问题。
这一专题按数据流程组织:先讨论不同数据类型中节点与边的含义(节点与边的定义),再讨论边权的估计与估计误差(连接强度的估计)、从时间序列推断方向(从时间序列推断有向边)、从稠密矩阵到网络的稀疏化(阈值、加权与稀疏化)、边权误差如何传到指标上(边权不确定性向网络指标的传播),然后是三类验证:与零模型比较(零模型与空模型)、组间比较与多重比较控制(统计推断与多重比较、网络之间的距离与相似性)、对数据缺陷与结果稳定性的检查(测量误差、缺失与偏倚、采样网络与不完整观测、稳定性与可重复性),以及研究设计阶段的 样本量与统计功效。
它与 网络结构指标与随机图 互为前后:后者定义指标,这里讨论指标在什么条件下可以被解释。各应用领域的具体流程分别见 脑连接组、症状网络、基因调控网络推断 与 网络医学;分析报告的规范见 可复现分析与敏感性分析。
Contents知识页面
VIDEO讲解视频
文字稿
大家好,这一期讨论网络分析中最容易被低估的一步,网络从哪里来。脑网络、症状网络、共表达网络,都不是直接测量得到的对象。它们是一连串建模决定的产物,每一步都可能改变后面所有的指标。
第一,什么算一个节点,脑区、基因、症状,还是一个量表条目。第二,什么算一条边,物理结合、统计关联,还是因果作用。第三,边权用什么统计量估计,误差有多大。第四,从稠密的矩阵中保留哪些边。第五,和什么样的参照对象比较,用什么方法控制假阳性。Zalesky 等人发现,仅换脑区划分的分辨率,小世界性和度分布等指标就会系统变化。
物理连接是可直接观察的实体联系,比如蛋白结合、突触和白质纤维束。统计关联是测量值的共同变化,比如功能连接里的时间序列相关。功能关联是参与同一过程的证据,比如 STRING 数据库的综合得分。因果或有向关系,指一个变量的变化导致另一个变量变化,比如转录因子调控靶基因。在统计关联网络里,最短路径并没有明确的物理含义。有向边需要时间顺序、干预或很强的结构假设,才能被识别。
这是一个模拟的症状网络,先看相关网络,几乎每两个症状之间都有边。问题是间接关联也会成边,A影响B,B影响C,A和C仍然高度相关。偏相关在控制其余所有变量之后,度量两个变量之间的关联。现在画面换成偏相关网络,只留下控制其他症状后仍然存在的直接关联。右边的条形图是强度中心性,也就是每个症状所有边的绝对值之和。不过偏相关仍然不是因果,在对撞结构里,它反而会制造原本不存在的关联。
偏相关可以由协方差矩阵的逆,也就是精度矩阵直接算出。边权本身也有误差,Fisher z 变换让相关系数的方差近似只依赖样本量。由此可以算出,要把置信区间宽度缩小一半,样本量大约要变成原来的4倍。fMRI 信号有很强的自相关,独立观测数远少于时间点数,不能直接当作样本量。变量多、样本少时,协方差矩阵接近奇异,常用收缩估计或图形 LASSO。正则化会把边权压向0,估计出没有边,可能只是功效不足。
相关矩阵是稠密的,多数图论指标却定义在二值网络上,于是要决定保留哪些边。画面中阈值逐步提高,保留的边越来越少,平均聚集系数也随密度变化。几乎所有拓扑指标都随密度变化,组间比较首先不能让密度差异冒充拓扑差异。绝对阈值下,连接整体偏弱的一组网络更稀疏,指标差异可能完全来自密度。比例阈值强制密度相同,却会让连接偏弱的一组纳入更多接近噪声的边。稳妥的做法是在一段预先确定的密度范围内扫描,比如5%到30%,报告整条曲线。阈值方案要在看结果之前确定,只报告显著的那个阈值,是典型的研究者自由度问题。
ER随机图只保留节点数和边数,是最粗的基线。保度随机化反复交换边的端点,让每个节点的度保持不变。脑区连接概率随距离下降,Roberts 等人显示仅靠空间几何就能产生许多拓扑特征。相关矩阵本身有传递性,Zalesky 等人建议用统计特征匹配的随机相关矩阵作参照。经验p值的分子分母都加1,保证它永远不为0,检验在有限次置换下仍然有效。代码示例中,同一个负同配相对ER零模型显著,相对保度零模型却不显著。
置换检验随机打乱组标签,重新计算统计量,前提是标签可以交换。检验数量很大时,可以用 Benjamini 和 Hochberg 的方法控制错误发现率。NBS先用主阈值筛选边,再看它们连成的分量大小,与置换得到的最大分量比较。比较整张症状网络时,网络比较检验要在每次置换中重新估计两个网络。注意NBS的推断单位是子网络,不能据此说其中任意一条边显著。
研究越多的蛋白记录的相互作用越多,疾病基因是枢纽的结论可能部分来自研究热度。在静息态 fMRI 中,毫米级的头动会增强近距离相关、削弱远距离相关。Stumpf 等人指出,无标度网络的随机子网,一般不再属于同一个度分布族。Han 等人按当时的覆盖率采样,四种度分布的网络得到的子网,都与已有图谱难以区分。系统筛选的二元相互作用图谱受研究偏倚较小,可以用来复核结论。
bootstrap要重抽样独立单位,并把正则化和阈值化等整个流程都放进循环。Epskamp 等人的中心性稳定性系数,建议不低于0.25,最好高于0.5。在常用的检验水平和80%功效下,检测相关0.3约需85个样本,0.1约需783个。Marek 等人显示,脑影像与个体表型的关联通常很小,需要数千人才能稳定复现。即使边能被可靠检出,中心性排序需要的样本量往往更大。
小结一下,先弄清边的含义,相关、偏相关和物理连接回答的是不同问题。比较网络时要控制密度,在一段阈值范围内报告结果,而且方案要事先确定。任何指标都要与零模型比较,并写明零模型保留了哪些性质。最后要控制多重比较,报告结果的稳定性,并用模拟估计需要的样本量。建议在代码示例里亲手换几种阈值和零模型,看看结论怎样随之改变。
INTERACTIVE交互可视化
CODE计算实现
11 个完整可运行的 Python 示例,每个都给出代码、输出图和解读;可在浏览器中直接运行,或下载 Jupyter Notebook · Python 脚本。
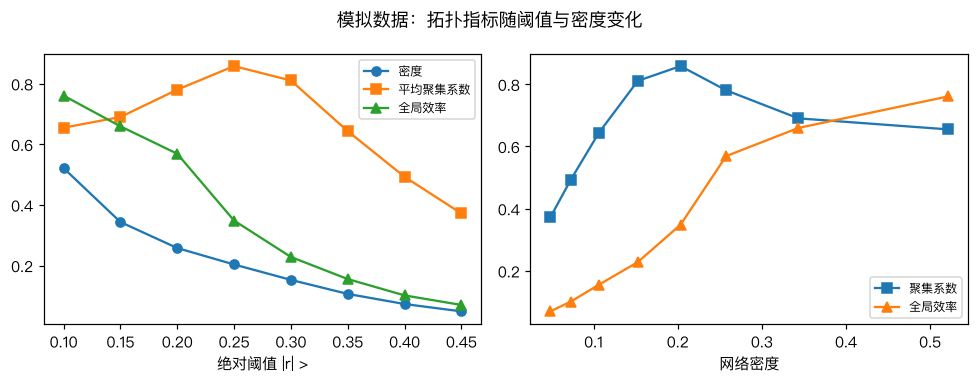 阈值敏感性——同一个相关矩阵,不同绝对阈值下的拓扑指标
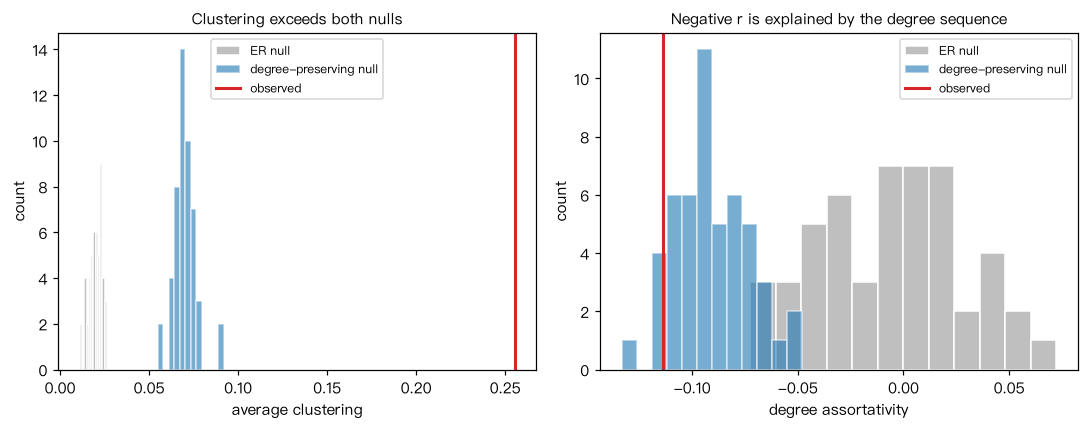 保度随机化(双边交换)零模型、z 分数与经验 p 值
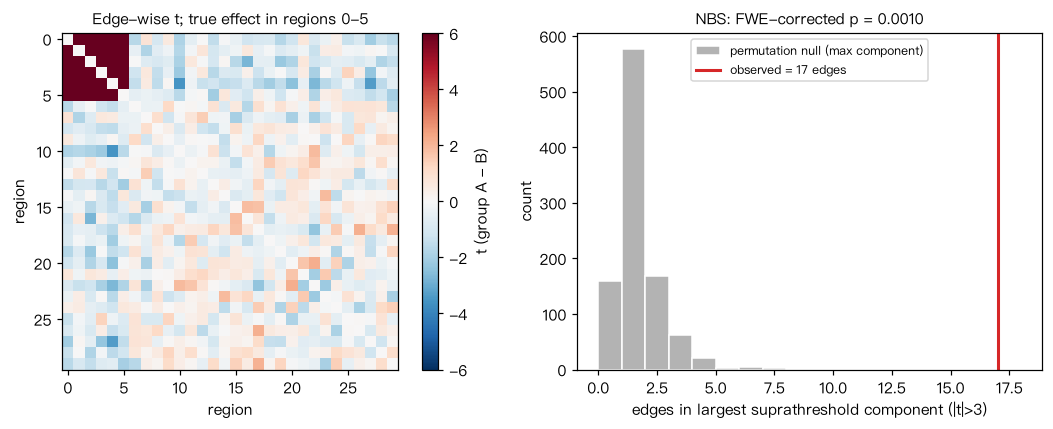 置换检验比较两组网络——逐边 FDR 与基于网络的统计(NBS)
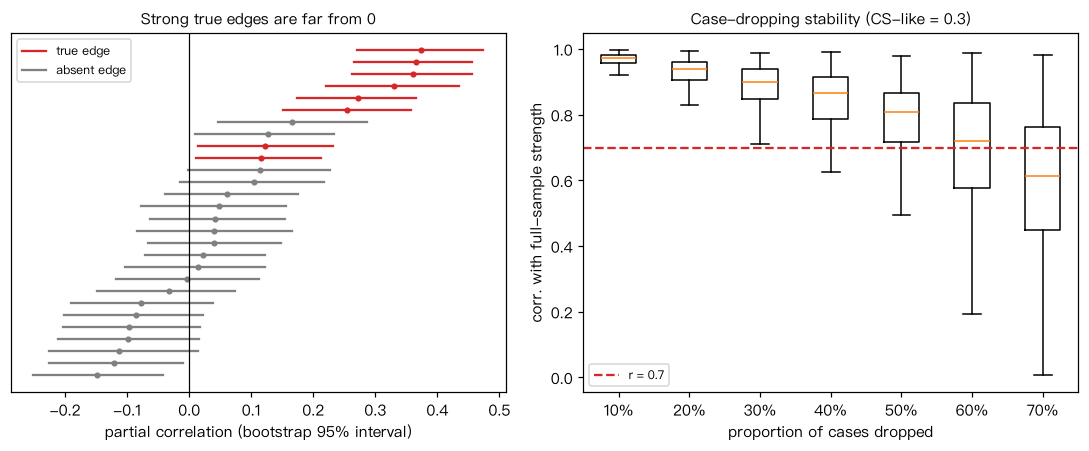 bootstrap 边稳定性与病例删除稳定性(偏相关网络)
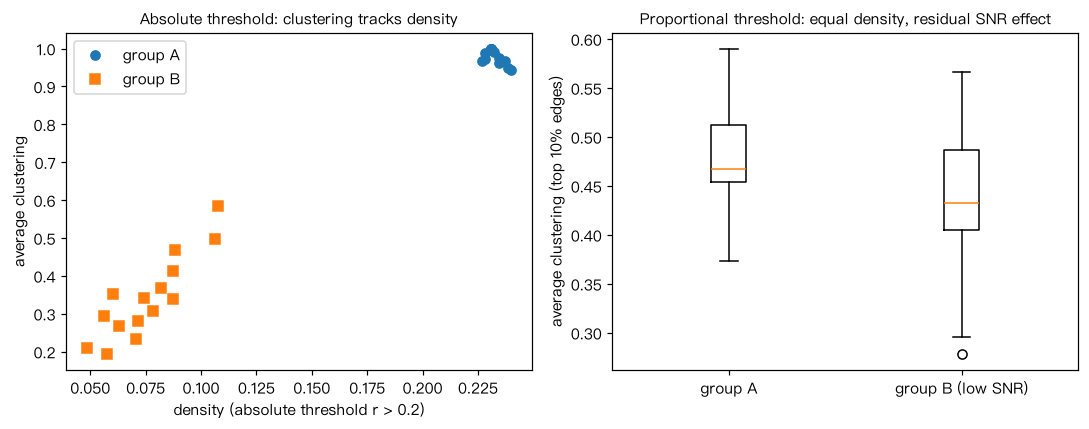 比例阈值与密度匹配——整体连接强度差异如何“制造”拓扑差异
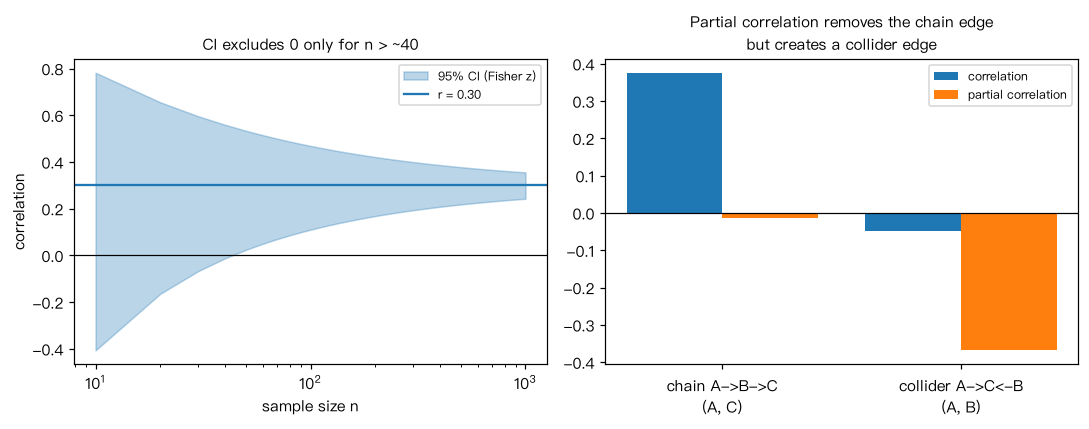 样本量、Fisher z 置信区间,以及相关与偏相关的差别
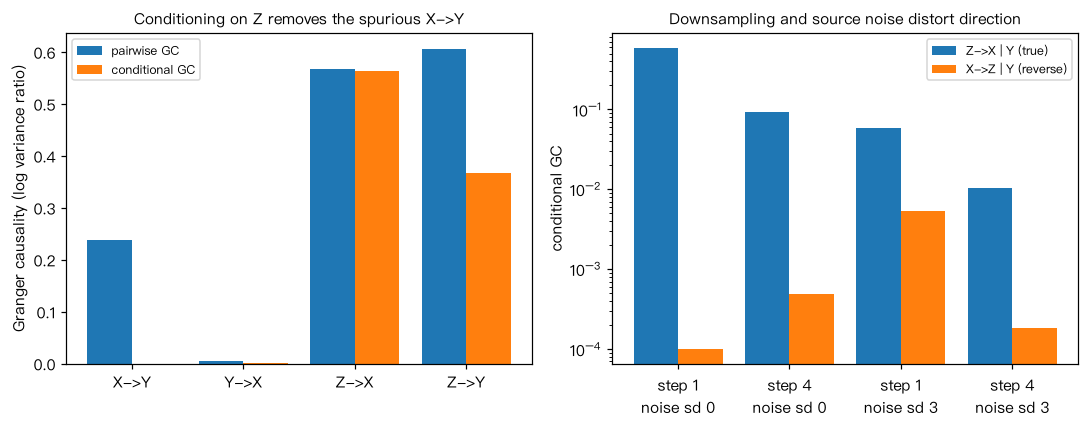 从时间序列推断有向边——Granger 因果、条件 GC 与转移熵(高斯情形)
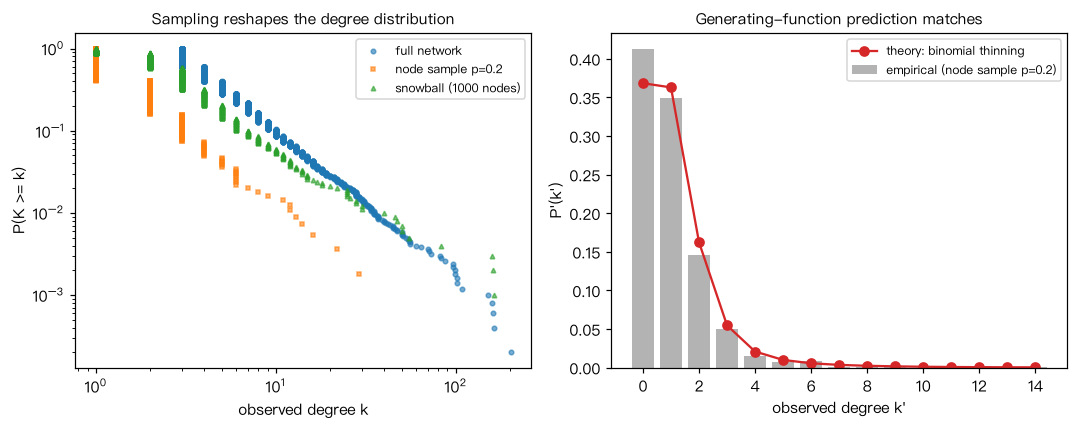 采样网络——随机节点采样、随机边采样与滚雪球采样如何改变度分布与其他指标
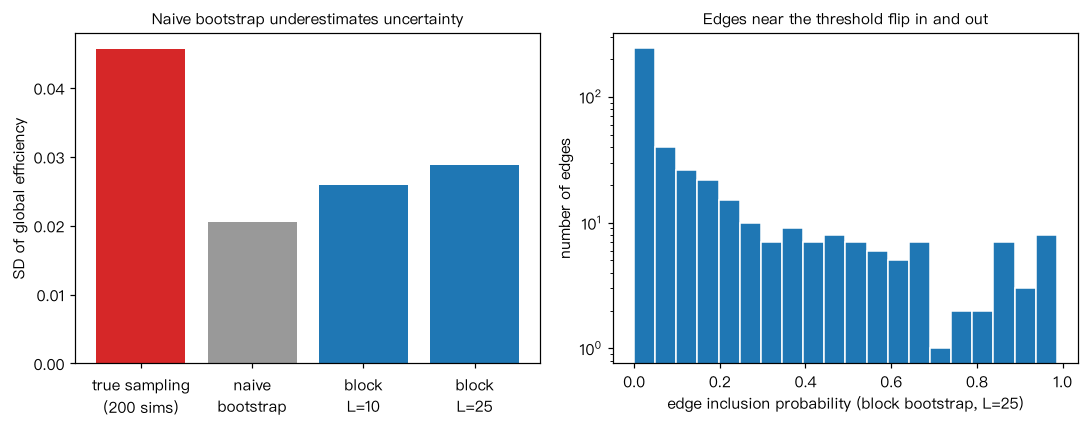 边权不确定性向网络指标的传播——块 bootstrap、边入选概率与“指标的均值 ≠ 均值网络的指标”
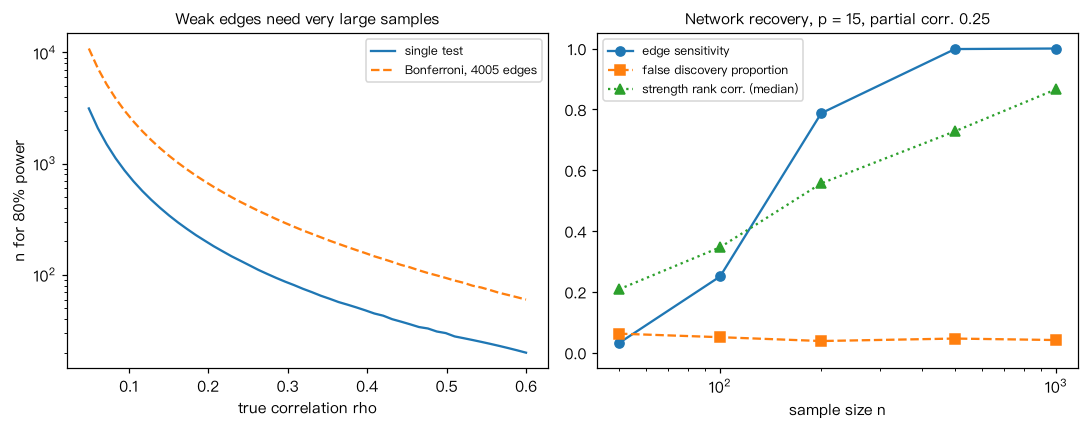 样本量与功效——单条边的解析计算、整网边恢复的模拟,以及测量信度造成的衰减
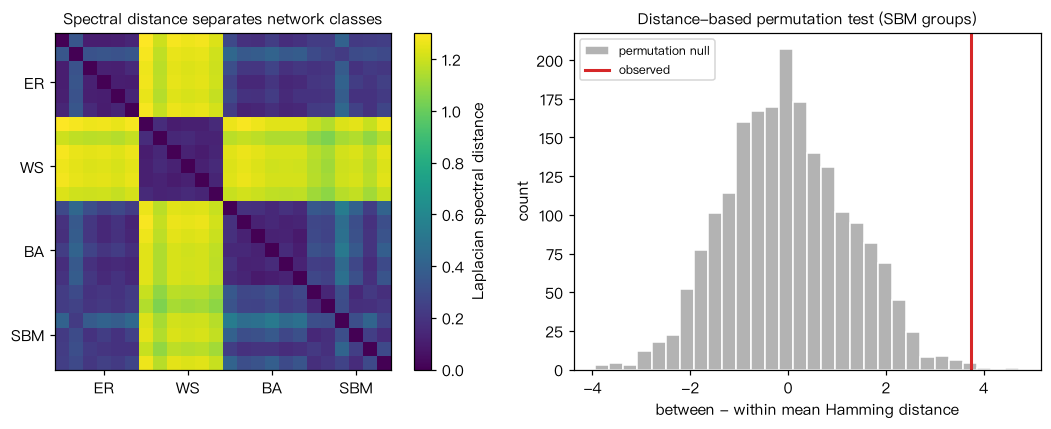 比较两张网络——已知节点对应的距离、谱距离、WL 图核,以及基于距离的置换检验
References核心文献
零模型
- Maslov S, Sneppen K. Specificity and stability in topology of protein networks. Science, 2002, 296: 910–913. DOI: 10.1126/science.1065103
- Molloy M, Reed B. A critical point for random graphs with a given degree sequence. Random Structures & Algorithms, 1995, 6: 161–180. DOI: 10.1002/rsa.3240060204
- Fosdick BK, Larremore DB, Nishimura J, Ugander J. Configuring random graph models with fixed degree sequences. SIAM Review, 2018, 60: 315–355. DOI: 10.1137/16M1087175
- Rubinov M, Sporns O. Weight-conserving characterization of complex functional brain networks. NeuroImage, 2011, 56: 2068–2079. DOI: 10.1016/j.neuroimage.2011.03.069
- Zalesky A, Fornito A, Bullmore E. On the use of correlation as a measure of network connectivity. NeuroImage, 2012, 60: 2096–2106. DOI: 10.1016/j.neuroimage.2012.02.001
- Alexander-Bloch AF, Shou H, Liu S, et al. On testing for spatial correspondence between maps of human brain structure and function. NeuroImage, 2018, 178: 540–551. DOI: 10.1016/j.neuroimage.2018.05.070
- Váša F, Mišić B. Null models in network neuroscience. Nature Reviews Neuroscience, 2022, 23: 493–504. DOI: 10.1038/s41583-022-00601-9
连接估计与阈值
- Fisher RA. Frequency distribution of the values of the correlation coefficient in samples from an indefinitely large population. Biometrika, 1915, 10: 507–521. DOI: 10.2307/2331838
- Ledoit O, Wolf M. A well-conditioned estimator for large-dimensional covariance matrices. Journal of Multivariate Analysis, 2004, 88: 365–411. DOI: 10.1016/S0047-259X(03)00096-4
- Friedman J, Hastie T, Tibshirani R. Sparse inverse covariance estimation with the graphical lasso. Biostatistics, 2008, 9: 432–441. DOI: 10.1093/biostatistics/kxm045
- Smith SM, Miller KL, Salimi-Khorshidi G, et al. Network modelling methods for FMRI. NeuroImage, 2011, 54: 875–891. DOI: 10.1016/j.neuroimage.2010.08.063
- van Wijk BCM, Stam CJ, Daffertshofer A. Comparing brain networks of different size and connectivity density using graph theory. PLoS ONE, 2010, 5: e13701. DOI: 10.1371/journal.pone.0013701
- van den Heuvel MP, de Lange SC, Zalesky A, et al. Proportional thresholding in resting-state fMRI functional connectivity networks and consequences for patient-control connectome studies: issues and recommendations. NeuroImage, 2017, 152: 437–449. DOI: 10.1016/j.neuroimage.2017.02.005
- Tewarie P, van Dellen E, Hillebrand A, Stam CJ. The minimum spanning tree: an unbiased method for brain network analysis. NeuroImage, 2015, 104: 177–188. DOI: 10.1016/j.neuroimage.2014.10.015
统计推断
- Benjamini Y, Hochberg Y. Controlling the false discovery rate: a practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B, 1995, 57: 289–300. DOI: 10.1111/j.2517-6161.1995.tb02031.x
- Nichols TE, Holmes AP. Nonparametric permutation tests for functional neuroimaging: a primer with examples. Human Brain Mapping, 2002, 15: 1–25. DOI: 10.1002/hbm.1058
- Zalesky A, Fornito A, Bullmore ET. Network-based statistic: identifying differences in brain networks. NeuroImage, 2010, 53: 1197–1207. DOI: 10.1016/j.neuroimage.2010.06.041
- Phipson B, Smyth GK. Permutation p-values should never be zero: calculating exact p-values when permutations are randomly drawn. Statistical Applications in Genetics and Molecular Biology, 2010, 9. DOI: 10.2202/1544-6115.1585
- Winkler AM, Ridgway GR, Webster MA, et al. Permutation inference for the general linear model. NeuroImage, 2014, 92: 381–397. DOI: 10.1016/j.neuroimage.2014.01.060
- van Borkulo CD, van Bork R, Boschloo L, et al. Comparing network structures on three aspects: a permutation test. Psychological Methods, 2023, 28: 1273–1285. DOI: 10.1037/met0000476
有向边推断
- Granger CWJ. Investigating causal relations by econometric models and cross-spectral methods. Econometrica, 1969, 37: 424–438. DOI: 10.2307/1912791
- Geweke J. Measurement of linear dependence and feedback between multiple time series. Journal of the American Statistical Association, 1982, 77: 304–313. DOI: 10.1080/01621459.1982.10477803
- Schreiber T. Measuring information transfer. Physical Review Letters, 2000, 85: 461–464. DOI: 10.1103/PhysRevLett.85.461
- Barnett L, Barrett AB, Seth AK. Granger causality and transfer entropy are equivalent for Gaussian variables. Physical Review Letters, 2009, 103: 238701. DOI: 10.1103/PhysRevLett.103.238701
- Friston KJ, Harrison L, Penny W. Dynamic causal modelling. NeuroImage, 2003, 19: 1273–1302. DOI: 10.1016/S1053-8119(03)00202-7
- Friston KJ. Functional and effective connectivity: a review. Brain Connectivity, 2011, 1: 13–36. DOI: 10.1089/brain.2011.0008
- Vicente R, Wibral M, Lindner M, Pipa G. Transfer entropy—a model-free measure of effective connectivity for the neurosciences. Journal of Computational Neuroscience, 2011, 30: 45–67. DOI: 10.1007/s10827-010-0262-3
- Seth AK, Chorley P, Barnett LC. Granger causality analysis of fMRI BOLD signals is invariant to hemodynamic convolution but not downsampling. NeuroImage, 2013, 65: 540–555. DOI: 10.1016/j.neuroimage.2012.09.049
- Seth AK, Barrett AB, Barnett L. Granger causality analysis in neuroscience and neuroimaging. Journal of Neuroscience, 2015, 35: 3293–3297. DOI: 10.1523/JNEUROSCI.4399-14.2015
采样、测量误差与网络重建
- Stumpf MPH, Wiuf C, May RM. Subnets of scale-free networks are not scale-free: sampling properties of networks. PNAS, 2005, 102: 4221–4224. DOI: 10.1073/pnas.0501179102
- Han JDJ, Dupuy D, Bertin N, et al. Effect of sampling on topology predictions of protein-protein interaction networks. Nature Biotechnology, 2005, 23: 839–844. DOI: 10.1038/nbt1116
- Lee SH, Kim PJ, Jeong H. Statistical properties of sampled networks. Physical Review E, 2006, 73: 016102. DOI: 10.1103/PhysRevE.73.016102
- Kossinets G. Effects of missing data in social networks. Social Networks, 2006, 28: 247–268. DOI: 10.1016/j.socnet.2005.07.002
- Stumpf MPH, Thorne T, de Silva E, et al. Estimating the size of the human interactome. PNAS, 2008, 105: 6959–6964. DOI: 10.1073/pnas.0708078105
- Newman MEJ. Network structure from rich but noisy data. Nature Physics, 2018, 14: 542–545. DOI: 10.1038/s41567-018-0076-1
- Peixoto TP. Reconstructing networks with unknown and heterogeneous errors. Physical Review X, 2018, 8: 041011. DOI: 10.1103/PhysRevX.8.041011
- Peixoto TP. Network reconstruction and community detection from dynamics. Physical Review Letters, 2019, 123: 128301. DOI: 10.1103/PhysRevLett.123.128301
网络比较
- Tantardini M, Ieva F, Tajoli L, Piccardi C. Comparing methods for comparing networks. Scientific Reports, 2019, 9: 17557. DOI: 10.1038/s41598-019-53708-y
- Wilson RC, Zhu P. A study of graph spectra for comparing graphs and trees. Pattern Recognition, 2008, 41: 2833–2841. DOI: 10.1016/j.patcog.2008.03.011
- Pržulj N. Biological network comparison using graphlet degree distribution. Bioinformatics, 2007, 23: e177–e183. DOI: 10.1093/bioinformatics/btl301
- Yaveroğlu ÖN, Malod-Dognin N, Davis D, et al. Revealing the hidden language of complex networks. Scientific Reports, 2014, 4: 4547. DOI: 10.1038/srep04547
- Koutra D, Shah N, Vogelstein JT, Gallagher B, Faloutsos C. DeltaCon: principled massive-graph similarity function with attribution. ACM Transactions on Knowledge Discovery from Data, 2016, 10: 1–43. DOI: 10.1145/2824443
- Kriege NM, Johansson FD, Morris C. A survey on graph kernels. Applied Network Science, 2020, 5: 6. DOI: 10.1007/s41109-019-0195-3
- Bagrow JP, Bollt EM. An information-theoretic, all-scales approach to comparing networks. Applied Network Science, 2019, 4: 45. DOI: 10.1007/s41109-019-0156-x
- Hartle H, Klein B, McCabe S, et al. Network comparison and the within-ensemble graph distance. Proceedings of the Royal Society A, 2020, 476: 20190744. DOI: 10.1098/rspa.2019.0744
样本量、信度与前沿
- Spearman C. The proof and measurement of association between two things. American Journal of Psychology, 1904, 15: 72–101. DOI: 10.2307/1412159
- Epskamp S, Fried EI. A tutorial on regularized partial correlation networks. Psychological Methods, 2018, 23: 617–634. DOI: 10.1037/met0000167
- Constantin MA, Schuurman NK, Vermunt JK. A general Monte Carlo method for sample size analysis in the context of network models. Psychological Methods, 2026, 31: 385–405. DOI: 10.1037/met0000555
- Birn RM, Molloy EK, Patriat R, et al. The effect of scan length on the reliability of resting-state fMRI connectivity estimates. NeuroImage, 2013, 83: 550–558. DOI: 10.1016/j.neuroimage.2013.05.099
- Battiston F, Cencetti G, Iacopini I, et al. Networks beyond pairwise interactions: structure and dynamics. Physics Reports, 2020, 874: 1–92. DOI: 10.1016/j.physrep.2020.05.004
- Dixit A, Parnas O, Li B, et al. Perturb-Seq: dissecting molecular circuits with scalable single-cell RNA profiling of pooled genetic screens. Cell, 2016, 167: 1853–1866. DOI: 10.1016/j.cell.2016.11.038
偏倚、稳定性与综述
- Gillis J, Pavlidis P. The impact of multifunctional genes on “guilt by association” analysis. PLoS ONE, 2011, 6: e17258. DOI: 10.1371/journal.pone.0017258
- Gillis J, Pavlidis P. “Guilt by association” is the exception rather than the rule in gene networks. PLoS Computational Biology, 2012, 8: e1002444. DOI: 10.1371/journal.pcbi.1002444
- Luck K, Kim DK, Lambourne L, et al. A reference map of the human binary protein interactome. Nature, 2020, 580: 402–408. DOI: 10.1038/s41586-020-2188-x
- Power JD, Barnes KA, Snyder AZ, et al. Spurious but systematic correlations in functional connectivity MRI networks arise from subject motion. NeuroImage, 2012, 59: 2142–2154. DOI: 10.1016/j.neuroimage.2011.10.018
- Efron B. Bootstrap methods: another look at the jackknife. Annals of Statistics, 1979, 7: 1–26. DOI: 10.1214/aos/1176344552
- Epskamp S, Borsboom D, Fried EI. Estimating psychological networks and their accuracy: a tutorial paper. Behavior Research Methods, 2018, 50: 195–212. DOI: 10.3758/s13428-017-0862-1
- Noble S, Scheinost D, Constable RT. A decade of test-retest reliability of functional connectivity: a systematic review and meta-analysis. NeuroImage, 2019, 203: 116157. DOI: 10.1016/j.neuroimage.2019.116157
- Fornito A, Zalesky A, Breakspear M. Graph analysis of the human connectome: promise, progress, and pitfalls. NeuroImage, 2013, 80: 426–444. DOI: 10.1016/j.neuroimage.2013.04.087
Data & tools相关数据与软件
Further延伸资源
| 类型 | 资源 | 说明 |
|---|---|---|
| 综述 | Váša & Mišić 2022,doi.org/10.1038/s41583-022-00601-9 | 网络神经科学中零模型的分类与选择,适合作为零模型部分的总纲 |
| 综述 | Fornito, Zalesky & Breakspear 2013,doi.org/10.1016/j.neuroimage.2013.04.087 | 脑网络构建全流程的陷阱,节点、边、阈值、组间比较逐一讨论 |
| 方法 | Fosdick 等 2018,doi.org/10.1137/16M1087175 | 配置模型与双边交换抽样的严格讨论,适合需要自己实现零模型时阅读 |
| 教程 | Epskamp, Borsboom & Fried 2018,doi.org/10.3758/s13428-017-0862-1 | 边权 bootstrap、病例删除与 CS 系数的完整示范(开放获取) |
| 工具 | Brain Connectivity Toolbox(MATLAB)/ bctpy(Python) | 网络指标与多种零模型(含加权、带符号版本)的实现 |
| 工具 | netneurotools | Python 工具包,包含空间置换检验等零模型 |
| 工具 | R 包 bootnet | 心理网络的估计、bootstrap 与稳定性分析 |
| 教材 | Barabási, Network Science, Ch. 4 The Scale-Free Property(4.8 节:生成任意度分布的网络,含配置模型与保度随机化),networksciencebook.com/chapter/4 | 配置模型、完全随机化与保度随机化的图示讲解(CC BY-NC-SA 2.0);Ch. 3 Random Networks 给出 ER 零模型的基本性质 |
| 教材 | Fornito A, Zalesky A, Bullmore ET. Fundamentals of Brain Network Analysis. Academic Press, 2016 | 脑网络中节点与边的定义、连接矩阵、零模型与统计连接组学的系统讲解 |
| 教材 | Newman MEJ. Networks(第 2 版). Oxford University Press, 2018 | 网络统计量与测量误差的章节讨论误差类型、来源、估计与校正 |
| 综述 | Seth, Barrett & Barnett 2015,doi.org/10.1523/JNEUROSCI.4399-14.2015 | Granger 因果在神经科学中的使用条件与常见误解,篇幅短,适合入门 |
| 方法 | Tantardini 等 2019,doi.org/10.1038/s41598-019-53708-y | 网络比较方法的分类(节点是否对应)与在合成网络上的系统比较 |
| 工具 | netrd(Python) | 实现了数十种图距离与从时间序列重建网络的方法,可用于比较不同距离的行为 |
| 工具 | graph-tool(Python) | 包含 Peixoto 的贝叶斯网络重建与随机块模型推断 |
| 数据 | BioGRID / STRING | 两类不同性质的相互作用数据库:前者为整理的实验证据,后者为整合的功能关联得分;可用来比较构网选择对结论的影响 |
Open questions开放问题
- 在你的数据中,“边”属于物理连接、统计关联、功能关联还是有向关系?如果要把它换成另一类边(例如从功能连接换成结构连接,或从文献整理的相互作用换成系统筛选数据),你预期哪些结论会改变?
- 对同一个网络指标,ER、保度随机化和空间约束零模型可能给出相互矛盾的结论。你会怎样预先规定零模型,并在结果不一致时如何解读?
- 当样本量只够估计一个稀疏的正则化网络时,“这条边不存在”的证据强度有多大?有没有办法区分“条件独立”与“功效不足”?
- 研究偏倚、头动和批次效应都是与生物学变量相关的系统误差。在你熟悉的数据类型中,哪一种系统误差最可能被误读为生物学发现?可以设计什么样的阴性对照来检验?
- 你的网络只观测了真实系统的一部分(部分基因、部分脑区、部分条目)。若采样比例减半,你的主要结论会如何变化?能否用进一步删除节点或边的模拟来回答?
- 若要声称“A 脑区驱动 B 脑区”,你的数据的采样间隔、测量噪声与可能遗漏的脑区是否允许这一结论?有哪些干预或对照分析可以加强它?