Example04 / 11
bootstrap 边稳定性与病例删除稳定性(偏相关网络)
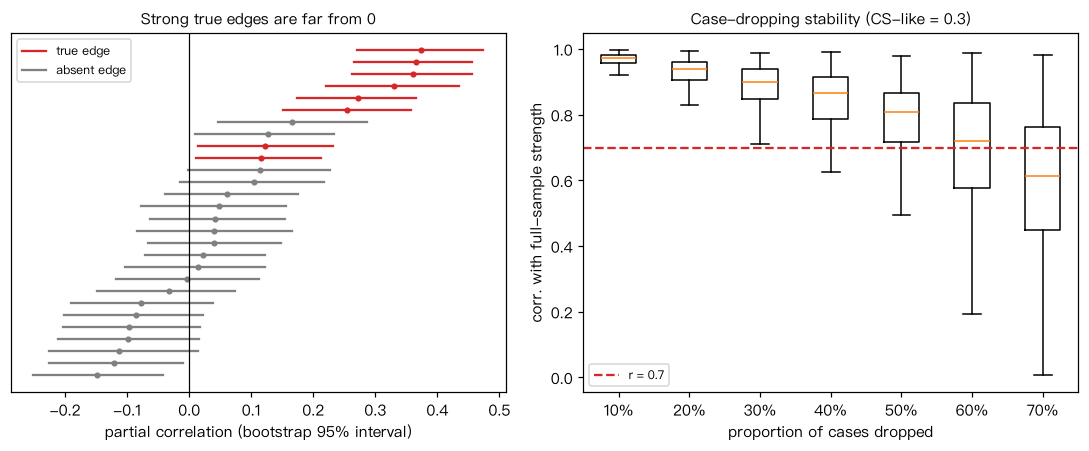
由一个已知的稀疏精度矩阵生成 n=300 名被试、p=8 个条目的模拟量表数据,估计偏相关网络。 (1) 非参数 bootstrap:有放回重抽样被试 1000 次,得到每条边的 95% 分位数区间和“|偏相关|>0.1 的比例”; (2) 病例删除:无放回地删去 10%–70% 的被试,看强度中心性与全样本的相关,计算类似 CS 系数的指标。 解读:真实的强边区间远离 0;多数不存在的边区间包含 0,但同时考察几十条边时,总会有个别假边的 区间不含 0,弱的真实边也可能与假边难以区分——逐边区间不是多重比较校正。这里为了自包含用了未正则化的偏相关, 实际症状网络常用 EBICglasso,此时 bootstrap 区间会因收缩而偏向 0,只宜用于判断边的可区分性。
Output输出图
Output文字输出
边      估计     95%区间            |w|>0.1比例  真实存在
0-1   +0.374  [+0.270, +0.474]   1.00        True
5-6   +0.366  [+0.265, +0.456]   1.00        True
4-5   +0.361  [+0.263, +0.456]   1.00        True
2-3   +0.330  [+0.221, +0.435]   1.00        True
1-2   +0.272  [+0.175, +0.366]   1.00        True
6-7   +0.254  [+0.151, +0.358]   1.00        True
2-4   +0.166  [+0.046, +0.287]   0.85        False
1-4   -0.149  [-0.251, -0.041]   0.81        False
2-7   +0.127  [+0.009, +0.233]   0.69        False
3-4   +0.122  [+0.014, +0.231]   0.64        True
0-7   -0.121  [-0.225, -0.009]   0.62        False
0-4   +0.115  [+0.011, +0.213]   0.59        True
区间不含 0:真实边 8/8 条,不存在的边 4/20 条
删去 10% 被试:强度与全样本相关的中位数=0.97,r>=0.7 的比例=1.00
删去 20% 被试:强度与全样本相关的中位数=0.94,r>=0.7 的比例=1.00
删去 30% 被试:强度与全样本相关的中位数=0.90,r>=0.7 的比例=0.97
删去 40% 被试:强度与全样本相关的中位数=0.87,r>=0.7 的比例=0.89
删去 50% 被试:强度与全样本相关的中位数=0.81,r>=0.7 的比例=0.78
删去 60% 被试:强度与全样本相关的中位数=0.72,r>=0.7 的比例=0.55
删去 70% 被试:强度与全样本相关的中位数=0.61,r>=0.7 的比例=0.35
类 CS 系数(95% 的子样本中 r>=0.7 时可删去的最大比例)= 0.3
Code代码
# 由一个已知的稀疏精度矩阵生成 n=300 名被试、p=8 个条目的模拟量表数据,估计偏相关网络。
# (1) 非参数 bootstrap:有放回重抽样被试 1000 次,得到每条边的 95% 分位数区间和“|偏相关|>0.1 的比例”;
# (2) 病例删除:无放回地删去 10%–70% 的被试,看强度中心性与全样本的相关,计算类似 CS 系数的指标。
# 解读:真实的强边区间远离 0;多数不存在的边区间包含 0,但同时考察几十条边时,总会有个别假边的
# 区间不含 0,弱的真实边也可能与假边难以区分——逐边区间不是多重比较校正。这里为了自包含用了未正则化的偏相关,
# 实际症状网络常用 EBICglasso,此时 bootstrap 区间会因收缩而偏向 0,只宜用于判断边的可区分性。
import numpy as np

rng = np.random.default_rng(4)
p, n = 8, 300
K = np.eye(p)
true_edges = [(0, 1, 0.35), (1, 2, 0.3), (2, 3, 0.3), (3, 4, 0.25), (4, 5, 0.3), (5, 6, 0.25), (6, 7, 0.3), (0, 4, 0.2)]
for i, j, w in true_edges:
    K[i, j] = K[j, i] = -w                       # 精度矩阵负元素对应正偏相关
Sigma = np.linalg.inv(K)
X = rng.multivariate_normal(np.zeros(p), Sigma, size=n)

def pcor(X):
    P = np.linalg.inv(np.corrcoef(X, rowvar=False))
    d = np.sqrt(np.diag(P))
    W = -P / np.outer(d, d)
    np.fill_diagonal(W, 0)
    return W

iu = np.triu_indices(p, 1)
W0 = pcor(X)
B = 1000
boot = np.empty((B, len(iu[0])))
for b in range(B):
    boot[b] = pcor(X[rng.integers(n, size=n)])[iu]
lo, hi = np.percentile(boot, [2.5, 97.5], axis=0)
inc = (np.abs(boot) > 0.1).mean(axis=0)
is_true = np.zeros((p, p), bool)
for i, j, _ in true_edges:
    is_true[i, j] = is_true[j, i] = True
print("边      估计     95%区间            |w|>0.1比例  真实存在")
for k in np.argsort(-np.abs(W0[iu]))[:12]:
    i, j = iu[0][k], iu[1][k]
    print(f"{i}-{j}   {W0[i, j]:+.3f}  [{lo[k]:+.3f}, {hi[k]:+.3f}]   {inc[k]:.2f}        {is_true[i, j]}")
excl0 = (lo > 0) | (hi < 0)
t_vec = is_true[iu]
print(f"区间不含 0:真实边 {excl0[t_vec].sum()}/{t_vec.sum()} 条,不存在的边 {excl0[~t_vec].sum()}/{(~t_vec).sum()} 条")

# 病例删除稳定性:强度中心性
s0 = np.abs(W0).sum(axis=1)
props = [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7]
cs = 0.0
r_drop = []                                   # 保存每个删除比例下的相关,用于作图
for prop in props:
    keep = int(round((1 - prop) * n))
    r = np.array([np.corrcoef(np.abs(pcor(X[rng.choice(n, keep, replace=False)])).sum(axis=1), s0)[0, 1]
                  for _ in range(300)])
    r_drop.append(r)
    frac = (r >= 0.7).mean()
    print(f"删去 {prop:.0%} 被试:强度与全样本相关的中位数={np.median(r):.2f},r>=0.7 的比例={frac:.2f}")
    if frac >= 0.95:
        cs = prop
print(f"类 CS 系数(95% 的子样本中 r>=0.7 时可删去的最大比例)= {cs:.1f}")

# 作图:全部边的 bootstrap 95% 区间(按估计值排序,真实边与不存在的边分色);病例删除稳定性曲线
import matplotlib.pyplot as plt
fig, ax = plt.subplots(1, 2, figsize=(10, 4.2))
o = np.argsort(W0[iu])
for j, k in enumerate(o):
    c = "C3" if t_vec[k] else "0.5"
    ax[0].plot([lo[k], hi[k]], [j, j], color=c, lw=1.5); ax[0].plot(W0[iu][k], j, "o", color=c, ms=3)
ax[0].axvline(0, color="k", lw=0.8)
ax[0].plot([], [], color="C3", label="true edge"); ax[0].plot([], [], color="0.5", label="absent edge")
ax[0].set_xlabel("partial correlation (bootstrap 95% interval)"); ax[0].set_yticks([]); ax[0].legend(fontsize=8)
ax[0].set_title("Strong true edges are far from 0", fontsize=10)
ax[1].boxplot(r_drop, showfliers=False); ax[1].set_xticklabels([f"{p_:.0%}" for p_ in props])
ax[1].axhline(0.7, color="C3", ls="--", label="r = 0.7")
ax[1].set_xlabel("proportion of cases dropped"); ax[1].set_ylabel("corr. with full-sample strength")
ax[1].set_title(f"Case-dropping stability (CS-like = {cs:.1f})", fontsize=10); ax[1].legend(fontsize=8)
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。