网络分析流程与 NetworkX 实践
从提出问题、读入与清洗数据、选择工具,到指标计算、零模型比较、可视化与报告,用 NetworkX 完成一次完整的网络分析
网络科学的概念(度、聚集系数、路径长度、社团、中心性)只有落到具体数据上才能检验其价值。本专题处理的是从理论到数据的“最后一公里”:怎样把一个生物医学问题转化为节点与边的定义,怎样选择计算工具,怎样把各种来源的数据正确读入并在不同格式之间转换,怎样计算指标、发现社团、与模型网络和零模型比较,网络大到普通方法算不动时怎么办,怎样画出能回答问题的网络图,以及有哪些看似细小却会悄悄改变结果的计算陷阱。
这里的方法是其他专题的共同基础。指标的定义见网络结构指标与随机图,小世界与无标度的判别见小世界与无标度网络模型,模块度与社团检测算法见社团结构与社区发现;从原始测量构建网络、阈值选择、零模型与统计验证的系统讨论见网络构建与统计验证。把分析做得可复算、并检验结论对分析选择是否稳健,见研究问题、可复现分析与敏感性分析;结果的图表呈现与报告结构见结果呈现与研究前沿。
本专题以 Python 的 NetworkX 为主要工具,同时比较 igraph、graph-tool、Brain Connectivity Toolbox(BCT)、Cytoscape 与 Gephi 的定位,并给出一个从模拟表达矩阵出发、经过质控、建网、模块识别、枢纽筛选、零模型检验到敏感性分析的完整案例。最后整理了生物医学研究中常见的公开网络数据来源与分析方向。所有计算都有对应的可运行代码示例。
Contents知识页面
VIDEO讲解视频
文字稿
大家好,这一期我们讨论从理论到数据的最后一公里,一项网络分析该怎样做。度、聚集系数、社团和中心性,只有落到具体数据上,才能检验它们的价值。我们以 Python 的 NetworkX 为主要工具,但这些原则对任何软件都适用。
这是整本手册的知识地图,网络分析流程属于计算方法领域。它是其他专题的共同基础,指标、模型和社团检测都要在这里落到数据上。从测量构建网络、阈值和零模型的系统讨论,见网络构建与统计验证专题。
第一步提出问题,比如阿尔茨海默病相关蛋白在相互作用网络中是否聚成模块。第二步获取并清洗数据,统一标识符,比如基因名与 UniProt 编号的映射。第三步构建网络,规定节点是什么、边是什么,有无方向和权重,阈值怎么定。第四步计算度分布、聚集系数、路径长度和中心性,并从生物学角度解读。第五步做社团划分等算法分析,并与零模型比较,判断性质是否非随机。第六步结合文献解释结果,讨论局限,每一步的选择都要记录下来。一条通用原则是从问题出发,用 STRING 做一个网络,本身还不是研究问题。
NetworkX 是纯 Python 库,接口友好,适合中小规模网络和方法原型。igraph 和 graph-tool 的核心用编译型语言实现,常见算法快得多,适合更大的网络。脑网络常用 BCT,参与系数等指标以它的定义最常被引用。Cytoscape 是生物分子网络的标准平台,Gephi 适合交互式布局和出版级作图。不同软件的同名指标未必相同,报告时要写出软件名、版本和函数名。
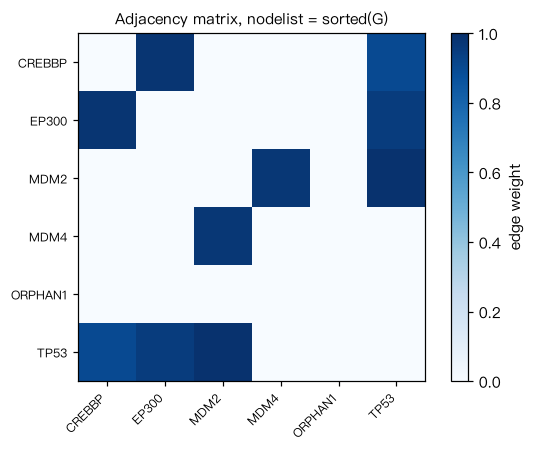
开始计算之前,先把数据读成图,最常见的形式是边列表和邻接矩阵。画面中每读入一条边,矩阵里对称的两个位置同时记为1。生物网络大多稀疏,2万节点的网络,稠密矩阵约需3200兆,稀疏格式只要约2兆。一个好习惯是先看数据,再算指标。先打印节点数、边数、自环数和连通分支,再抽查几条具体的边。边全部读完后,每一行的和就是节点的度,显示在矩阵右边。
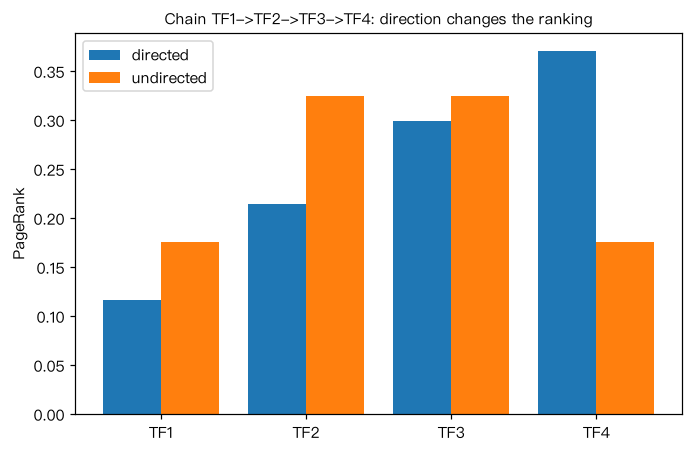
自环会让节点的度加2,示例小图中节点3的度从3变成了5。把多重图直接转成简单图时,重边只保留其中一条的属性,而不是自动求和。孤立点会拉低平均度和密度,示例中平均度从1.6降到1.0,平均最短路径直接报错。把调控链无向化之后,PageRank 从沿方向递增变成了首尾对称。最隐蔽的是权重,最短路径和介数把权重当距离,而相关系数和置信度是相似度。示例中直接用相关系数作权重,中间节点的介数是0,转换成距离后变为1。
常用的转换有两种,第一种取倒数,脑网络中常用。第二种取负对数,路径长度就对应沿途相似度的乘积。当权重可以解释为置信概率时,负对数变换更自然。模块度、强度和加权聚集系数则把权重当强度,不需要转换。最好在图里分别存储两个属性,每次调用函数时显式指定用哪一个。
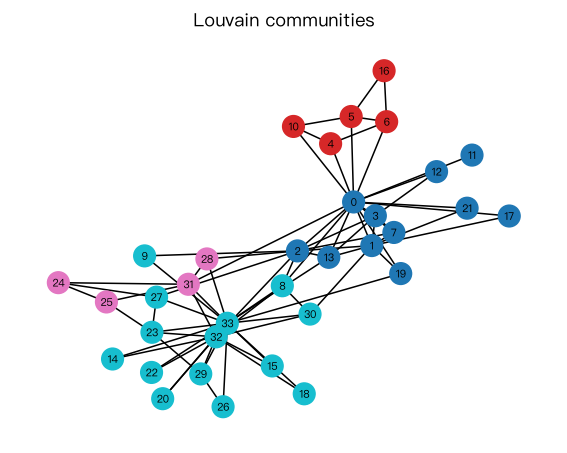
算出指标之后,常常要划分社团,这里用空手道俱乐部网络演示。红色的边是当前边介数最大的边,也就是社团之间的桥,把它删掉。随着桥一条条删去,网络分裂成几个社团,右边记录模块度的变化。但随机网络也能得到不小的模块度,所以必须与零模型比较。这种方法要反复计算边介数,只适合小网络,大网络常用 Louvain 或 Leiden。Louvain 有随机性,不能只跑一次,要报告多次运行的稳定性。
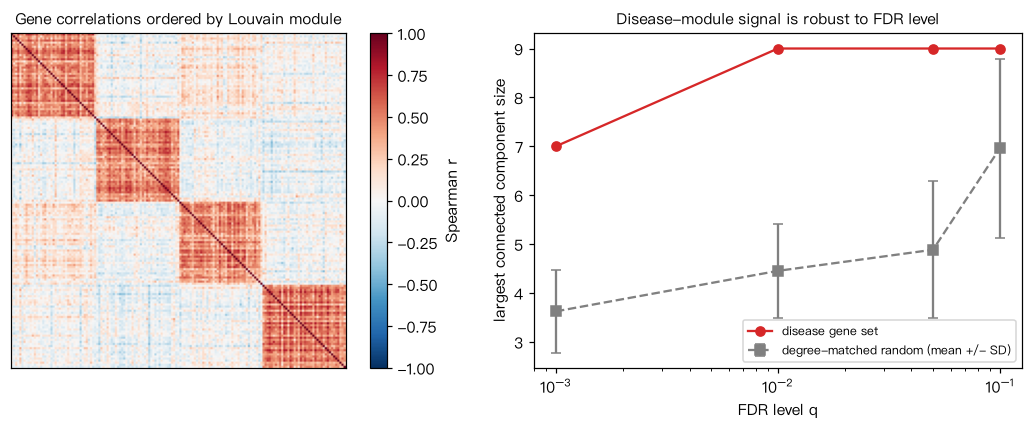
我们用一个模拟的共表达数据集,200个基因、60个样本,先去除方差极低的基因。计算 Spearman 相关,用 FDR 控制在0.01,只保留正相关,得到2031条边。Louvain 找到4个模块,模块度约0.75,与植入的模块几乎完全一致。与度匹配的随机基因集比较,疾病基因的内部边数是24,随机期望约10,z约5.1。换 FDR 重建后,内部边数都显著,最大连通分支在 FDR 为0.1时不再显著。原因是网络变稠密后,随机基因集也很容易连成大分支,统计量趋于饱和。所以主要统计量要预先指定,并报告全部敏感性分析的结果。
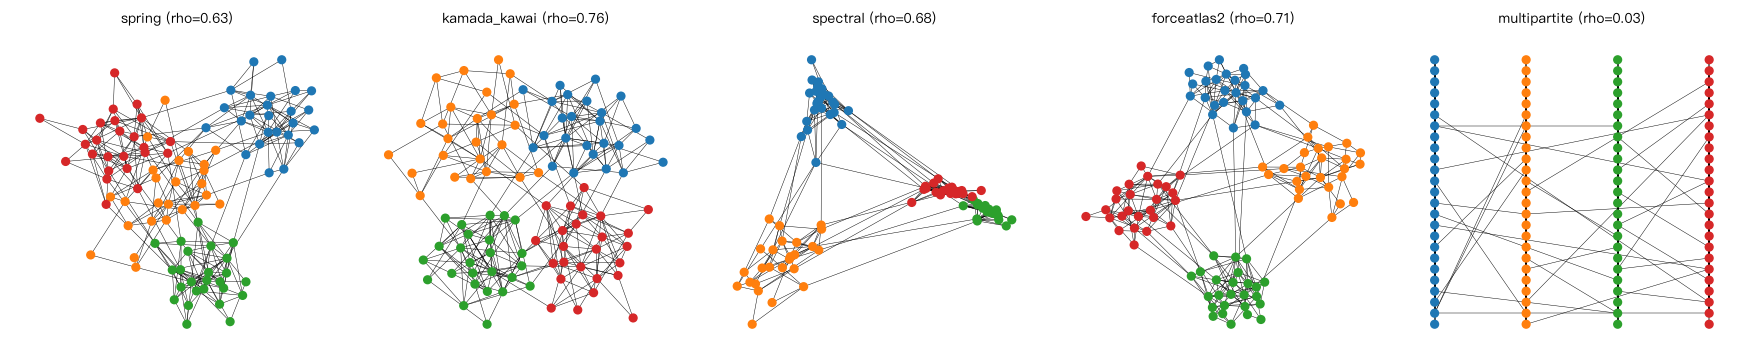
力导向布局把边当弹簧,簇之间的远近与相对位置往往没有可解释的含义。谱布局用拉普拉斯矩阵的特征向量作坐标,不依赖随机种子,对社团敏感。节点大小要让面积而不是半径与数值成正比,否则枢纽会被视觉放大。布局要固定随机种子并保存坐标,图上看到的簇是否存在,要靠统计量判断。
小结一下,从具体问题出发,而不是从数据库出发。数据版本、标识符映射、阈值、软件版本和随机种子,每一步都要记录。计算前先看数据,留意自环、重边、孤立点、方向和权重含义这些默认行为。结论要与零模型比较,并在合理的分析选择下保持稳健。建议打开代码示例,把完整案例从头跑一遍,再换一个阈值看看结果。
INTERACTIVE交互可视化
CODE计算实现
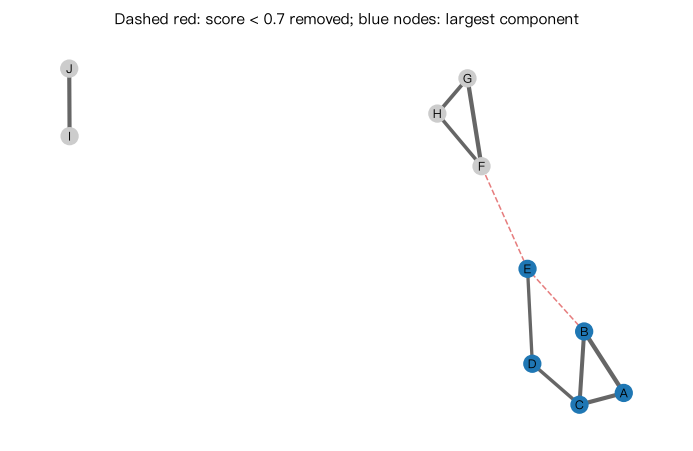
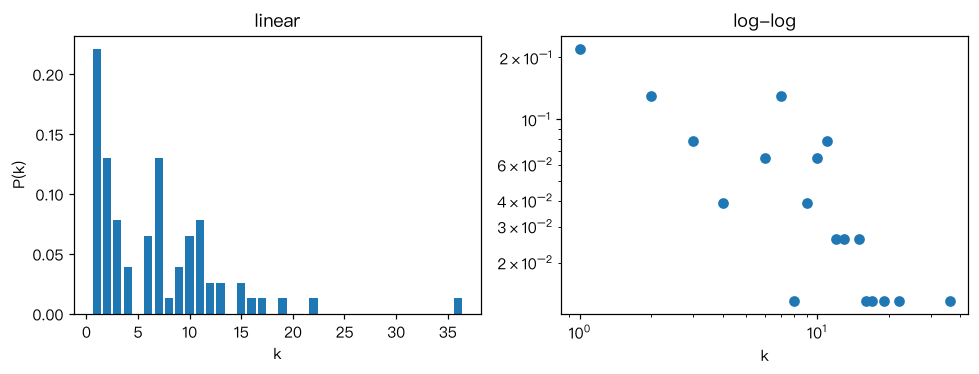
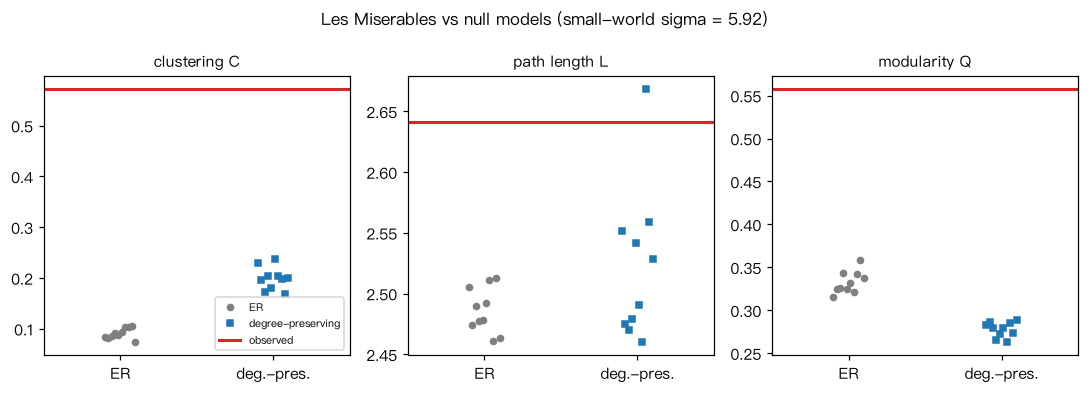
9 个完整可运行的 Python 示例,每个都给出代码、输出图和解读;可在浏览器中直接运行,或下载 Jupyter Notebook · Python 脚本。
Papers论文精读
社会网络与生物网络中的社团结构
Community structure in social and biological networks
Girvan M, Newman MEJ
提出按边介数反复删边的分裂式社团发现算法,在人工网络、空手道俱乐部和食物网等数据上找到了有意义的社团。
网络基序:复杂网络的简单构件
Network motifs: simple building blocks of complex networks
Milo R, Shen-Orr S, Itzkovitz S, Kashtan N, Chklovskii D, Alon U
把“在真实网络中出现次数显著多于随机网络的小子图”定义为网络基序,发现不同领域的网络各有特征性基序。
酵母蛋白质相互作用网络中动态组织的模块性证据
Evidence for dynamically organized modularity in the yeast protein–protein interaction network
Han J-DJ, Bertin N, Hao T, Goldberg DS, Berriz GF, Zhang LV, et al.
结合共表达把酵母互作组枢纽分为 party hub 与 date hub,提出动态组织的模块性。
经验数据中的幂律分布
Power-law distributions in empirical data
Clauset A, Shalizi CR, Newman MEJ
提出最大似然拟合、KS 选下界、自助法检验与似然比比较的幂律分析流程,并重新检验了 24 个数据集。
脑连接的复杂网络指标:用法与解读
Complex network measures of brain connectivity: uses and interpretations
Rubinov M, Sporns O
按神经科学含义整理脑网络常用图论指标及其解读,并发布 Brain Connectivity Toolbox。
References核心文献
Hagberg、Schult 与 Swart 2008:Exploring network structure, dynamics, and function using NetworkX
- 背景:NetworkX 的原始介绍论文,发表于 SciPy 2008 会议论文集,说明了库的设计理念:用 Python 字典表示图,节点可以是任意可哈希对象,边可以携带任意属性。
- 核心内容:数据结构、算法覆盖、与 NumPy/SciPy 的衔接,以及在流行病学等领域的使用示例。
- 阅读提示:论文很短,重点理解“图就是字典的字典”这一数据结构,它解释了为什么 NetworkX 灵活但在大规模网络上较慢。在研究中使用 NetworkX 时,应引用这篇论文。
- 思考题:你所分析的网络有多少节点和边?NetworkX 在哪一步可能成为瓶颈?有什么替代方案?
Barabási、Gulbahce 与 Loscalzo 2011:Network medicine: a network-based approach to human disease(Nature Reviews Genetics)
- 背景:疾病很少由单一基因决定,网络医学试图在分子相互作用网络中理解疾病。
- 核心内容:人类相互作用组的构成与不完整性;疾病模块假说;网络中的疾病基因发现、疾病之间的关系与药物作用;网络方法的局限。
- 阅读提示:可以把这篇综述当作确定研究方向的“地图”——常见生物医学网络数据与分析方向中的方向 2、3、4、8、9 都可以在其中找到对应的问题框架。注意文中关于数据不完整和研究偏倚的讨论。论文精读见 Barabási 2011。
- 思考题:在你关注的方向中,“疾病模块”可以如何定义和检验?需要什么样的零模型?
DOI:10.1038/nrg2918
Christakis 与 Fowler 2007 及其批评(另见网络上的传播与免疫)
- 为什么放在这里:这是“网络分析得出强结论、随后受到方法学批评”的典型案例,对设计自己的网络分析很有启发。
- 阅读提示:对照阅读原文的方法部分与批评文章,列出自己的分析可能面临的同类问题(混杂、同质性、选择偏倚),并在研究设计阶段写出应对办法。
- 思考题:如果一项分析的结论是“A 与 B 在网络中相邻,因此 A 可能调控 B”,审稿人最可能提出哪些质疑?
Brandes 2001:A faster algorithm for betweenness centrality(Journal of Mathematical Sociology)
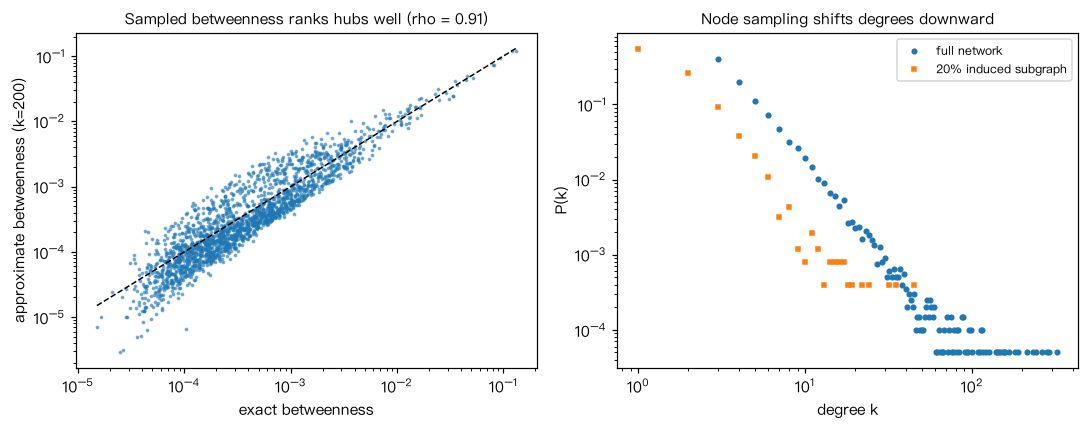
- 核心内容:通过单源依赖值的递推,把介数计算从 降到无权图 ,是 NetworkX、igraph 等软件中介数实现的基础。Brandes 与 Pich(2007, International Journal of Bifurcation and Chaos)进一步研究了只取部分源点的抽样估计及源点的选取策略。
- 阅读提示:对照数学推导与算法中的递推式,理解为什么要按距离从远到近回传。
DOI:10.1080/0022250X.2001.9990249;Brandes 与 Pich 2007:10.1142/S0218127407018403
Rubinov 与 Sporns 2010:Complex network measures of brain connectivity: uses and interpretations(NeuroImage)
- 核心内容:系统整理脑网络常用指标在二值、加权、有向网络中的定义与解释,配套 Brain Connectivity Toolbox;讨论了权重与“连接长度”之间的转换。
- 阅读提示:与本专题“权重是相似度还是距离”一节对照阅读。论文精读见 Rubinov 2010。
DOI:10.1016/j.neuroimage.2009.10.003
软件与方法文献
| 文献 | 内容 | DOI |
|---|---|---|
| Shannon 等 2003, Genome Research | Cytoscape:整合生物分子相互作用网络的软件环境 | 10.1101/gr.1239303 |
| Bastian、Heymann 与 Jacomy 2009, Proceedings of ICWSM | Gephi:网络探索与操作的开源软件 | 10.1609/icwsm.v3i1.13937 |
| Csárdi 与 Nepusz 2006, InterJournal Complex Systems 1695 | igraph 软件包的介绍 | — |
| Peixoto 2014, The graph-tool python library(figshare) | graph-tool 的引用文献 | — |
| Staudt、Sazonovs 与 Meyerhenke 2016, Network Science | NetworKit:大规模网络分析工具集 | 10.1017/nws.2016.20 |
| Virtanen 等 2020, Nature Methods | SciPy 1.0,含稀疏矩阵与 csgraph 模块 | 10.1038/s41592-019-0686-2 |
| Fruchterman 与 Reingold 1991, Software: Practice and Experience | 力导向布局 | 10.1002/spe.4380211102 |
| Kamada 与 Kawai 1989, Information Processing Letters | 基于图距离的弹簧能量布局 | 10.1016/0020-0190(89)90102-6 |
| Jacomy 等 2014, PLoS ONE | ForceAtlas2 布局 | 10.1371/journal.pone.0098679 |
| Hall 1970, Management Science | 二次布局与拉普拉斯特征向量(谱布局的思想来源) | 10.1287/mnsc.17.3.219 |
| Sugiyama、Tagawa 与 Toda 1981, IEEE Transactions on Systems, Man, and Cybernetics | 层次结构的分层布局 | 10.1109/TSMC.1981.4308636 |
| Krzywinski 等 2012, Briefings in Bioinformatics | Hive plot:基于规则的网络可视化 | 10.1093/bib/bbr069 |
| Opsahl、Agneessens 与 Skvoretz 2010, Social Networks | 加权网络中度与最短路径类中心性的推广 | 10.1016/j.socnet.2010.03.006 |
| Riondato 与 Kornaropoulos 2016, Data Mining and Knowledge Discovery | 带误差保证的介数抽样近似 | 10.1007/s10618-015-0423-0 |
| Stumpf、Wiuf 与 May 2005, PNAS | 无标度网络的子网一般不是无标度的 | 10.1073/pnas.0501179102 |
| Leskovec 与 Faloutsos 2006, Proceedings of KDD | 大图抽样方法的比较 | 10.1145/1150402.1150479 |
| Menche 等 2015, Science | 不完整相互作用组中的疾病模块与 LCC 检验 | 10.1126/science.1257601 |
| Langfelder 与 Horvath 2008, BMC Bioinformatics | WGCNA 软件包:加权共表达网络、模块与模块内连接度 | 10.1186/1471-2105-9-559 |
| Benjamini 与 Hochberg 1995, Journal of the Royal Statistical Society B | 错误发现率(FDR)控制 | 10.1111/j.2517-6161.1995.tb02031.x |
| Fieller、Hartley 与 Pearson 1957, Biometrika | 秩相关系数的检验,含 Fisher 变换后的方差近似 | 10.1093/biomet/44.3-4.470 |
Data & tools相关数据与软件
Further延伸资源
| 类型 | 资源 | 说明 |
|---|---|---|
| 官方教程 | NetworkX Tutorial(链接) | 建图、属性、读写、绘图的官方入门,约 1 小时 |
| 官方文档 | NetworkX 后端说明(链接) | nx-parallel、nx-cugraph 等后端的启用方式 |
| 官方文档 | NetworkX 绘图与布局(链接) | 全部布局函数;文档建议用专门工具作网络图 |
| 官方教程 | nx-guides:Facebook 网络探索分析(链接) | 加载真实网络→度分布→聚类→社团→可视化的完整流程,可照着改成生物网络;CC0 |
| 教材 | Menczer、Fortunato 与 Davis,A First Course in Network Science(Cambridge University Press, 2020;DOI 10.1017/9781108653947);配套 NetworkX 教程(GitHub) | 基本元素、小世界、枢纽、方向与权重、模型、社团、动力学七章均配有 Jupyter 实践 |
| 教材 | Barabási,Network Science(在线版) | 网络科学概念的系统参考,可与本专题的计算对照 |
| 官方文档 | igraph(igraph.org)、graph-tool(graph-tool.skewed.de)、NetworKit(networkit.github.io) | 需要更快实现或特定算法(Leiden、SBM 推断)时查阅 |
| 官方文档 | Brain Connectivity Toolbox(网站)、bctpy(GitHub) | 脑网络指标的 MATLAB 与 Python 实现 |
| 官方文档 | SciPy sparse 与 csgraph(链接) | 稀疏矩阵格式、稀疏线性代数与图算法 |
| 中文视频 | 同济子豪兄:图机器学习 NetworkX 代码实战——创建图和可视化(B 站) | 29 分钟中文 NetworkX 上手 |
| 中文视频 | 四十分钟掌握 Gephi(B 站) | Gephi 导入、布局、统计、导出的中文教程 |
| 中文视频 | PPI 网络:蛋白互作网络的构建与核心基因的筛选(STRING + Cytoscape + CytoNCA)(B 站) | PPI 方向最常用的操作流程;注意本专题“生物医学应用”中关于研究偏倚的提醒 |
| 官方教程 | Cytoscape Tutorials(链接) | 生物网络可视化、STRING 导入、聚类与富集分析 |
| 数据 | STRING 下载页(链接) | 人类 PPI 文件约 83 MB(压缩),CC BY 4.0,下载即可用 |
| 数据 | ENIGMA Toolbox 内置 HCP 组平均连接组(文档) | 一行代码读取结构与功能连接矩阵,免去处理原始影像,适合脑网络分析入门 |
Open questions开放问题
- 用 3 句话写出一个你感兴趣的网络研究问题:(1)生物医学问题是什么;(2)网络的节点和边是什么;(3)希望用哪一个网络指标或算法回答它。其中哪一环最薄弱?
- 在常见生物医学网络数据与分析方向中任选一个,列出构建网络时至少 3 个会显著影响结果的选择(如阈值、数据来源、是否加权),并说明怎样做敏感性分析来证明结论稳健。
- 你的网络中的边权表示的是相似度、强度还是距离?在你打算使用的每一个指标中,权重分别被当作哪一种?是否需要同时保存两种属性?
- 在完整案例中,LCC 与内部边数两种统计量在较稠密的网络中给出不同结论。对你的研究问题,应当预先指定哪一种作为主要统计量?理由是什么?
- 如果你的网络有 50 万个节点,需要找出介数最高的 100 个节点,你会依次尝试哪些策略?怎样检验近似结果足够可靠?