疾病模块、网络邻近度与药物重定位
在相互作用组上定义疾病模块,用度匹配零模型量化疾病分离度与药物邻近度,并经外部验证用于药物重定位
生物分子网络与拓扑特征提出了“疾病模块”的假说:同一疾病的相关基因倾向于在相互作用网络中聚在一起。基因调控网络推断与共表达分析讨论了怎样从表达数据推断网络。网络医学把这两条线汇合到一个更实际的问题上:药物作用在网络的哪里?能不能用网络距离预测一个已有药物可以治疗什么新疾病?
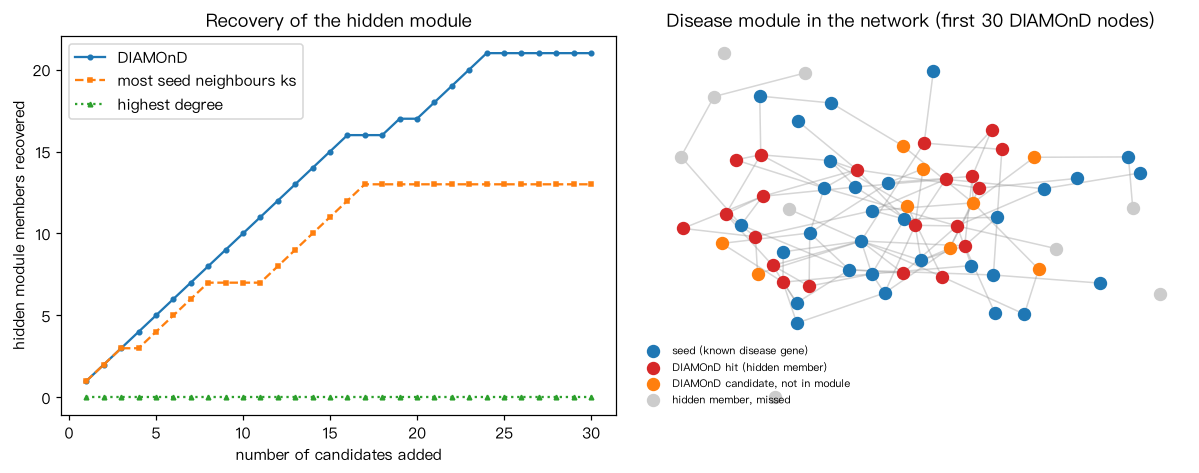
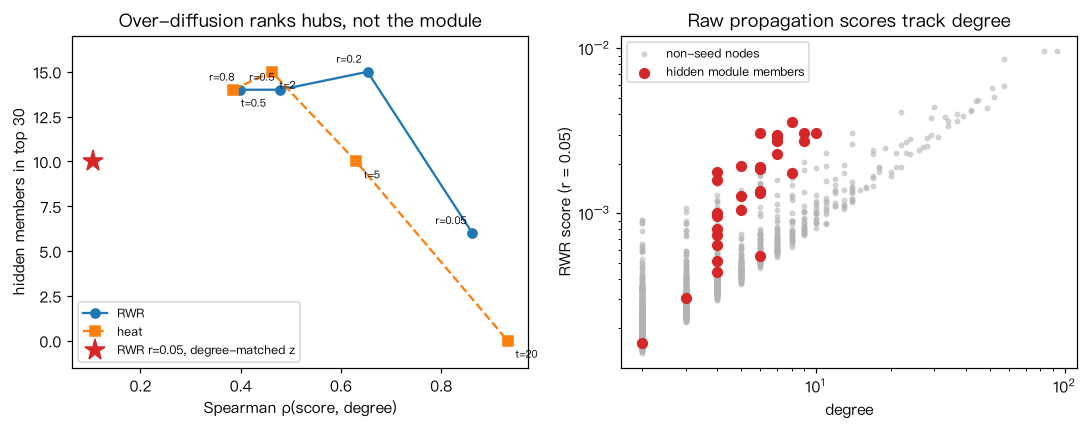
围绕这个问题,网络医学形成了三层相互依赖的方法。第一层是定位疾病:把已知疾病基因投到相互作用组上,检验它们是否聚集,并用种子扩展或网络传播把不完整的基因列表补全为疾病模块。第二层是度量关系:用网络分离度刻画两种疾病的分子重叠,用网络邻近度刻画药物靶点与疾病模块的相对位置,并推广到药物组合。第三层是预测与验证:在药物–靶点–疾病异质网络或知识图谱上做链路预测,给出重定位候选,再用电子病历、体外实验和临床试验逐级检验。
本专题依次介绍:网络医学的基本框架与相互作用组;疾病模块的定义、检测算法(DIAMOnD、随机游走与扩散、GWAS 信号的网络放大);网络传播的数学与参数选择;疾病之间的网络分离度;药物–靶点网络与网络药理学;网络邻近度及其在药物组合中的推广;从网络预测到外部验证的药物重定位(包括 COVID-19 的案例);异质网络、知识图谱与链路预测;证据层次与统计要点;最后介绍基于网络控制的靶点识别研究。计算核心是“与度匹配随机基线比较”,它与网络构建与统计验证中的零模型、社团结构与社区发现中模块度所用的配置模型一脉相承;网络传播的数学与网络上的传播与免疫中的随机游走和扩散过程同源。
Contents知识页面
VIDEO讲解视频
文字稿
大家好,这一期我们进入网络医学,讨论药物、靶点和疾病组成的网络。核心问题只有一个:药物作用在网络的哪里,能不能用网络距离找到老药新用?
巴拉巴西等人在2011年把网络医学的思路概括成几条假设。第一,同一疾病的相关基因倾向于彼此相互作用,聚在网络的同一邻域。第二,每种疾病对应相互作用组里的一个连通子图,叫作疾病模块。第三,模块重叠的疾病,在分子和临床表现上也更相似。但要记住,我们手里的相互作用组既不完整,又偏向研究得多的基因。
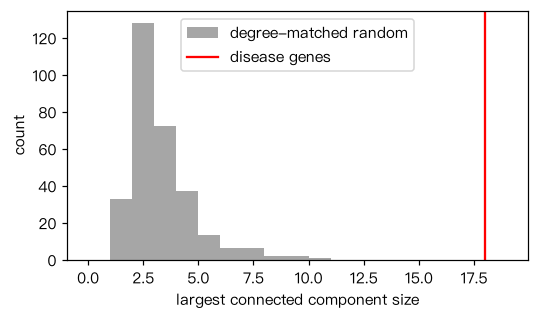
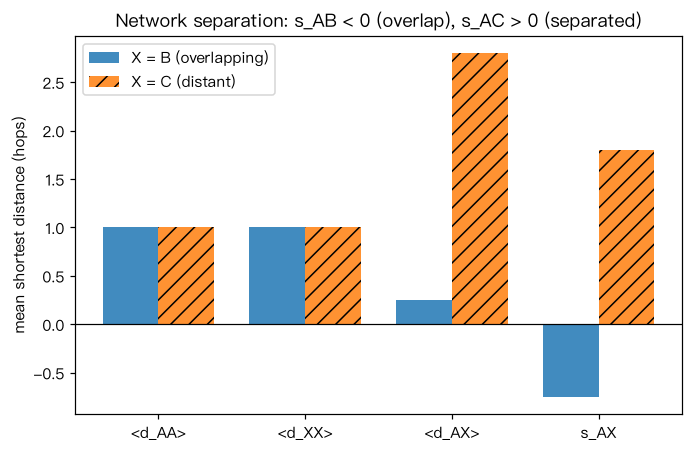
怎么判断疾病基因真的聚在一起呢?先看它们诱导子图的最大连通分支。再随机抽同样数量、同样度数的基因,看最大连通分支通常有多大。Menche 等人分析了299种疾病,其中226种的基因显著聚集。以多发性硬化为例,69个基因中只有11个相连,但随机期望只有约2个。他们又定义了网络分离度,用来衡量两种疾病模块是重叠还是分开。模块重叠的疾病对,症状更相似,共病风险也明显更高。比如哮喘和乳糜泻,临床表现很不一样,却在网络上模块重叠,也常常共病。
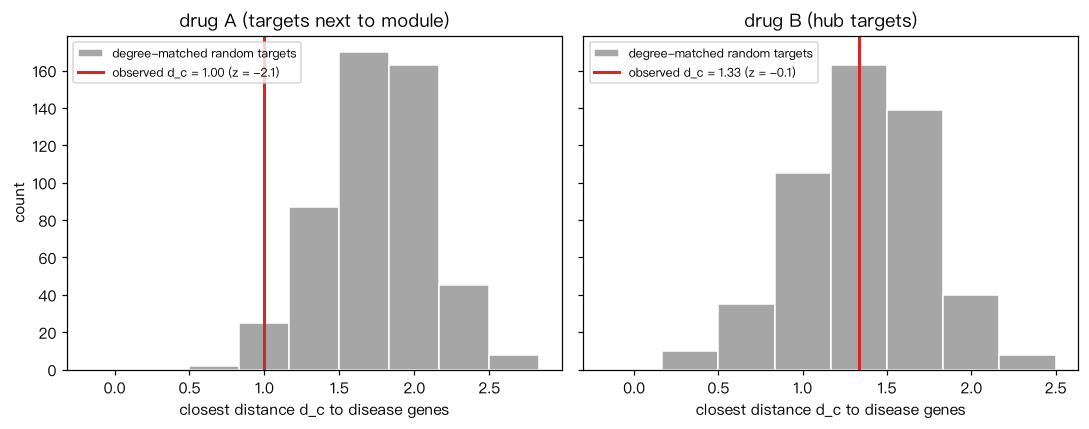
现在把药物放进来,药物通过靶点蛋白接入同一张网络。网络邻近度的做法是,对每个靶点找到离它最近的疾病基因。把这些最近距离取平均,就得到药物与疾病模块的距离。关键的一步是和度数匹配的随机靶点比较,换算成 z 分数。为什么?因为枢纽蛋白离谁都只有一两步,原始距离小并不说明特异。Guney 等人发现,有效药物的靶点往往不在模块内部,而在模块的邻域。
第一行是分离度,两疾病之间的距离减去两个模块各自内部距离的平均。分离度为负,说明两个模块在网络上重叠。第二行是邻近度的 z 分数,用随机基线的均值和标准差做标准化。z 分数明显为负,才说明药物靶点比随机期望更靠近疾病模块。
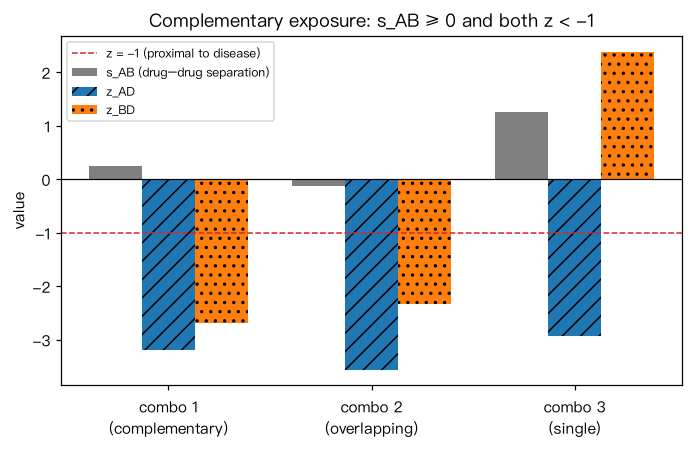
Cheng 等人2018年先用邻近度给大量已上市药物与心血管疾病打分。再用超大规模医保数据检验,发现羟氯喹使用与冠心病风险降低相关。随后又用体外实验检验了可能的机制,形成一条完整的证据链。要强调的是,只有随机对照试验才能真正回答药物是否有效。2019年他们又把这个思路推广到药物组合,寻找作用互补的两种药物。
2020年,研究者鉴定出新冠病毒蛋白结合的332个人类宿主蛋白。Gysi 等人以它们为起点,用人工智能、扩散和邻近度三类算法给药物打分。单一算法表现不稳定,把多条预测流程整合起来以后更稳健。有意思的是,实验中有效的药物,大多并不直接结合病毒的宿主靶点。不过要清醒,细胞里能抑制病毒,离临床有效还有很长的路。
小结一下,网络医学把疾病看作相互作用组中一个模块的扰动。分离度告诉我们哪些疾病共享分子基础。邻近度帮助我们为老药找新用途,但一定要和度匹配的随机基线比较。如果你的研究涉及药物或疾病基因,请把度匹配的随机基线写进方法设计。建议打开交互演示和代码示例,亲手算一次邻近度。
INTERACTIVE交互可视化
CODE计算实现
7 个完整可运行的 Python 示例,每个都给出代码、输出图和解读;可在浏览器中直接运行,或下载 Jupyter Notebook · Python 脚本。
Papers论文精读
人类疾病网络
The human disease network
Goh K-I, Cusick ME, Valle D, Childs B, Vidal M, Barabási A-L
用 OMIM 疾病–基因关联构建疾病网络,发现疾病共享遗传根源、按类别聚集,多数遗传病基因位于网络外围。
网络医学:基于网络理解人类疾病
Network medicine: a network-based approach to human disease
Barabási A-L, Gulbahce N, Loscalzo J
纲领性综述:疾病很少源于单个基因,而是细胞分子网络的扰动;系统梳理网络医学的核心假设、疾病基因预测方法与疾病间关系网络。
借助不完整的相互作用组揭示疾病之间的关系
Uncovering disease-disease relationships through the incomplete interactome
Menche J, Sharma A, Kitsak M, Ghiassian SD, Vidal M, Loscalzo J, et al.
给出不完整互作组中疾病模块可被观测的条件,提出网络分离度,用以预测疾病间的生物与临床相似性。
基于网络的药物疗效计算机筛选
Network-based in silico drug efficacy screening
Guney E, Menche J, Vidal M, Barabási A-L
提出校正度偏倚的药物–疾病网络邻近度,发现有效药物的靶点更靠近疾病基因。
癌症维持基因作为治疗靶点
Cancer-keeper genes as therapeutic targets
Zhang X, Pan C, Wei X, Yu M, Liu S, An J, et al.
提出在所有控制方案中都处于控制路径中间的控制枢纽,用作癌症维持基因,并在膀胱癌细胞和小鼠模型中检验部分候选。
References核心文献
Menche 等 2015:Uncovering disease-disease relationships through the incomplete interactome
- 背景:疾病模块假说早已提出,但相互作用组与疾病基因列表都不完整,能否在现有数据中真正看到模块?Science 347:1257601,DOI 10.1126/science.1257601。
- 核心发现:299 种疾病中 226 种的基因显著聚集;渗流理论给出可观测模块所需的基因数阈值;提出网络分离度 ,模块重叠的疾病对在功能注释、共表达、症状和共病上都更相似。
- 阅读提示:重点读图 1(不完整性与渗流)和图 3( 与四类独立验证);注意作者如何用两种随机模型评估显著性。本站论文精读见 Menche 2015,可对照阅读。
- 思考题:如果相互作用组的覆盖率再提高一倍, 的疾病对比例会上升还是下降?为什么?
Ghiassian、Menche 与 Barabási 2015:A DIseAse MOdule Detection (DIAMOnD) algorithm
- 背景:已知疾病基因只覆盖疾病模块的一部分,怎样从它们出发补全模块?PLoS Computational Biology 11:e1004120,DOI 10.1371/journal.pcbi.1004120。
- 核心发现:在 70 种疾病中,疾病蛋白不形成稠密的拓扑社团;与已知疾病蛋白连接数的超几何显著性比连接密度更能识别疾病蛋白;据此提出 DIAMOnD,并用 GO、通路和表达数据确定模块边界。
- 阅读提示:先看疾病蛋白与拓扑社团的比较,再看算法;注意截断点如何由独立数据决定,以及种子权重 的作用。
- 思考题:DIAMOnD 的超几何零模型假设邻居从全网均匀抽取,这与度异质的网络是否一致?它会偏爱高度还是低度节点?
Cowen 等 2017:Network propagation: a universal amplifier of genetic associations
- 背景:Nature Reviews Genetics 18:551–562,DOI 10.1038/nrg.2017.38。
- 核心内容:系统综述网络传播(RWR、热扩散等)的数学形式、参数与归一化选择,以及在 GWAS、体细胞突变、表达数据中的应用。
- 阅读提示:对照本专题“网络传播”一页的公式,留意综述对度偏倚和参数稳健性的讨论。
Guney 等 2016:Network-based in silico drug efficacy screening
- 背景:怎样用网络量化“药物作用于疾病”的程度?Nature Communications 7:10331,DOI 10.1038/ncomms10331。论文精读见 Guney 2016。
- 核心发现:比较多种距离度量后,“最近距离”加度匹配 分数表现最好;有效药物靶点多位于疾病模块邻域;邻近度可用于药物–疾病对的初筛。
- 阅读提示:注意随机基线的构造细节(度分箱)以及作者如何定义金标准(已知适应症);思考已知适应症本身的偏倚。
- 思考题:一个只有 1 个靶点的药物和一个有 30 个靶点的药物,邻近度 分数可比吗? 的方差会怎样受靶点数影响?
Cheng 等 2018:Network-based approach to prediction and population-based validation of in silico drug repurposing
- 背景:Nature Communications 9:2691,DOI 10.1038/s41467-018-05116-5。
- 核心发现:用邻近度为 900 多种 FDA 批准药物预测新的药物–疾病关联;在 2.2 亿以上患者的医保数据中,4 个冠心病相关预测有 2 个得到支持(卡马西平风险升高、羟氯喹风险降低),并用体外实验提供机制证据。
- 阅读提示:重点看药物流行病学部分的设计(倾向评分匹配、对照组选择),以及为什么只选 4 个预测做检验。
Cheng、Kovács 与 Barabási 2019:Network-based prediction of drug combinations
- 背景:Nature Communications 10:1197,DOI 10.1038/s41467-019-09186-x。
- 核心发现:药物–药物–疾病三元组有六种网络构型,只有“两药都命中疾病模块、但作用于不同邻域”的互补暴露与已批准高血压和癌症组合的疗效相关。
- 阅读提示:留意构型分类所用的阈值,以及作者如何用已批准组合作为参照。
Gysi 等 2021:Network medicine framework for identifying drug-repurposing opportunities for COVID-19
- 背景:疫情初期急需在已上市药物中寻找候选。PNAS 118(19):e2025581118,DOI 10.1073/pnas.2025581118。
- 核心发现:AI、扩散、邻近度三类网络算法各有短长,秩聚合后的整合预测更稳健;实验验证的有效药物多数不直接结合病毒宿主靶点。
- 阅读提示:留意作者如何在“看到实验结果之前”固定预测并据此评估,以及不同验证数据集上性能的差异。
- 思考题:本文的验证终点是细胞实验中的病毒抑制。若要把候选推进到临床,还缺哪些证据?网络方法能在其中哪一步继续发挥作用?
Himmelstein 等 2017:Systematic integration of biomedical knowledge prioritizes drugs for repurposing
- 背景:eLife 6:e26726,DOI 10.7554/eLife.26726。
- 核心发现:构建 Hetionet(11 类节点、24 类边),以元路径特征训练模型,为 20 余万化合物–疾病对给出治疗概率,并在外部治疗关系集上验证;整个项目公开进行。
- 阅读提示:看元路径特征如何做度降权,以及可解释性(哪些元路径贡献最大)。
其他引用文献
- Barabási AL, Gulbahce N, Loscalzo J (2011). Network medicine: a network-based approach to human disease. Nature Reviews Genetics 12:56–68. DOI 10.1038/nrg2918。精读见 Barabási 2011。
- Goh KI 等 (2007). The human disease network. PNAS 104:8685–8690. DOI 10.1073/pnas.0701361104。精读见 Goh 2007。
- Yıldırım MA 等 (2007). Drug–target network. Nature Biotechnology 25:1119–1126. DOI 10.1038/nbt1338。
- Hopkins AL (2008). Network pharmacology: the next paradigm in drug discovery. Nature Chemical Biology 4:682–690. DOI 10.1038/nchembio.118。
- Köhler S 等 (2008). Walking the interactome for prioritization of candidate disease genes. American Journal of Human Genetics 82:949–958. DOI 10.1016/j.ajhg.2008.02.013。
- Vanunu O 等 (2010). Associating genes and protein complexes with disease via network propagation. PLoS Computational Biology 6:e1000641. DOI 10.1371/journal.pcbi.1000641。
- Leiserson MDM 等 (2015). Pan-cancer network analysis identifies combinations of rare somatic mutations across pathways and protein complexes. Nature Genetics 47:106–114. DOI 10.1038/ng.3168。
- Barrio-Hernandez I 等 (2023). Network expansion of genetic associations defines a pleiotropy map of human cell biology. Nature Genetics 55:389–398. DOI 10.1038/s41588-023-01327-9。
- Gordon DE 等 (2020). A SARS-CoV-2 protein interaction map reveals targets for drug repurposing. Nature 583:459–468. DOI 10.1038/s41586-020-2286-9。
- RECOVERY Collaborative Group (2020). Effect of hydroxychloroquine in hospitalized patients with Covid-19. New England Journal of Medicine 383:2030–2040. DOI 10.1056/NEJMoa2022926。
- Pushpakom S 等 (2019). Drug repurposing: progress, challenges and recommendations. Nature Reviews Drug Discovery 18:41–58. DOI 10.1038/nrd.2018.168。
- Zitnik M, Agrawal M, Leskovec J (2018). Modeling polypharmacy side effects with graph convolutional networks. Bioinformatics 34:i457–i466. DOI 10.1093/bioinformatics/bty294。
- Liben-Nowell D, Kleinberg J (2007). The link-prediction problem for social networks. Journal of the American Society for Information Science and Technology 58:1019–1031. DOI 10.1002/asi.20591。
- Lü L, Zhou T (2011). Link prediction in complex networks: a survey. Physica A 390:1150–1170. DOI 10.1016/j.physa.2010.11.027。
- Adamic LA, Adar E (2003). Friends and neighbors on the Web. Social Networks 25:211–230. DOI 10.1016/S0378-8733(03)00009-1。
- Zhou T, Lü L, Zhang YC (2009). Predicting missing links via local information. European Physical Journal B 71:623–630. DOI 10.1140/epjb/e2009-00335-8。
- Kovács IA 等 (2019). Network-based prediction of protein interactions. Nature Communications 10:1240. DOI 10.1038/s41467-019-09177-y。
- Bordes A 等 (2013). Translating embeddings for modeling multi-relational data(TransE). Advances in Neural Information Processing Systems 26。Yang B 等 (2015). Embedding entities and relations for learning and inference in knowledge bases(DistMult). ICLR。Sun Z 等 (2019). RotatE: knowledge graph embedding by relational rotation in complex space. ICLR。(会议论文,未列 DOI)
- Hernán MA, Robins JM (2016). Using big data to emulate a target trial when a randomized trial is not available. American Journal of Epidemiology 183:758–764. DOI 10.1093/aje/kwv254。
- Zhang X 等 (2023). Cancer-keeper genes as therapeutic targets. iScience 26:107296. DOI 10.1016/j.isci.2023.107296。精读见 Zhang 2023。
- Wei X, Pan C, Zhang X, Zhang W (2023). Total network controllability analysis discovers explainable drugs for Covid-19 treatment. Biology Direct 18:55. DOI 10.1186/s13062-023-00410-9。
Data & tools相关数据与软件
Further延伸资源
| 类型 | 资源 | 说明 |
|---|---|---|
| 综述 | Barabási, Gulbahce & Loscalzo 2011,doi.org/10.1038/nrg2918 | 网络医学的纲领性综述,先读这篇;精读见 Barabási 2011 |
| 综述 | Cowen 等 2017,doi.org/10.1038/nrg.2017.38 | 网络传播的数学与应用综述,对应本专题“网络传播”与“疾病模块检测”两页 |
| 综述 | Pushpakom 等 2019,doi.org/10.1038/nrd.2018.168 | 药物重定位的整体图景,包括计算、实验与监管和商业层面的挑战 |
| 教材 | Loscalzo, Barabási & Silverman(主编),Network Medicine: Complex Systems in Human Disease and Therapeutics,Harvard University Press,2017 | 网络医学的专著,覆盖互作组、复杂疾病遗传学、组学网络、癌症与系统药理学;本专题对照其覆盖面组织 |
| 视频 | Network Medicine: From Cellular Networks to Drug Repurposing for COVID-19(Barabási,2020) | 英文,约 54 分钟,方法提出者本人讲疾病模块、邻近度与 COVID-19 重定位;需境外网络 |
| 视频 | 6 分钟带你快速了解——什么是网络药理学?(B 站) | 中文科普,概念入门;注意 B 站常见的“成分–靶点–PPI–富集”流程没有度匹配零模型,严谨性不及本专题介绍的邻近度方法 |
| 原始研究 | Cheng 等 2018,doi.org/10.1038/s41467-018-05116-5;Zhou 等 2020,doi.org/10.1038/s41421-020-0153-3 | 网络预测 + 人群数据验证的重定位;疫情初期的 SARS-CoV-2 网络重定位,均开放获取 |
| 工具 | NetMedPy(GitHub) | Python 包,计算疾病模块 LCC、邻近度与分离度 z 分数,可直接用于实际分析 |
| 工具 | Guney 2016 配套代码 toolbox | 邻近度方法的原始实现,适合对照论文理解随机基线细节 |
| 交互工具 | Hetionet Neo4j Browser;数据见 hetio/hetionet | 不装软件,在浏览器里查询“药物–基因–疾病”路径;数据原创部分为 CC0 |
| 交互工具 | Open Targets Platform | 查询靶点–疾病关联证据和已知药物,数据 CC0 |
Open questions开放问题
- 针对一种具体疾病,设想用网络邻近度为它筛选重定位候选药物:应从哪些数据库取疾病基因和药物靶点?用哪种组织特异的网络?怎样设计度匹配随机基线和独立验证?
- 网络医学假定“疾病是分子网络的扰动”。对于精神疾病、慢性疼痛等分子机制尚不清楚的疾病,这个框架有哪些适用之处和局限?能否与症状网络结合?
- DIAMOnD、RWR 与热扩散在同一组种子上给出的候选基因排序往往不同。如果没有独立的金标准,怎样判断哪一种更可信?哪些差异来自度偏倚,哪些来自对路径长度的不同加权?
- “互补暴露”是对已批准组合的统计规律。怎样设计一项前瞻性研究,检验它对新组合的预测能力?剂量与药代动力学信息应如何纳入?
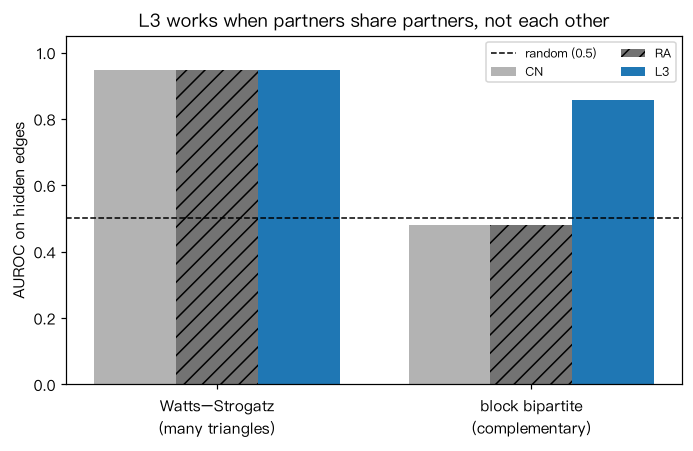
- 一项链路预测模型在随机拆边下 AUROC 为 0.95,在按疾病拆分下降到 0.70。哪个数字更能代表它在药物重定位中的实际价值?还应补充哪些评估?