Example02 / 07
药物–疾病网络邻近度(最近距离 d_c + 度匹配 z 分数)
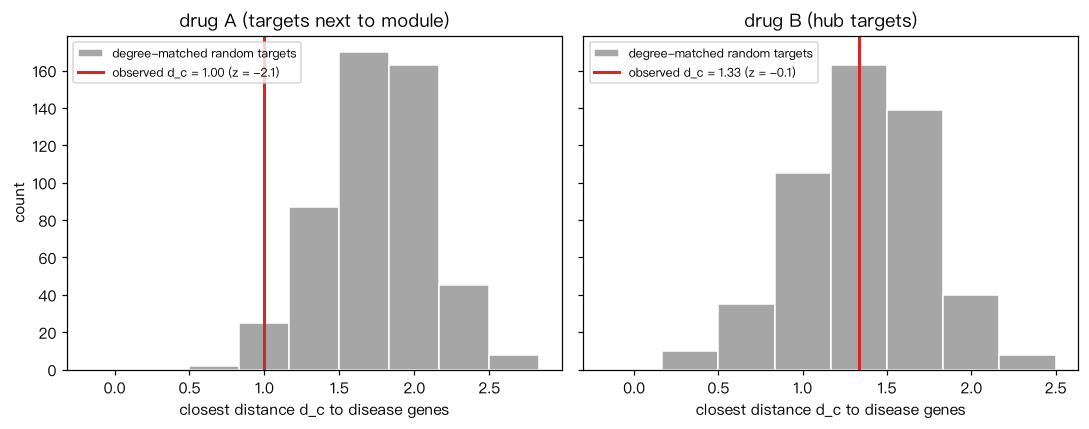
定义:d_c(S, T) = 平均_{t ∈ T} min_{s ∈ S} d(s, t),S 为疾病基因,T 为药物靶点。 比较两种“药物”:药物 A 的 3 个靶点紧挨疾病模块(中等度数);药物 B 的 3 个靶点是全网度最大的枢纽。 对每种药物用 500 组度匹配随机靶点集合计算 z 分数(为简洁起见,这里只对靶点做度匹配抽样, 完整做法还应同时对疾病基因做度匹配抽样,见“数学推导与算法”中的算法 1)。 输出解读:药物 B 的原始距离也很短(枢纽离谁都近),但与同度数随机靶点相比 z 接近 0; 药物 A 的 z 明显为负,说明它“特异地”靠近疾病模块。 靶点只有 3 个、距离是小整数时,d_c 的零分布离散且偏斜,z 与经验 p 值可能给出不同强度的结论, 此时应以经验 p 值为主,并在大量药物–疾病对上做多重比较校正。
Output输出图
Output文字输出
药物A(贴近模块):靶点度 = [8, 7, 5],d_c = 1.00,z = -2.10,经验 p = 0.056
药物B(枢纽靶点):靶点度 = [70, 43, 41],d_c = 1.33,z = -0.06,经验 p = 0.627
Code代码
# 定义:d_c(S, T) = 平均_{t ∈ T} min_{s ∈ S} d(s, t),S 为疾病基因,T 为药物靶点。
# 比较两种“药物”:药物 A 的 3 个靶点紧挨疾病模块(中等度数);药物 B 的 3 个靶点是全网度最大的枢纽。
# 对每种药物用 500 组度匹配随机靶点集合计算 z 分数(为简洁起见,这里只对靶点做度匹配抽样,
# 完整做法还应同时对疾病基因做度匹配抽样,见“数学推导与算法”中的算法 1)。
# 输出解读:药物 B 的原始距离也很短(枢纽离谁都近),但与同度数随机靶点相比 z 接近 0;
# 药物 A 的 z 明显为负,说明它“特异地”靠近疾病模块。
# 靶点只有 3 个、距离是小整数时,d_c 的零分布离散且偏斜,z 与经验 p 值可能给出不同强度的结论,
# 此时应以经验 p 值为主,并在大量药物–疾病对上做多重比较校正。
import networkx as nx
import numpy as np

def make_network(seed=14):
    G = nx.barabasi_albert_graph(1000, 2, seed=seed)
    rng = np.random.default_rng(seed)
    start = int(rng.choice([n for n in G if 4 <= G.degree(n) <= 8]))
    module = {start}
    while len(module) < 25:
        frontier = {v for u in module for v in G[u]} - module
        score = {v: sum(1 for u in G[v] if u in module) for v in frontier}
        best = max(score.values())
        cand = sorted(v for v in frontier if score[v] == best)
        module.add(int(rng.choice(cand)))
    known = sorted(rng.choice(sorted(module), size=20, replace=False).tolist())
    return G, known

def degree_bins(G, min_bin=40):
    by_deg = {}
    for n, d in G.degree():
        by_deg.setdefault(d, []).append(n)
    bins, cur = [], []
    for d in sorted(by_deg):
        cur += by_deg[d]
        if len(cur) >= min_bin:
            bins.append(cur); cur = []
    if cur:
        bins[-1] += cur
    return {n: b for b in bins for n in b}

G, disease = make_network()
node2bin = degree_bins(G)

# 一次多源 BFS 得到每个节点到最近疾病基因的距离(把所有疾病基因同时作为起点)
dist = nx.multi_source_dijkstra_path_length(G, set(disease))
N = G.number_of_nodes()
min_to_disease = np.array([dist.get(v, np.inf) for v in range(N)])

# 药物 A:3 个“不是已知疾病基因、但与疾病基因直接相邻”的中等度数节点
nbrs = sorted({v for s in disease for v in G[s]} - set(disease))
drug_A = [v for v in nbrs if 3 <= G.degree(v) <= 10][:3]
# 药物 B:全网度最大的 3 个枢纽(排除疾病基因)
drug_B = [v for v, _ in sorted(G.degree(), key=lambda x: -x[1]) if v not in disease][:3]

def closest(targets):
    return float(np.mean(min_to_disease[list(targets)]))

def null_dc(targets, n_rand=500, seed=1):
    """度匹配随机靶点集合的 d_c 零分布。"""
    r = np.random.default_rng(seed)
    return np.array([closest([int(r.choice(node2bin[t])) for t in targets]) for _ in range(n_rand)])

def proximity_z(targets, n_rand=500, seed=1):
    obs = closest(targets)
    rand = null_dc(targets, n_rand, seed)
    p = (1 + np.sum(rand <= obs)) / (n_rand + 1)
    return obs, (obs - rand.mean()) / rand.std(), p

for name, T in [("药物A(贴近模块)", drug_A), ("药物B(枢纽靶点)", drug_B)]:
    d, z, p = proximity_z(T)
    print(f"{name}:靶点度 = {[G.degree(t) for t in T]},d_c = {d:.2f},z = {z:.2f},经验 p = {p:.3f}")

import matplotlib.pyplot as plt
fig, axes = plt.subplots(1, 2, figsize=(10, 4), sharey=True)
for ax, T, title in zip(axes, [drug_A, drug_B], ["drug A (targets next to module)", "drug B (hub targets)"]):
    rand = null_dc(T); d, z, _ = proximity_z(T)
    ax.hist(rand, bins=np.arange(-1 / 6, rand.max() + 0.5, 1 / 3), color="0.65", edgecolor="white",
            label="degree-matched random targets")
    ax.axvline(d, color="C3", lw=2, label=f"observed d_c = {d:.2f} (z = {z:.1f})")
    ax.set_xlabel("closest distance d_c to disease genes"); ax.set_title(title); ax.legend(fontsize=8)
axes[0].set_ylabel("count")
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。