Example06 / 07
药物组合的网络构型(两药分离度 + 各自与疾病模块的邻近度)
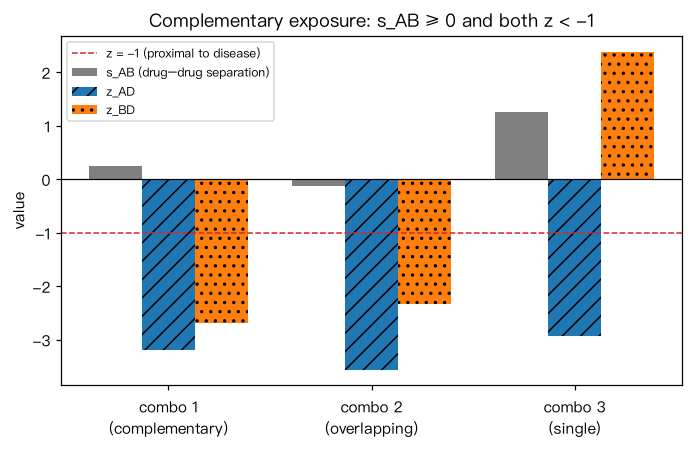
思路来自 Cheng、Kovács 与 Barabási(2019):对药物对 (A, B) 与疾病 D,看三个量: s_AB:两药靶点集合的网络分离度(<0 重叠,>=0 分离); z_AD、z_BD:各药靶点与疾病模块的邻近度 z 分数(度匹配随机靶点,z < 0 视为“命中”模块邻域)。 构造一个由两个相邻子模块组成的疾病模块,以及三种组合: 组合 1:两药各靶向一个子模块(互补暴露);组合 2:两药靶向同一子模块(重叠暴露); 组合 3:一药靶向疾病模块,另一药靶向远处(单一暴露)。 输出解读:只有组合 1 同时满足 s_AB >= 0 且两药都邻近疾病模块。阈值在这里为演示而设,真实分析需按原文校准。
Output输出图
Output文字输出
组合1(拟互补暴露):s_AB =  0.25,z_AD = -3.20,z_BD = -2.68 → 判为 互补暴露
组合2(拟重叠暴露):s_AB = -0.12,z_AD = -3.56,z_BD = -2.33 → 判为 重叠暴露
组合3(拟单一暴露):s_AB =  1.25,z_AD = -2.93,z_BD =  2.38 → 判为 单一/间接暴露
Code代码
# 思路来自 Cheng、Kovács 与 Barabási(2019):对药物对 (A, B) 与疾病 D,看三个量:
#   s_AB:两药靶点集合的网络分离度(<0 重叠,>=0 分离);
#   z_AD、z_BD:各药靶点与疾病模块的邻近度 z 分数(度匹配随机靶点,z < 0 视为“命中”模块邻域)。
# 构造一个由两个相邻子模块组成的疾病模块,以及三种组合:
#   组合 1:两药各靶向一个子模块(互补暴露);组合 2:两药靶向同一子模块(重叠暴露);
#   组合 3:一药靶向疾病模块,另一药靶向远处(单一暴露)。
# 输出解读:只有组合 1 同时满足 s_AB >= 0 且两药都邻近疾病模块。阈值在这里为演示而设,真实分析需按原文校准。
import networkx as nx
import numpy as np

G = nx.barabasi_albert_graph(1500, 2, seed=21)
deg = dict(G.degree())
rng = np.random.default_rng(5)

def grow(start, size, maxdeg=12):
    mod = {start}
    while len(mod) < size:
        fr = {v for u in mod for v in G[u] if deg[v] <= maxdeg} - mod
        sc = {v: sum(1 for u in G[v] if u in mod) for v in fr}
        b = max(sc.values())
        mod.add(int(rng.choice(sorted(v for v in fr if sc[v] == b))))
    return mod

sp_all = dict(nx.all_pairs_shortest_path_length(G))
mid = [v for v in G if 3 <= deg[v] <= 8]
a0 = mid[0]
b0 = next(v for v in mid if sp_all[a0][v] == 4)          # 两个子模块的起点相距 4 步
far0 = max(mid, key=lambda v: sp_all[a0][v])               # 远处起点
sub1, sub2 = grow(a0, 15), grow(b0, 15)
disease = sorted(sub1 | sub2)

def pick(module, k=4, avoid=()):
    pool = sorted(set(module) - set(disease) - set(avoid)) or sorted(set(module) - set(avoid))
    return sorted(rng.choice(pool, size=k, replace=False).tolist())

ring1 = {v for u in sub1 for v in G[u]} | sub1               # 子模块 1 及其一步邻域
ring2 = {v for u in sub2 for v in G[u]} | sub2
far = grow(far0, 15)
drug = {"A1": pick(ring1), "B1": pick(ring2),
        "A2": pick(ring1), "B2": None, "A3": pick(ring2), "B3": pick(far)}
drug["B2"] = pick(ring1, avoid=drug["A2"])

def d_within(X):
    return np.mean([min(sp_all[x][y] for y in X if y != x) for x in X])
def d_between(X, Y):
    return np.mean([min(sp_all[x][y] for y in Y) for x in X] + [min(sp_all[y][x] for x in X) for y in Y])
def separation(X, Y):
    return d_between(X, Y) - (d_within(X) + d_within(Y)) / 2

by = {}
for v, d in deg.items(): by.setdefault(d, []).append(v)
bins, cur = [], []
for d in sorted(by):
    cur += by[d]
    if len(cur) >= 50: bins.append(cur); cur = []
if cur: bins[-1] += cur
node2bin = {v: b for b in bins for v in b}

def proximity_z(T, S, n_rand=300):
    dc = lambda T_, S_: np.mean([min(sp_all[t][s] for s in S_) for t in T_])
    obs = dc(T, S)
    rand = [dc([int(rng.choice(node2bin[t])) for t in T], [int(rng.choice(node2bin[s])) for s in S])
            for _ in range(n_rand)]
    return (obs - np.mean(rand)) / np.std(rand)

combo = []
for i, label in [(1, "组合1(拟互补暴露)"), (2, "组合2(拟重叠暴露)"), (3, "组合3(拟单一暴露)")]:
    A, B = drug[f"A{i}"], drug[f"B{i}"]
    sAB, zA, zB = separation(A, B), proximity_z(A, disease), proximity_z(B, disease)
    hitA, hitB = zA < -1, zB < -1
    if hitA and hitB:
        kind = "互补暴露" if sAB >= 0 else "重叠暴露"
    elif hitA or hitB:
        kind = "单一/间接暴露"
    else:
        kind = "非暴露/独立作用"
    print(f"{label}:s_AB = {sAB:5.2f},z_AD = {zA:5.2f},z_BD = {zB:5.2f} → 判为 {kind}")
    combo.append((sAB, zA, zB))

import matplotlib.pyplot as plt
fig, ax = plt.subplots(figsize=(6.4, 4.2))
vals = np.array(combo); x = np.arange(3)
for k, (lab, c, h) in enumerate([("s_AB (drug–drug separation)", "0.5", ""), ("z_AD", "C0", "//"), ("z_BD", "C1", "..")]):
    ax.bar(x + (k - 1) * 0.26, vals[:, k], 0.26, color=c, hatch=h, label=lab)
ax.axhline(0, color="k", lw=0.8); ax.axhline(-1, color="C3", ls="--", lw=1, label="z = -1 (proximal to disease)")
ax.set_xticks(x); ax.set_xticklabels(["combo 1\n(complementary)", "combo 2\n(overlapping)", "combo 3\n(single)"])
ax.set_ylabel("value"); ax.set_title("Complementary exposure: s_AB ≥ 0 and both z < -1"); ax.legend(fontsize=8)
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。