Example09 / 09
完整案例——从模拟表达矩阵到共表达模块、枢纽基因与“疾病基因是否成团”的检验
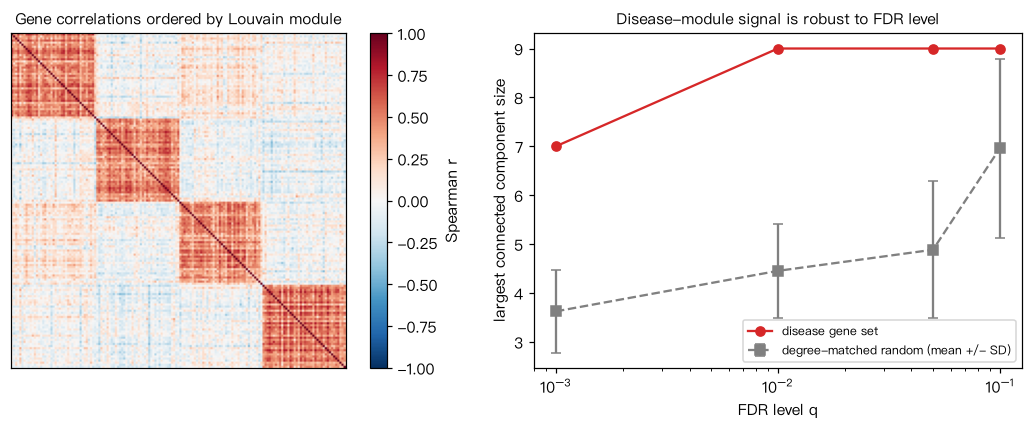
数据:代码生成的模拟表达矩阵(200 个基因 × 60 个样本),含 4 个由潜在因子驱动的共表达模块与 40 个噪声基因; 另设一个 12 个基因的“疾病基因集”(8 个来自模块 0,4 个随机)。全部为模拟数据,仅演示流程。 流程:质控(去除低方差基因)→ Spearman 相关 → 置换得到的相关阈值与 Benjamini–Hochberg FDR 控制 → 建网并报告孤立点 → Louvain 模块并与植入模块对照(ARI)→ 模块内连接度找枢纽基因 → 疾病基因集诱导子图最大连通分支(LCC)与度匹配随机基因集比较(经验 p 值)→ 换 FDR 水平做敏感性分析。 解读:结论应写成“在本网络构建方式下,疾病基因集的 LCC 显著大于度匹配随机期望,且对 FDR 水平稳健”, 而不是“这些基因构成致病模块”。
Output输出图
Output文字输出
1) 质控后基因数:195(去除 5 个低方差基因)
2) FDR=0.01 且 r>0:2031 条边,密度 0.107,孤立基因 34 个(其中噪声基因 33 个)
3) Louvain:4 个模块,Q = 0.745,与植入模块 ARI = 0.983
4) 模块 0(41 个基因)枢纽:G032,模块内强度 23.2
4) 模块 1(40 个基因)枢纽:G073,模块内强度 23.4
4) 模块 2(40 个基因)枢纽:G103,模块内强度 21.0
4) 模块 3(40 个基因)枢纽:G138,模块内强度 24.3
5) 疾病基因集:11 个在网络中
   LCC 大小:观测 9,度匹配随机 4.5 ± 1.0,z = 4.7,经验 p = 0.0030
   内部边数:观测 24,度匹配随机 10.1 ± 2.7,z = 5.1,经验 p = 0.0030
6) FDR=0.001:1390 边;LCC 7(随机 3.6,p=0.004);内部边 18(随机 6.6,p=0.002)
6) FDR=0.050:2536 边;LCC 9(随机 4.9,p=0.024);内部边 26(随机 11.4,p=0.006)
6) FDR=0.100:2805 边;LCC 9(随机 7.0,p=0.210);内部边 26(随机 14.3,p=0.018)
Code代码
# 数据:代码生成的模拟表达矩阵(200 个基因 × 60 个样本),含 4 个由潜在因子驱动的共表达模块与 40 个噪声基因;
#       另设一个 12 个基因的“疾病基因集”(8 个来自模块 0,4 个随机)。全部为模拟数据,仅演示流程。
# 流程:质控(去除低方差基因)→ Spearman 相关 → 置换得到的相关阈值与 Benjamini–Hochberg FDR 控制 →
#       建网并报告孤立点 → Louvain 模块并与植入模块对照(ARI)→ 模块内连接度找枢纽基因 →
#       疾病基因集诱导子图最大连通分支(LCC)与度匹配随机基因集比较(经验 p 值)→ 换 FDR 水平做敏感性分析。
# 解读:结论应写成“在本网络构建方式下,疾病基因集的 LCC 显著大于度匹配随机期望,且对 FDR 水平稳健”,
#       而不是“这些基因构成致病模块”。
import numpy as np
import networkx as nx
from scipy.stats import spearmanr, norm

rng = np.random.default_rng(2026)
n_samples, mod_sizes, n_noise = 60, [40, 40, 40, 40], 40
blocks, X = [], []
for m, s in enumerate(mod_sizes):
    f = rng.normal(size=n_samples)                                  # 模块的潜在驱动因子
    load = rng.uniform(0.5, 0.9, size=s)
    X.append(load[:, None] * f[None, :] + np.sqrt(1 - load[:, None] ** 2) * rng.normal(size=(s, n_samples)))
    blocks += [m] * s
X.append(rng.normal(size=(n_noise, n_samples))); blocks += [-1] * n_noise
X = np.vstack(X) * rng.uniform(0.2, 2.0, size=(len(blocks), 1))      # 基因间表达尺度不同
X[-5:] *= 0.01                                                      # 5 个几乎不表达变化的基因
genes = np.array(["G%03d" % i for i in range(len(blocks))]); blocks = np.array(blocks)

# 1) 质控:去除方差最低的基因
keep = X.var(axis=1) > 0.01
X, genes, blocks = X[keep], genes[keep], blocks[keep]
print("1) 质控后基因数:%d(去除 %d 个低方差基因)" % (len(genes), int((~keep).sum())))

# 2) Spearman 相关与 FDR 控制(大样本近似:Fisher z 变换后用正态分布求 p 值)
R = spearmanr(X, axis=1).correlation
iu = np.triu_indices(len(genes), 1)
r = R[iu]
z = np.arctanh(np.clip(r, -0.999999, 0.999999)) * np.sqrt((n_samples - 3) / 1.06)
p = 2 * norm.sf(np.abs(z))

def bh_reject(p, q):
    order = np.argsort(p); m = len(p)
    passed = p[order] <= q * np.arange(1, m + 1) / m
    k = passed.nonzero()[0].max() + 1 if passed.any() else 0
    rej = np.zeros(m, bool); rej[order[:k]] = True
    return rej

def build(q, positive_only=True):
    rej = bh_reject(p, q) & ((r > 0) if positive_only else True)
    H = nx.Graph(); H.add_nodes_from(genes)
    H.add_weighted_edges_from((genes[i], genes[j], r_ij) for i, j, r_ij in zip(iu[0][rej], iu[1][rej], r[rej]))
    return H

G = build(0.01)
iso = [v for v in G if G.degree(v) == 0]
print("2) FDR=0.01 且 r>0:%d 条边,密度 %.3f,孤立基因 %d 个(其中噪声基因 %d 个)" % (
    G.number_of_edges(), nx.density(G), len(iso), int(sum(blocks[genes == v][0] == -1 for v in iso))))
G.remove_nodes_from(iso)

# 3) Louvain 模块与植入模块对照(调整兰德指数 ARI)
def ari(a, b):
    from math import comb
    a = np.unique(a, return_inverse=True)[1]; b = np.unique(b, return_inverse=True)[1]
    C = np.zeros((a.max() + 1, b.max() + 1), int)
    for i, j in zip(a, b): C[i, j] += 1
    s = sum(comb(int(x), 2) for x in C.ravel())
    sa = sum(comb(int(x), 2) for x in C.sum(1)); sb = sum(comb(int(x), 2) for x in C.sum(0))
    e = sa * sb / comb(len(a), 2)
    return (s - e) / (0.5 * (sa + sb) - e)

comms = nx.community.louvain_communities(G, weight="weight", seed=1)
lab = {v: k for k, c in enumerate(comms) for v in c}
nodes = list(G)
true = [blocks[genes == v][0] for v in nodes]
print("3) Louvain:%d 个模块,Q = %.3f,与植入模块 ARI = %.3f" % (
    len(comms), nx.community.modularity(G, comms, weight="weight"), ari([lab[v] for v in nodes], true)))

# 4) 模块内连接度(模块内强度)最高的基因作为候选枢纽
for k, c in enumerate(sorted(comms, key=len, reverse=True)[:4]):
    sub = G.subgraph(c)
    hub = max(sub.degree(weight="weight"), key=lambda x: x[1])
    print("4) 模块 %d(%d 个基因)枢纽:%s,模块内强度 %.1f" % (k, len(c), hub[0], hub[1]))

# 5) 疾病基因集是否成团:两种统计量(LCC 大小、集合内部边数)与度匹配随机基因集比较
mod0 = genes[blocks == 0]; others = genes[blocks != 0]
disease = list(rng.choice(mod0, 8, replace=False)) + list(rng.choice(others, 4, replace=False))

def stats(H, S):
    sub = H.subgraph([v for v in S if v in H])
    return np.array([max((len(c) for c in nx.connected_components(sub)), default=0), sub.number_of_edges()])

def degree_matched_test(H, S, n_perm=1000, n_bins=10, seed=0):
    rng_ = np.random.default_rng(seed)
    S = [v for v in S if v in H]
    deg = dict(H.degree())
    cuts = np.quantile(list(deg.values()), np.linspace(0, 1, n_bins + 1))
    bin_of = {v: min(np.searchsorted(cuts, deg[v], side="right") - 1, n_bins - 1) for v in H}
    pool = {}
    for v, b in bin_of.items(): pool.setdefault(b, []).append(v)
    obs = stats(H, S)
    null = []
    for _ in range(n_perm):
        R_ = []
        for v in S:                                     # 每个疾病基因换成同一度区间内的随机基因
            cand = [u for u in pool[bin_of[v]] if u not in R_]
            R_.append(cand[rng_.integers(len(cand))])
        null.append(stats(H, R_))
    null = np.array(null)
    pv = (1 + (null >= obs).sum(0)) / (n_perm + 1)
    return obs, null.mean(0), null.std(0), pv

obs, mu, sd, pv = degree_matched_test(G, disease)
print("5) 疾病基因集:%d 个在网络中" % sum(v in G for v in disease))
for i, name in enumerate(["LCC 大小", "内部边数"]):
    print("   %s:观测 %d,度匹配随机 %.1f ± %.1f,z = %.1f,经验 p = %.4f" % (
        name, obs[i], mu[i], sd[i], (obs[i] - mu[i]) / sd[i], pv[i]))

# 6) 敏感性分析:换 FDR 水平重建网络,两种统计量是否给出一致结论
sens = [(0.01, obs[0], mu[0], sd[0])]                    # 保存 LCC 结果用于作图
for q in (0.001, 0.05, 0.1):
    H = build(q); H.remove_nodes_from([v for v in H if H.degree(v) == 0])
    o, m_, s_, pv = degree_matched_test(H, disease, n_perm=500, seed=1)
    sens.append((q, o[0], m_[0], s_[0]))
    print("6) FDR=%.3f:%d 边;LCC %d(随机 %.1f,p=%.3f);内部边 %d(随机 %.1f,p=%.3f)" % (
        q, H.number_of_edges(), o[0], m_[0], pv[0], o[1], m_[1], pv[1]))

# 作图:按 Louvain 模块排序的基因相关矩阵;不同 FDR 水平下疾病基因集 LCC 与度匹配随机期望
import matplotlib.pyplot as plt
fig, ax = plt.subplots(1, 2, figsize=(10, 4))
idx = {g: i for i, g in enumerate(genes)}
order = [idx[v] for c in sorted(comms, key=len, reverse=True) for v in sorted(c)]
im = ax[0].imshow(R[np.ix_(order, order)], cmap="RdBu_r", vmin=-1, vmax=1)
fig.colorbar(im, ax=ax[0], label="Spearman r"); ax[0].set_xticks([]); ax[0].set_yticks([])
ax[0].set_title("Gene correlations ordered by Louvain module", fontsize=10)
sens.sort()
qs = [s_[0] for s_ in sens]
ax[1].errorbar(qs, [s_[2] for s_ in sens], yerr=[s_[3] for s_ in sens], fmt="s--", color="0.5", capsize=3,
               label="degree-matched random (mean +/- SD)")
ax[1].plot(qs, [s_[1] for s_ in sens], "o-", color="C3", label="disease gene set")
ax[1].set_xscale("log"); ax[1].set_xlabel("FDR level q"); ax[1].set_ylabel("largest connected component size")
ax[1].set_title("Disease-module signal is robust to FDR level", fontsize=10); ax[1].legend(fontsize=8)
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。