Example06 / 09
五个常见计算陷阱——自环、重边、孤立点、有向性、权重的含义
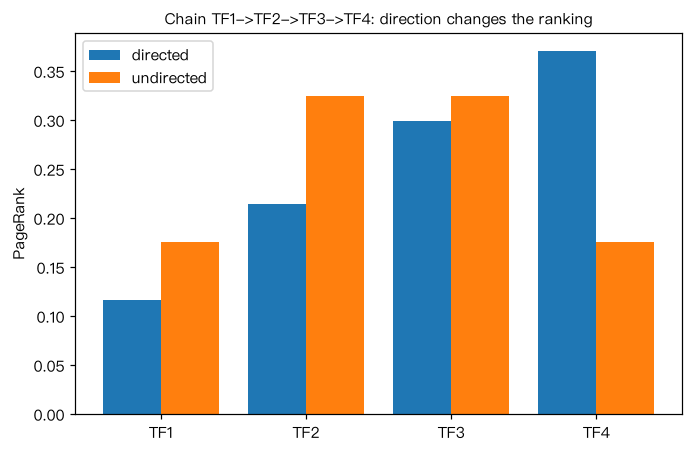
每个陷阱用一个可手算的小图演示“同一个函数、不同输入表示,数值不同”。 解读:(1)自环使度加 2,并影响聚集系数分母;(2)MultiGraph 转 Graph 时重边被合并,权重取最后一条而非求和; (3)孤立点改变平均度和密度,并使平均最短路径报错;(4)有向图的 PageRank 与无向化后不同; (5)最短路径与介数把 weight 当作“距离”,相关系数之类的“相似度”需先取倒数或 -log 变换。
Output输出图
Output文字输出
(1) 节点3的度:无自环 3,有自环 5;自环数 1
(2) A–B 权重:直接转换 2.0,显式求和 3.0;MultiGraph 边数 3 → Graph 边数 2
(3) 平均度:含孤立点 1.00,去除后 1.60;密度 0.143 vs 0.400
    平均最短路径: Graph is not connected.
(4) PageRank(有向): {'TF1': 0.116, 'TF2': 0.215, 'TF3': 0.299, 'TF4': 0.37}
    PageRank(无向化): {'TF1': 0.175, 'TF2': 0.325, 'TF3': 0.325, 'TF4': 0.175}
    弱连通 True,强连通 False
(5) A→C 最短路径:把 r 误当距离 ['A', 'C'];1/r ['A', 'B', 'C'];-log r ['A', 'B', 'C']
B 的介数:误用 r 0.00,用 1/r 1.00Code代码
# 每个陷阱用一个可手算的小图演示“同一个函数、不同输入表示,数值不同”。
# 解读:(1)自环使度加 2,并影响聚集系数分母;(2)MultiGraph 转 Graph 时重边被合并,权重取最后一条而非求和;
# (3)孤立点改变平均度和密度,并使平均最短路径报错;(4)有向图的 PageRank 与无向化后不同;
# (5)最短路径与介数把 weight 当作“距离”,相关系数之类的“相似度”需先取倒数或 -log 变换。
import numpy as np
import networkx as nx

# (1) 自环
G = nx.Graph([(1, 2), (2, 3), (3, 1), (3, 4)])
H = G.copy(); H.add_edge(3, 3)
print("(1) 节点3的度:无自环 %d,有自环 %d;自环数 %d" % (G.degree(3), H.degree(3), nx.number_of_selfloops(H)))
H.remove_edges_from(nx.selfloop_edges(H))

# (2) 重边:两个实验分别报告了 A–B 相互作用
M = nx.MultiGraph()
M.add_edge("A", "B", weight=1.0); M.add_edge("A", "B", weight=2.0); M.add_edge("B", "C", weight=1.0)
G_last = nx.Graph(M)                                           # 直接转换:保留其中一条的属性
G_sum = nx.Graph()
for u, v, d in M.edges(data=True):                             # 显式聚合:权重相加(或计数、取最大)
    w0 = G_sum[u][v]["weight"] if G_sum.has_edge(u, v) else 0.0
    G_sum.add_edge(u, v, weight=w0 + d["weight"])
print("(2) A–B 权重:直接转换 %.1f,显式求和 %.1f;MultiGraph 边数 %d → Graph 边数 %d" % (
    G_last["A"]["B"]["weight"], G_sum["A"]["B"]["weight"], M.number_of_edges(), G_sum.number_of_edges()))

# (3) 孤立点
G = nx.path_graph(5); G.add_nodes_from([10, 11, 12])
print("(3) 平均度:含孤立点 %.2f,去除后 %.2f;密度 %.3f vs %.3f" % (
    2 * G.number_of_edges() / G.number_of_nodes(), 2 * 4 / 5, nx.density(G), nx.density(nx.path_graph(5))))
try:
    nx.average_shortest_path_length(G)
except nx.NetworkXError as e:
    print("    平均最短路径:", e)

# (4) 有向性:调控链 TF1 → TF2 → TF3 → TF4
D = nx.DiGraph([("TF1", "TF2"), ("TF2", "TF3"), ("TF3", "TF4")])
pr_d = nx.pagerank(D); pr_u = nx.pagerank(D.to_undirected())
print("(4) PageRank(有向):", {k: round(v, 3) for k, v in pr_d.items()})
print("    PageRank(无向化):", {k: round(v, 3) for k, v in pr_u.items()})
print("    弱连通 %s,强连通 %s" % (nx.is_weakly_connected(D), nx.is_strongly_connected(D)))

# (5) 权重是相似度还是距离:A–B–C 两条强相关边,A–C 一条弱相关边
S = nx.Graph()
S.add_edge("A", "B", r=0.9); S.add_edge("B", "C", r=0.9); S.add_edge("A", "C", r=0.2)
for u, v, d in S.edges(data=True):
    d["dist_inv"] = 1 / d["r"]                  # 距离 = 1/相似度
    d["dist_log"] = -np.log(d["r"])             # 距离 = -log(相似度),路径长度对应相似度乘积
print("(5) A→C 最短路径:把 r 误当距离 %s;1/r %s;-log r %s" % (
    nx.shortest_path(S, "A", "C", weight="r"), nx.shortest_path(S, "A", "C", weight="dist_inv"),
    nx.shortest_path(S, "A", "C", weight="dist_log")))
print("    B 的介数:误用 r %.2f,用 1/r %.2f" % (
    nx.betweenness_centrality(S, weight="r")["B"], nx.betweenness_centrality(S, weight="dist_inv")["B"]))

# 作图:陷阱 (4)——同一条调控链,有向与无向化后的 PageRank
import matplotlib.pyplot as plt
fig, ax = plt.subplots(figsize=(6.4, 4.2))
tf = list(D.nodes()); x = np.arange(len(tf))
ax.bar(x - 0.2, [pr_d[v] for v in tf], 0.4, label="directed")
ax.bar(x + 0.2, [pr_u[v] for v in tf], 0.4, label="undirected")
ax.set_xticks(x); ax.set_xticklabels(tf); ax.set_ylabel("PageRank"); ax.legend()
ax.set_title("Chain TF1->TF2->TF3->TF4: direction changes the ranking", fontsize=10)
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。