Example10 / 11
样本量与功效——单条边的解析计算、整网边恢复的模拟,以及测量信度造成的衰减
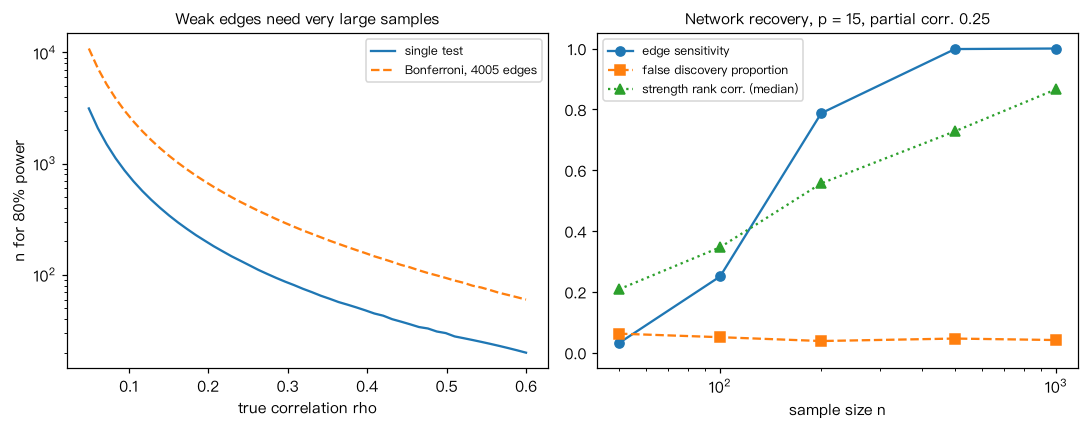
- Fisher z 近似:检测真实相关 ρ(双侧 α)达到功效 1-β 所需 n ≈ ((z_{1-α/2}+z_{1-β}) / artanh ρ)² + 3; 同时给出对 m 条边做 Bonferroni 校正时的 n,并用模拟核对 m=1 时的功效。
- 由已知稀疏精度矩阵(p=15 个变量)生成数据,对每个偏相关做 Fisher z 检验(标准误 1/sqrt(n-(p-2)-3)), BH 校正后统计边的灵敏度、错误发现比例,以及强度中心性与真值的秩相关,观察它们随 n 的变化。
- 信度衰减:观测相关 ≈ 真实相关 × sqrt(信度_x × 信度_y)(Spearman, 1904),低信度会让所需样本量成倍增加。 解读:这些都是在模型假设成立时的乐观估计;真实研究应按自己的网络结构与估计方法做模拟功效分析。
Output输出图
Output文字输出
单条边:检测 ρ 所需样本量(α=0.05 双侧,功效 0.8)
  ρ=0.1: 单次检验 n=  783;对 4005 条边 Bonferroni 校正 n= 2700
  ρ=0.2: 单次检验 n=  194;对 4005 条边 Bonferroni 校正 n=  664
  ρ=0.3: 单次检验 n=   85;对 4005 条边 Bonferroni 校正 n=  287
  ρ=0.5: 单次检验 n=   30;对 4005 条边 Bonferroni 校正 n=   93
模拟核对:ρ=0.3, n=85 时实际功效=0.804

整网:p=15 个变量,17 条真实边,真实偏相关约 0.25
  n=   50: 边灵敏度=0.03  错误发现比例=0.063  强度中心性与真值的秩相关 中位数=0.21
  n=  100: 边灵敏度=0.25  错误发现比例=0.051  强度中心性与真值的秩相关 中位数=0.35
  n=  200: 边灵敏度=0.79  错误发现比例=0.038  强度中心性与真值的秩相关 中位数=0.56
  n=  500: 边灵敏度=1.00  错误发现比例=0.046  强度中心性与真值的秩相关 中位数=0.73
  n= 1000: 边灵敏度=1.00  错误发现比例=0.042  强度中心性与真值的秩相关 中位数=0.87

信度衰减:真实相关 0.3
  两端信度均为 1.0: 期望观测相关=0.300,所需 n=85
  两端信度均为 0.8: 期望观测相关=0.240,所需 n=135
  两端信度均为 0.6: 期望观测相关=0.180,所需 n=240
  两端信度均为 0.4: 期望观测相关=0.120,所需 n=543
Code代码
# (1) Fisher z 近似:检测真实相关 ρ(双侧 α)达到功效 1-β 所需 n ≈ ((z_{1-α/2}+z_{1-β}) / artanh ρ)² + 3;
#     同时给出对 m 条边做 Bonferroni 校正时的 n,并用模拟核对 m=1 时的功效。
# (2) 由已知稀疏精度矩阵(p=15 个变量)生成数据,对每个偏相关做 Fisher z 检验(标准误 1/sqrt(n-(p-2)-3)),
#     BH 校正后统计边的灵敏度、错误发现比例,以及强度中心性与真值的秩相关,观察它们随 n 的变化。
# (3) 信度衰减:观测相关 ≈ 真实相关 × sqrt(信度_x × 信度_y)(Spearman, 1904),低信度会让所需样本量成倍增加。
# 解读:这些都是在模型假设成立时的乐观估计;真实研究应按自己的网络结构与估计方法做模拟功效分析。
import numpy as np
from scipy import stats

def n_required(rho, alpha=0.05, power=0.8, m=1):
    za = stats.norm.ppf(1 - alpha / (2 * m))
    zb = stats.norm.ppf(power)
    return int(np.ceil(((za + zb) / np.arctanh(rho)) ** 2 + 3))

print("单条边:检测 ρ 所需样本量(α=0.05 双侧,功效 0.8)")
for rho in (0.1, 0.2, 0.3, 0.5):
    print(f"  ρ={rho}: 单次检验 n={n_required(rho):5d};"
          f"对 4005 条边 Bonferroni 校正 n={n_required(rho, m=4005):5d}")

rng = np.random.default_rng(41)
rho, n = 0.3, n_required(0.3)
cov = [[1, rho], [rho, 1]]
hits = 0
for _ in range(4000):
    xy = rng.multivariate_normal([0, 0], cov, size=n)
    hits += stats.pearsonr(xy[:, 0], xy[:, 1]).pvalue < 0.05
print(f"模拟核对:ρ=0.3, n={n} 时实际功效={hits / 4000:.3f}")

# (2) 整网边恢复
p = 15
K = np.eye(p)
edges = [(i, i + 1) for i in range(p - 1)] + [(0, 7), (3, 11), (5, 13)]
for i, j in edges:
    K[i, j] = K[j, i] = -0.25
assert np.all(np.linalg.eigvalsh(K) > 0)
Sigma = np.linalg.inv(K)
d = np.sqrt(np.diag(K)); true_pc = -K / np.outer(d, d); np.fill_diagonal(true_pc, 0)
iu = np.triu_indices(p, 1)
truth = true_pc[iu] != 0
true_strength = np.abs(true_pc).sum(axis=1)
print(f"\n整网:p={p} 个变量,{truth.sum()} 条真实边,真实偏相关约 {np.abs(true_pc[iu][truth]).mean():.2f}")
curve = []                                     # 保存整网恢复结果用于作图
for n in (50, 100, 200, 500, 1000):
    sens, fdp, rs = [], [], []
    for _ in range(200):
        X = rng.multivariate_normal(np.zeros(p), Sigma, size=n)
        P = np.linalg.inv(np.cov(X, rowvar=False))
        dd = np.sqrt(np.diag(P)); W = -P / np.outer(dd, dd); np.fill_diagonal(W, 0)
        z = np.arctanh(W[iu]) * np.sqrt(n - (p - 2) - 3)
        pv = 2 * stats.norm.sf(np.abs(z))
        # BH
        o = np.argsort(pv); ok = pv[o] <= 0.05 * np.arange(1, len(pv) + 1) / len(pv)
        k = ok.nonzero()[0].max() + 1 if ok.any() else 0
        sig = np.zeros(len(pv), bool); sig[o[:k]] = True
        sens.append(sig[truth].mean())
        fdp.append((sig & ~truth).sum() / max(sig.sum(), 1))
        rs.append(stats.spearmanr(np.abs(W).sum(axis=1), true_strength)[0])
    print(f"  n={n:5d}: 边灵敏度={np.mean(sens):.2f}  错误发现比例={np.mean(fdp):.3f}  "
          f"强度中心性与真值的秩相关 中位数={np.median(rs):.2f}")
    curve.append((n, np.mean(sens), np.mean(fdp), np.median(rs)))

# (3) 信度衰减
print("\n信度衰减:真实相关 0.3")
for rel in (1.0, 0.8, 0.6, 0.4):
    r_obs = 0.3 * np.sqrt(rel * rel)
    print(f"  两端信度均为 {rel}: 期望观测相关={r_obs:.3f},所需 n={n_required(r_obs)}")

# 作图:所需样本量随真实相关变化(单次检验 vs Bonferroni);整网边恢复随 n 的变化
import matplotlib.pyplot as plt
fig, ax = plt.subplots(1, 2, figsize=(10, 4))
rhos = np.linspace(0.05, 0.6, 50)
ax[0].plot(rhos, [n_required(r_) for r_ in rhos], "-", label="single test")
ax[0].plot(rhos, [n_required(r_, m=4005) for r_ in rhos], "--", label="Bonferroni, 4005 edges")
ax[0].set_yscale("log"); ax[0].set_xlabel("true correlation rho"); ax[0].set_ylabel("n for 80% power")
ax[0].set_title("Weak edges need very large samples", fontsize=10); ax[0].legend(fontsize=8)
cv = np.array(curve)
ax[1].plot(cv[:, 0], cv[:, 1], "o-", label="edge sensitivity")
ax[1].plot(cv[:, 0], cv[:, 2], "s--", label="false discovery proportion")
ax[1].plot(cv[:, 0], cv[:, 3], "^:", label="strength rank corr. (median)")
ax[1].set_xscale("log"); ax[1].set_xlabel("sample size n"); ax[1].set_ylim(-0.05, 1.05)
ax[1].set_title("Network recovery, p = 15, partial corr. 0.25", fontsize=10); ax[1].legend(fontsize=8)
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。