Example11 / 11
比较两张网络——已知节点对应的距离、谱距离、WL 图核,以及基于距离的置换检验
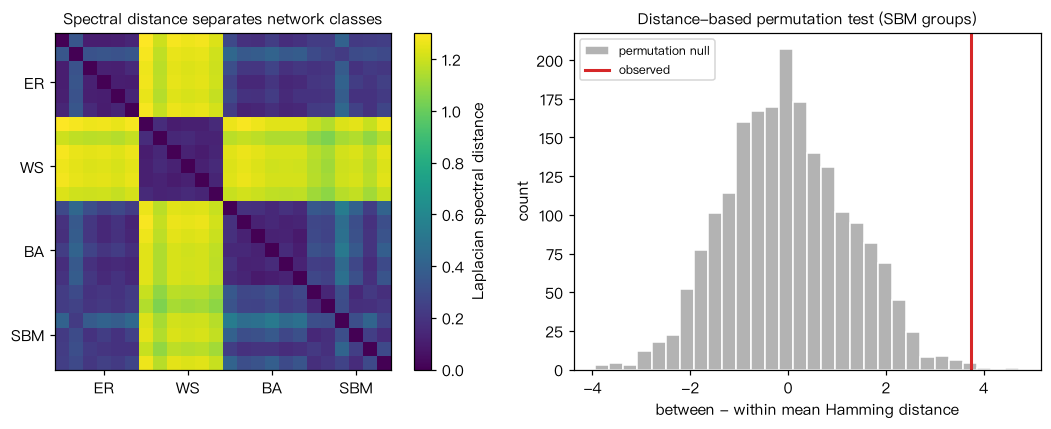
生成 4 类网络(N=100、边数相同):ER、Watts–Strogatz、Barabási–Albert、随机块模型(SBM),每类 6 个实例。 距离:(a) Jaccard 边距离(需要节点对应);(b) 归一化拉普拉斯谱距离(不需要对应); (c) 度分布的 Jensen–Shannon 散度;(d) Weisfeiler–Lehman(WL)子树特征的余弦距离(一种图核)。 用“类内平均距离 / 类间平均距离”衡量每种距离区分网络类型的能力(越小越好)。 最后对两组“被试网络”做基于距离的置换检验:统计量 = 组间平均距离 − 组内平均距离。 解读:节点无对应时,Jaccard 距离只在 WS 这类“共享格点骨架”的网络之间较小,对同类随机网络接近 1,不适用;谱距离、度分布与 WL 核关注的结构层次不同, 应按研究问题选择,并像任何检验统计量一样配合置换或零模型使用。
Output输出图
Output文字输出
距离        类内均值  类间均值  类内/类间
Jaccard       0.787     0.958      0.82
拉普拉斯谱         0.176     0.737      0.24
度分布JS         0.183     0.404      0.45
WL核           0.097     0.379      0.26
拉普拉斯谱距离的类间矩阵(行、列为 ER/WS/BA/SBM):
[[0.16 1.24 0.23 0.25]
 [1.24 0.11 1.22 1.17]
 [0.23 1.22 0.12 0.32]
 [0.25 1.17 0.32 0.2 ]]
组间−组内平均汉明距离=3.7,置换 p=0.0025
Code代码
# 生成 4 类网络(N=100、边数相同):ER、Watts–Strogatz、Barabási–Albert、随机块模型(SBM),每类 6 个实例。
# 距离:(a) Jaccard 边距离(需要节点对应);(b) 归一化拉普拉斯谱距离(不需要对应);
#       (c) 度分布的 Jensen–Shannon 散度;(d) Weisfeiler–Lehman(WL)子树特征的余弦距离(一种图核)。
# 用“类内平均距离 / 类间平均距离”衡量每种距离区分网络类型的能力(越小越好)。
# 最后对两组“被试网络”做基于距离的置换检验:统计量 = 组间平均距离 − 组内平均距离。
# 解读:节点无对应时,Jaccard 距离只在 WS 这类“共享格点骨架”的网络之间较小,对同类随机网络接近 1,不适用;谱距离、度分布与 WL 核关注的结构层次不同,
# 应按研究问题选择,并像任何检验统计量一样配合置换或零模型使用。
import numpy as np
import networkx as nx
from collections import Counter
from scipy.spatial.distance import jensenshannon

N, k = 100, 6
m = N * k // 2

def make(kind, s):
    if kind == "ER":
        return nx.gnm_random_graph(N, m, seed=s)
    if kind == "WS":
        return nx.watts_strogatz_graph(N, k, 0.1, seed=s)
    if kind == "BA":
        return nx.barabasi_albert_graph(N, k // 2, seed=s)
    sizes = [25] * 4                                    # SBM:4 个模块,块内连接更密
    pin = 0.17; pout = (2 * m / N - 24 * pin) / 75
    return nx.stochastic_block_model(sizes, [[pin if i == j else pout for j in range(4)] for i in range(4)], seed=s)

def jaccard(G, H):
    a, b = set(map(frozenset, G.edges())), set(map(frozenset, H.edges()))
    return 1 - len(a & b) / len(a | b)

def lap_spec(G):
    return np.sort(np.linalg.eigvalsh(nx.normalized_laplacian_matrix(G).toarray()))

def degree_js(G, H, kmax=60):
    def pk(G):
        c = np.bincount([d for _, d in G.degree()], minlength=kmax + 1)[:kmax + 1]
        return c / c.sum()
    return jensenshannon(pk(G), pk(H))

def wl_features(G, it=2):
    """WL 子树特征:所有节点初始标签相同,第 1 轮标签等价于度,第 2 轮编码“邻居度的多重集”。
    迭代轮数越多特征越细,随机网络之间几乎不再共享特征,距离趋近 1。"""
    G = G.copy()
    nx.set_node_attributes(G, {v: "0" for v in G}, "lab")
    h = nx.weisfeiler_lehman_subgraph_hashes(G, node_attr="lab", iterations=it)
    return Counter(x for hs in h.values() for x in hs)

def wl_dist(fa, fb):
    keys = set(fa) | set(fb)
    a = np.array([fa.get(x, 0) for x in keys], float); b = np.array([fb.get(x, 0) for x in keys], float)
    return 1 - a @ b / np.linalg.norm(a) / np.linalg.norm(b)

kinds = ["ER", "WS", "BA", "SBM"]
graphs = [(kd, make(kd, 10 * i + j)) for i, kd in enumerate(kinds) for j in range(6)]
specs = [lap_spec(G) for _, G in graphs]
wls = [wl_features(G) for _, G in graphs]
n = len(graphs)
D = {name: np.zeros((n, n)) for name in ("Jaccard", "拉普拉斯谱", "度分布JS", "WL核")}
for a in range(n):
    for b in range(a + 1, n):
        Ga, Gb = graphs[a][1], graphs[b][1]
        vals = {"Jaccard": jaccard(Ga, Gb), "拉普拉斯谱": np.linalg.norm(specs[a] - specs[b]),
                "度分布JS": degree_js(Ga, Gb), "WL核": wl_dist(wls[a], wls[b])}
        for name, v in vals.items():
            D[name][a, b] = D[name][b, a] = v

lab = np.array([kd for kd, _ in graphs])
same = (lab[:, None] == lab[None, :]) & ~np.eye(n, dtype=bool)
diff = lab[:, None] != lab[None, :]
print("距离        类内均值  类间均值  类内/类间")
for name, M in D.items():
    print(f"{name:<10} {M[same].mean():8.3f}  {M[diff].mean():8.3f}  {M[same].mean() / M[diff].mean():8.2f}")
print("拉普拉斯谱距离的类间矩阵(行、列为 ER/WS/BA/SBM):")
blk = np.array([[D['拉普拉斯谱'][np.ix_(lab == x, lab == y)].mean() for y in kinds] for x in kinds])
print(np.round(blk, 2))

# 基于距离的置换检验:两组各 12 个“被试网络”,节点对应已知;B 组模块内连接略强
rng = np.random.default_rng(51)
def subject(pin):
    pout = (2 * m / N - 24 * pin) / 75
    return nx.stochastic_block_model([25] * 4, [[pin if i == j else pout for j in range(4)] for i in range(4)],
                                     seed=int(rng.integers(1e9)))
subs = [subject(0.15) for _ in range(12)] + [subject(0.18) for _ in range(12)]
g = np.r_[np.zeros(12), np.ones(12)].astype(int)
A = np.array([nx.to_numpy_array(G, nodelist=range(N))[np.triu_indices(N, 1)] for G in subs])
Dm = np.array([[np.abs(x - y).sum() for y in A] for x in A])          # 汉明距离(边集合的对称差大小)
def stat(g):
    w = g[:, None] == g[None, :]
    off = ~np.eye(len(g), dtype=bool)
    return Dm[~w].mean() - Dm[w & off].mean()
s0 = stat(g)
null = np.array([stat(rng.permutation(g)) for _ in range(2000)])
print(f"组间−组内平均汉明距离={s0:.1f},置换 p={(1 + np.sum(null >= s0)) / 2001:.4f}")

# 作图:24 个网络两两之间的拉普拉斯谱距离矩阵;基于距离的置换检验零分布
import matplotlib.pyplot as plt
fig, ax = plt.subplots(1, 2, figsize=(10, 4))
im = ax[0].imshow(D["拉普拉斯谱"], cmap="viridis")
ax[0].set_xticks(np.arange(3, n, 6)); ax[0].set_xticklabels(kinds)
ax[0].set_yticks(np.arange(3, n, 6)); ax[0].set_yticklabels(kinds)
fig.colorbar(im, ax=ax[0], label="Laplacian spectral distance")
ax[0].set_title("Spectral distance separates network classes", fontsize=10)
ax[1].hist(null, bins=30, color="0.7", edgecolor="white", label="permutation null")
ax[1].axvline(s0, color="C3", lw=2, label="observed")
ax[1].set_xlabel("between - within mean Hamming distance"); ax[1].set_ylabel("count"); ax[1].legend(fontsize=8)
ax[1].set_title("Distance-based permutation test (SBM groups)", fontsize=10)
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。