Example02 / 11
保度随机化(双边交换)零模型、z 分数与经验 p 值
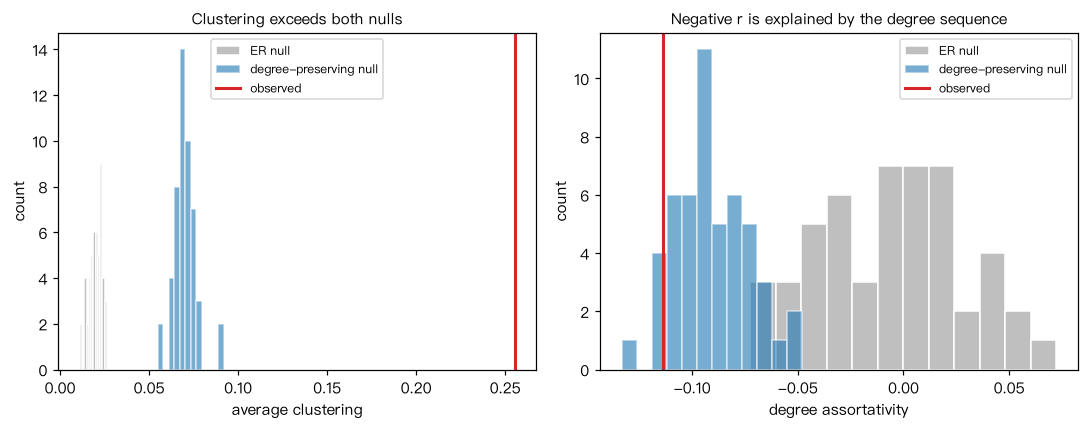
自己实现 Maslov–Sneppen 双边交换,检查度序列严格不变;再生成 M 个保度随机网络和 M 个 ER 网络, 对平均聚集系数和度同配系数计算 z 分数与经验 p 值 p = (1 + #{零模型 >= 观测}) / (M + 1)。 解读:ER 只保留节点数和边数,保度零模型还保留度序列;同一观测值对两种零模型的 z 分数可能相差很大, 结论只能说“超出了该零模型所保留的性质能解释的范围”。本例中负的度同配相对 ER 显著, 相对保度零模型则不显著:它大部分可由度序列本身(简单图中枢纽之间可连的边有限)解释。
Output输出图
Output文字输出
交换接受率=0.86;度序列保持=True;每个节点的度保持=True
平均聚集系数: 观测=0.255  ER零模型 均值=0.020 标准差=0.004  z=64.1  经验p=0.020(M=50 时最小可能值为 0.020)
平均聚集系数: 观测=0.255  保度零模型 均值=0.070 标准差=0.007  z=28.0  经验p=0.020(M=50 时最小可能值为 0.020)
度同配系数: 观测=-0.114  ER零模型 均值=-0.006 标准差=0.035  z=-3.1  经验p=0.020(M=50 时最小可能值为 0.020)
度同配系数: 观测=-0.114  保度零模型 均值=-0.091 标准差=0.018  z=-1.3  经验p=0.216(M=50 时最小可能值为 0.020)
Code代码
# 自己实现 Maslov–Sneppen 双边交换,检查度序列严格不变;再生成 M 个保度随机网络和 M 个 ER 网络,
# 对平均聚集系数和度同配系数计算 z 分数与经验 p 值 p = (1 + #{零模型 >= 观测}) / (M + 1)。
# 解读:ER 只保留节点数和边数,保度零模型还保留度序列;同一观测值对两种零模型的 z 分数可能相差很大,
# 结论只能说“超出了该零模型所保留的性质能解释的范围”。本例中负的度同配相对 ER 显著,
# 相对保度零模型则不显著:它大部分可由度序列本身(简单图中枢纽之间可连的边有限)解释。
import numpy as np
import networkx as nx

def degree_preserving_rewire(G, n_swap_per_edge=10, seed=0):
    """Maslov–Sneppen 双边交换:(a,b),(c,d) -> (a,d),(c,b)。拒绝产生自环或重边的交换。"""
    rng = np.random.default_rng(seed)
    edges = [tuple(e) for e in G.edges()]
    eset = set(frozenset(e) for e in edges)
    m = len(edges)
    n_try, n_ok = n_swap_per_edge * m, 0
    for _ in range(n_try):
        i, j = rng.integers(m, size=2)
        if i == j:
            continue
        a, b = edges[i]
        c, d = edges[j]
        if rng.random() < 0.5:                 # 两种重连方式各占一半
            c, d = d, c
        if len({a, b, c, d}) < 4:
            continue
        e1, e2 = frozenset((a, d)), frozenset((c, b))
        if e1 in eset or e2 in eset:
            continue
        eset -= {frozenset((a, b)), frozenset((c, d))}
        eset |= {e1, e2}
        edges[i], edges[j] = (a, d), (c, b)
        n_ok += 1
    H = nx.Graph()
    H.add_nodes_from(G.nodes())
    H.add_edges_from(edges)
    return H, n_ok / n_try

# 观测网络:一个带三角形闭合倾向的重尾网络(模拟的“相互作用网络”)
G = nx.powerlaw_cluster_graph(300, 3, 0.4, seed=2)
n, m = G.number_of_nodes(), G.number_of_edges()
obs = {"平均聚集系数": nx.average_clustering(G),
       "度同配系数": nx.degree_assortativity_coefficient(G)}

H, acc = degree_preserving_rewire(G, seed=0)
same_deg = sorted(d for _, d in G.degree()) == sorted(d for _, d in H.degree())
same_node_deg = all(G.degree(v) == H.degree(v) for v in G)
print(f"交换接受率={acc:.2f};度序列保持={same_deg};每个节点的度保持={same_node_deg}")

M = 50
null = {"ER": {k: [] for k in obs}, "保度": {k: [] for k in obs}}
for s in range(M):
    ER = nx.gnm_random_graph(n, m, seed=100 + s)
    DP, _ = degree_preserving_rewire(G, seed=200 + s)
    for name, Hs in (("ER", ER), ("保度", DP)):
        null[name]["平均聚集系数"].append(nx.average_clustering(Hs))
        null[name]["度同配系数"].append(nx.degree_assortativity_coefficient(Hs))

for k, x in obs.items():
    for name in ("ER", "保度"):
        v = np.array(null[name][k])
        z = (x - v.mean()) / v.std(ddof=1)
        # 双侧经验 p 值:以零分布均值为中心比较偏离幅度
        p = (1 + np.sum(np.abs(v - v.mean()) >= abs(x - v.mean()))) / (M + 1)
        print(f"{k}: 观测={x:.3f}  {name}零模型 均值={v.mean():.3f} 标准差={v.std(ddof=1):.3f}  "
              f"z={z:.1f}  经验p={p:.3f}(M={M} 时最小可能值为 {1/(M+1):.3f})")

# 作图:两种零模型下的零分布与观测值
import matplotlib.pyplot as plt
fig, ax = plt.subplots(1, 2, figsize=(10, 4))
for a, k, xl in zip(ax, ["平均聚集系数", "度同配系数"], ["average clustering", "degree assortativity"]):
    a.hist(null["ER"][k], bins=12, color="0.75", edgecolor="white", label="ER null")
    a.hist(null["保度"][k], bins=12, color="C0", alpha=0.6, edgecolor="white", label="degree-preserving null")
    a.axvline(obs[k], color="C3", lw=2, label="observed")
    a.set_xlabel(xl); a.set_ylabel("count"); a.legend(fontsize=8)
ax[0].set_title("Clustering exceeds both nulls", fontsize=10)
ax[1].set_title("Negative r is explained by the degree sequence", fontsize=10)
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。