Example10 / 10
初始吸引力与内部连边如何改变度指数
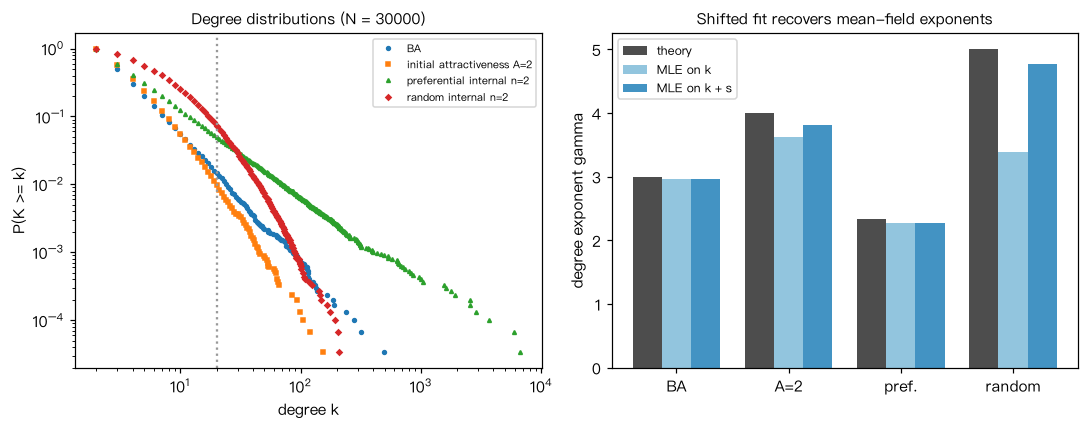
用平均场结论检验三种 BA 变体(每步新节点带 m=2 条边,最终 N=30000): (a) 初始吸引力 Π ∝ k + A,A=2: 理论 γ = 3 + A/m = 4 (b) 每步另加 n=2 条“双优先”内部边(两端都按度选择):理论 γ = 2 + m/(m+2n) ≈ 2.33 (c) 每步另加 n=2 条两端随机的内部边:理论 γ = 3 + 2n/m = 5 用 MLE(离散近似,k_min=20)估计 γ。平均场解的度分布其实是“平移幂律” P(k) ∝ (k+s)^-γ, 直接对 k 拟合会低估 γ,对 k+s 拟合则接近理论值——这也说明有限数据上“读出的指数”依赖于拟合形式。为了高效,用“边端点列表”抽样实现按度成比例的选择。 输出:直接 MLE 的排序与理论一致(b < BA < a < c)但 a、c 明显偏低;平移后的估计更接近理论值。
Output输出图
Output文字输出
BA           理论 γ=3.00 | 直接 MLE γ=2.97 | 平移 s=0 后 MLE γ=2.97 | k_max=491
初始吸引力 A=2    理论 γ=4.00 | 直接 MLE γ=3.62 | 平移 s=2 后 MLE γ=3.81 | k_max=153
双优先内部边 n=2   理论 γ=2.33 | 直接 MLE γ=2.26 | 平移 s=0 后 MLE γ=2.26 | k_max=6703
随机内部边 n=2    理论 γ=5.00 | 直接 MLE γ=3.39 | 平移 s=16 后 MLE γ=4.77 | k_max=207
Code代码
# 用平均场结论检验三种 BA 变体(每步新节点带 m=2 条边,最终 N=30000):
#   (a) 初始吸引力 Π ∝ k + A,A=2:  理论 γ = 3 + A/m = 4
#   (b) 每步另加 n=2 条“双优先”内部边(两端都按度选择):理论 γ = 2 + m/(m+2n) ≈ 2.33
#   (c) 每步另加 n=2 条两端随机的内部边:理论 γ = 3 + 2n/m = 5
# 用 MLE(离散近似,k_min=20)估计 γ。平均场解的度分布其实是“平移幂律” P(k) ∝ (k+s)^-γ,
# 直接对 k 拟合会低估 γ,对 k+s 拟合则接近理论值——这也说明有限数据上“读出的指数”依赖于拟合形式。为了高效,用“边端点列表”抽样实现按度成比例的选择。
# 输出:直接 MLE 的排序与理论一致(b < BA < a < c)但 a、c 明显偏低;平移后的估计更接近理论值。
import numpy as np


def simulate(N, m, A=0.0, n_int=0, internal="none", seed=0):
    rng = np.random.default_rng(seed)
    deg = np.zeros(N, dtype=np.int64)
    ends = []                                  # 每条边的两个端点都记一次:均匀抽一个元素 = 按度抽节点
    for i in range(m + 1):
        for j in range(i + 1, m + 1):
            ends += [i, j]
            deg[i] += 1; deg[j] += 1
    for t in range(m + 1, N):
        for _ in range(m):
            # 以概率 (Σk)/(Σk + A t) 按度选,否则均匀选:合起来即 Π ∝ k + A
            if A > 0 and rng.random() < A * t / (len(ends) + A * t):
                v = int(rng.integers(t))
            else:
                v = ends[rng.integers(len(ends))]
            deg[v] += 1; ends.append(v)
        deg[t] += m; ends += [t] * m
        for _ in range(n_int):
            if internal == "pref":
                a, b = ends[rng.integers(len(ends))], ends[rng.integers(len(ends))]
            else:
                a, b = rng.integers(t + 1), rng.integers(t + 1)
            deg[a] += 1; deg[b] += 1; ends += [int(a), int(b)]
    return deg


def gamma_mle(k, kmin, shift=0.0):
    """离散近似 MLE;shift>0 时对平移变量 k+shift 拟合,对应 P(k) ∝ (k+shift)^-γ。"""
    kk = k[k >= kmin].astype(float) + shift
    return 1 + len(kk) / np.sum(np.log(kk / (kmin + shift - 0.5)))


N, m = 30000, 2
n = 2
# 平均场给出的平移量:Π∝k+A 时 k_i+A ∝ t^β;随机内部边时 k_i + 4n(m+n)/m ∝ t^β
cases = [("BA", dict(), 3.0, 0.0),
         ("初始吸引力 A=2", dict(A=2.0), 3 + 2 / m, 2.0),
         ("双优先内部边 n=2", dict(n_int=n, internal="pref"), 2 + m / (m + 2 * n), 0.0),
         ("随机内部边 n=2", dict(n_int=n, internal="rand"), 3 + 2 * n / m, 4 * n * (m + n) / m)]
kmin = 20
sims = []                                      # 存下结果用于作图
for name, kw, theory, s in cases:
    k = simulate(N, m, seed=11, **kw)
    sims.append((k, theory, gamma_mle(k, kmin), gamma_mle(k, kmin, s)))
    print("%-12s 理论 γ=%.2f | 直接 MLE γ=%.2f | 平移 s=%g 后 MLE γ=%.2f | k_max=%d"
          % (name, theory, gamma_mle(k, kmin), s, gamma_mle(k, kmin, s), k.max()))

# 作图:左为四种变体的度分布 CCDF;右为理论 γ 与两种 MLE 估计的对比
import matplotlib.pyplot as plt

names_en = ["BA", "initial attractiveness A=2", "preferential internal n=2", "random internal n=2"]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10, 4))
for (k, th, g0, g1), lab, mk in zip(sims, names_en, ["o", "s", "^", "D"]):
    xs = np.sort(np.unique(k))
    ax1.loglog(xs, [(k >= x).mean() for x in xs], mk, ms=2.5, label=lab)
ax1.axvline(kmin, color="0.6", ls=":")
ax1.set_xlabel("degree k"); ax1.set_ylabel("P(K >= k)"); ax1.legend(fontsize=7)
ax1.set_title("Degree distributions (N = %d)" % N, fontsize=10)
x = np.arange(len(sims))
for j, (lab, col) in enumerate([("theory", "0.3"), ("MLE on k", "#92c5de"), ("MLE on k + s", "#4393c3")]):
    ax2.bar(x + (j - 1) * 0.26, [r[j + 1] for r in sims], 0.26, color=col, label=lab)
ax2.set_xticks(x); ax2.set_xticklabels(["BA", "A=2", "pref.", "random"])
ax2.set_ylabel("degree exponent gamma"); ax2.legend(fontsize=8)
ax2.set_title("Shifted fit recovers mean-field exponents", fontsize=10)
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。