Example05 / 10
加权脑网络指标与权重归一化
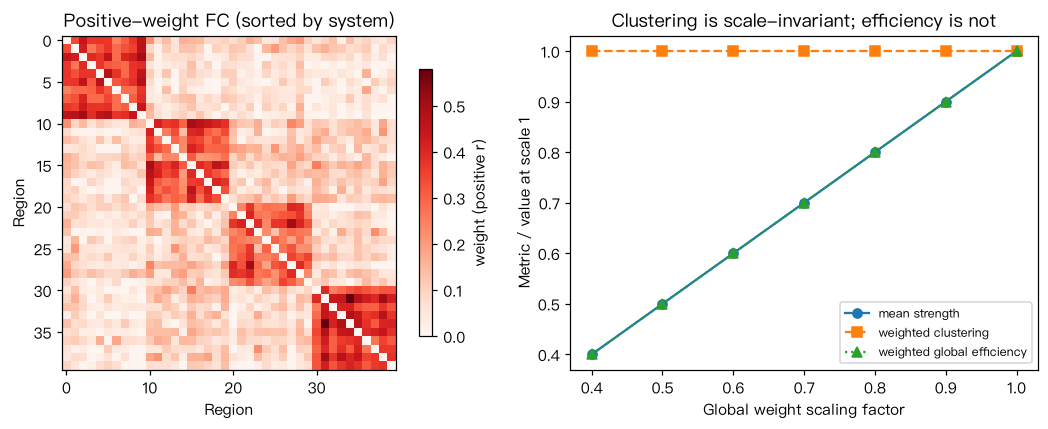
用模拟的 4 系统功能连接矩阵(只保留正相关)构建加权网络,比较: 强度 s_i、Onnela 加权聚集系数(networkx 的 clustering(weight=…) 即此定义,权重先除以最大权重)、 加权全局效率(边长取 1/w,Dijkstra 最短路径),以及“对所有权重乘同一常数”后各指标是否改变。 输出解读:加权聚集系数对整体缩放不变(已按最大权重归一化);加权效率随整体缩放成比例变化, 因此组间比较加权效率前要决定是否归一化(如除以最大权重或与保持强度的零模型之比),否则“效率差异”可能只是整体 FC 强度差异。
Output输出图
Output文字输出
整体缩放 ×1.0: 平均强度 = 5.473,加权聚集 = 0.1965,加权全局效率 = 0.1728
整体缩放 ×0.7: 平均强度 = 3.831,加权聚集 = 0.1965,加权全局效率 = 0.1210
强度最高的 5 个节点: [15, 10, 31, 0, 35]
提示:权重整体乘 0.7,效率也乘 0.7;聚集系数不变。
Code代码
# 用模拟的 4 系统功能连接矩阵(只保留正相关)构建加权网络,比较:
# 强度 s_i、Onnela 加权聚集系数(networkx 的 clustering(weight=...) 即此定义,权重先除以最大权重)、
# 加权全局效率(边长取 1/w,Dijkstra 最短路径),以及“对所有权重乘同一常数”后各指标是否改变。
# 输出解读:加权聚集系数对整体缩放不变(已按最大权重归一化);加权效率随整体缩放成比例变化,
# 因此组间比较加权效率前要决定是否归一化(如除以最大权重或与保持强度的零模型之比),否则“效率差异”可能只是整体 FC 强度差异。
import numpy as np
import networkx as nx

def simulate_fc(n_mod=4, per=10, T=300, seed=0):
    rng = np.random.default_rng(seed)        # 模拟数据,仅用于演示方法
    labels = np.repeat(np.arange(n_mod), per)
    sys_sig = rng.standard_normal((n_mod, T))
    load = rng.uniform(0.4, 1.0, size=n_mod * per)
    X = load[:, None] * sys_sig[labels] + 0.3 * rng.standard_normal(T) + rng.standard_normal((n_mod * per, T))
    return np.corrcoef(X), labels

def weighted_graph(W):
    G = nx.Graph()
    N = W.shape[0]
    G.add_nodes_from(range(N))
    for i in range(N):
        for j in range(i + 1, N):
            if W[i, j] > 0:
                G.add_edge(i, j, weight=W[i, j], length=1.0 / W[i, j])
    return G

def weighted_global_efficiency(G):
    N = G.number_of_nodes()
    tot = 0.0
    for i, dist in nx.all_pairs_dijkstra_path_length(G, weight="length"):
        tot += sum(1.0 / d for j, d in dist.items() if j != i)
    return tot / (N * (N - 1))

R, labels = simulate_fc()
W = np.clip(R, 0, None)                       # 只保留正权(负权需另行处理)
np.fill_diagonal(W, 0)

for scale in [1.0, 0.7]:                      # 0.7:模拟整体 FC 减弱 30% 的“另一组”
    G = weighted_graph(scale * W)
    s = np.array([d for _, d in G.degree(weight="weight")])
    Cw = nx.average_clustering(G, weight="weight")
    Ew = weighted_global_efficiency(G)
    print(f"整体缩放 ×{scale}: 平均强度 = {s.mean():.3f},加权聚集 = {Cw:.4f},加权全局效率 = {Ew:.4f}")

G = weighted_graph(W)
s = np.array([d for _, d in G.degree(weight="weight")])
print("强度最高的 5 个节点:", np.argsort(s)[::-1][:5].tolist())
print("提示:权重整体乘 0.7,效率也乘 0.7;聚集系数不变。")

import matplotlib.pyplot as plt
scales = np.linspace(0.4, 1.0, 7)
met = []
for sc in scales:
    Gs = weighted_graph(sc * W)
    met.append([np.mean([d for _, d in Gs.degree(weight="weight")]),
                nx.average_clustering(Gs, weight="weight"), weighted_global_efficiency(Gs)])
met = np.array(met) / np.array(met)[-1]
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
im = axes[0].imshow(W, cmap="Reds", vmin=0)
fig.colorbar(im, ax=axes[0], shrink=0.8, label="weight (positive r)")
axes[0].set(title="Positive-weight FC (sorted by system)", xlabel="Region", ylabel="Region")
for k, (mk, ls, lab) in enumerate([("o", "-", "mean strength"), ("s", "--", "weighted clustering"),
                                   ("^", ":", "weighted global efficiency")]):
    axes[1].plot(scales, met[:, k], marker=mk, ls=ls, label=lab)
axes[1].set(xlabel="Global weight scaling factor", ylabel="Metric / value at scale 1",
            title="Clustering is scale-invariant; efficiency is not")
axes[1].legend(fontsize=8)
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。