Example03 / 08
替代解释——组间差异来自“结构不同”还是“连接整体变弱”
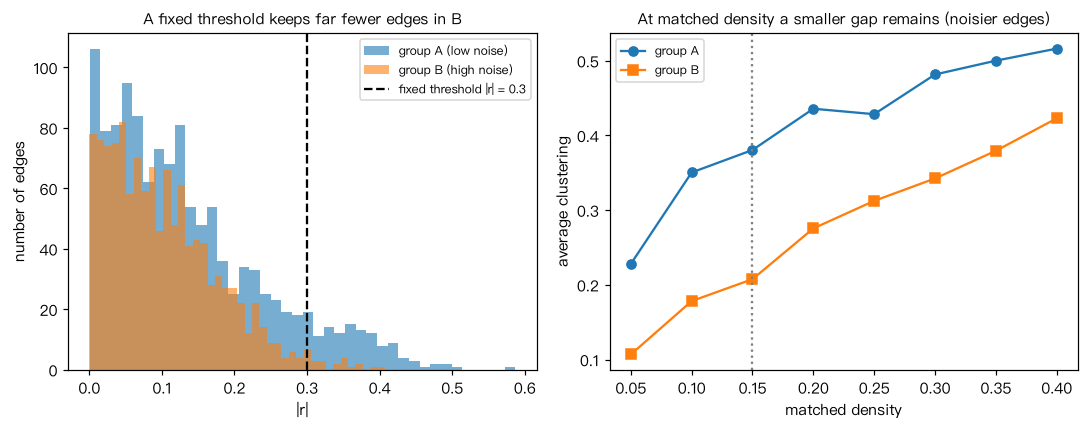
模拟两组数据:潜在结构完全相同,只是 B 组测量噪声更大(类似头动或批次差异)。 先用固定阈值 |r| > 0.3 比较两组的密度和平均聚集系数,再改为两组都取相同密度(15%)比较。 解读:固定阈值下的大差异主要来自 B 组相关整体变弱、网络更稀疏;密度匹配消除了这一部分, 但噪声还会让“哪些边最强”的估计变得不准,使聚集系数仍然偏低。因此“B 组网络聚集性更低” 至少有两个替代解释(密度差异、测量质量差异),需要分别排查:例如扫描多个密度并报告曲线、 把测量质量指标(如头动)作为协变量,或在质量匹配的子样本中重复分析。
Output输出图
Output文字输出
A 组(噪声小): 固定阈值 |r|>0.3 → 密度 0.097, 平均聚集系数 0.327 | 密度匹配 15% → 密度 0.150, 平均聚集系数 0.380
B 组(噪声大): 固定阈值 |r|>0.3 → 密度 0.017, 平均聚集系数 0.063 | 密度匹配 15% → 密度 0.150, 平均聚集系数 0.208
Code代码
# 模拟两组数据:潜在结构完全相同,只是 B 组测量噪声更大(类似头动或批次差异)。
# 先用固定阈值 |r| > 0.3 比较两组的密度和平均聚集系数,再改为两组都取相同密度(15%)比较。
# 解读:固定阈值下的大差异主要来自 B 组相关整体变弱、网络更稀疏;密度匹配消除了这一部分,
# 但噪声还会让“哪些边最强”的估计变得不准,使聚集系数仍然偏低。因此“B 组网络聚集性更低”
# 至少有两个替代解释(密度差异、测量质量差异),需要分别排查:例如扫描多个密度并报告曲线、
# 把测量质量指标(如头动)作为协变量,或在质量匹配的子样本中重复分析。
import numpy as np
import networkx as nx

def group_corr(noise, n_samples=80, n_nodes=50, seed=0):
    """两组共享同一潜在结构,只有噪声水平不同(模拟数据)。"""
    rng = np.random.default_rng(1000 + seed)
    struct = np.random.default_rng(15)                  # 两组共享同一潜在结构
    L = struct.uniform(0, 0.8, size=(n_nodes, 3)) * (struct.random((n_nodes, 3)) < 0.5)
    F = rng.normal(size=(n_samples, 3))
    X = F @ L.T + noise * rng.normal(size=(n_samples, n_nodes))
    return np.corrcoef(X.T)

def net_threshold(C, r):
    A = (np.abs(C) > r).astype(int); np.fill_diagonal(A, 0)
    return nx.from_numpy_array(A)

def net_density(C, density):
    n = C.shape[0]; iu = np.triu_indices(n, 1)
    keep = np.argsort(-np.abs(C[iu]))[:int(round(density * len(iu[0])))]
    G = nx.Graph(); G.add_nodes_from(range(n)); G.add_edges_from(zip(iu[0][keep], iu[1][keep]))
    return G

CA, CB = group_corr(noise=1.0, seed=1), group_corr(noise=1.6, seed=2)
for name, C in [("A 组(噪声小)", CA), ("B 组(噪声大)", CB)]:
    G1, G2 = net_threshold(C, 0.3), net_density(C, 0.15)
    print(f"{name}: 固定阈值 |r|>0.3 → 密度 {nx.density(G1):.3f}, 平均聚集系数 {nx.average_clustering(G1):.3f} | "
          f"密度匹配 15% → 密度 {nx.density(G2):.3f}, 平均聚集系数 {nx.average_clustering(G2):.3f}")

# 作图:两组 |r| 的分布与固定阈值;在一串密度上比较平均聚集系数
import matplotlib.pyplot as plt
fig, ax = plt.subplots(1, 2, figsize=(10, 4))
iu = np.triu_indices(CA.shape[0], 1)
ax[0].hist(np.abs(CA[iu]), bins=40, alpha=0.6, label="group A (low noise)")
ax[0].hist(np.abs(CB[iu]), bins=40, alpha=0.6, label="group B (high noise)")
ax[0].axvline(0.3, color="k", ls="--", label="fixed threshold |r| = 0.3")
ax[0].set_xlabel("|r|"); ax[0].set_ylabel("number of edges"); ax[0].legend(fontsize=8)
ax[0].set_title("A fixed threshold keeps far fewer edges in B", fontsize=10)
dens = np.arange(0.05, 0.41, 0.05)
for C, lab, mk in [(CA, "group A", "o"), (CB, "group B", "s")]:
    ax[1].plot(dens, [nx.average_clustering(net_density(C, d)) for d in dens], marker=mk, label=lab)
ax[1].axvline(0.15, color="gray", ls=":")
ax[1].set_xlabel("matched density"); ax[1].set_ylabel("average clustering"); ax[1].legend(fontsize=8)
ax[1].set_title("At matched density a smaller gap remains (noisier edges)", fontsize=10)
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。