Example06 / 08
随机种子与蒙特卡洛误差——零模型 z 分数和置换 p 值本身也是估计量
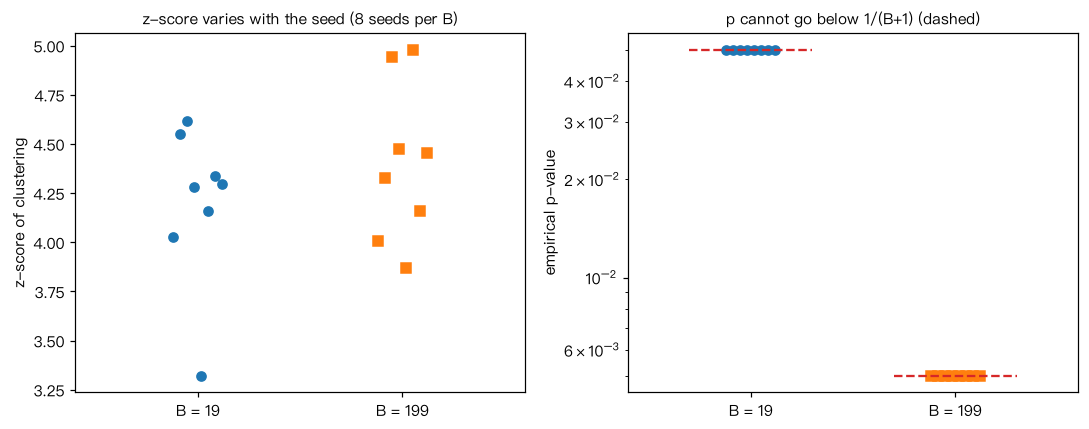
对一个模拟网络,用度保持随机化(双边交换)估计平均聚集系数的 z 分数与单侧经验 p 值; 比较随机网络数 B = 19 与 B = 199 时,8 个不同种子给出的结果离散程度。 经验 p 值用 (1 + #{null ≥ obs}) / (B + 1)(Phipson & Smyth 2010),因此最小可达 1/(B+1): B = 19 时 p 不可能小于 0.05。p 的蒙特卡洛标准误约为 sqrt(p(1-p)/B)。 解读:B 太小时,z 分数随种子明显波动,p 值受分辨率限制;应预先确定足够大的 B, 报告 B 和种子,并检查结论在多个种子下是否一致,而不是换种子直到显著。
Output输出图
Output文字输出
观测平均聚集系数 C = 0.1579
B =  19: 8 个种子的 z 分数范围 3.3–4.6;经验 p 值范围 0.050–0.050(最小可达 0.050)
B = 199: 8 个种子的 z 分数范围 3.9–5.0;经验 p 值范围 0.005–0.005(最小可达 0.005)
若真实 p ≈ 0.04,B =    20 时蒙特卡洛标准误 ≈ 0.0438
若真实 p ≈ 0.04,B =   100 时蒙特卡洛标准误 ≈ 0.0196
若真实 p ≈ 0.04,B =  1000 时蒙特卡洛标准误 ≈ 0.0062
若真实 p ≈ 0.04,B = 10000 时蒙特卡洛标准误 ≈ 0.0020
Code代码
# 对一个模拟网络,用度保持随机化(双边交换)估计平均聚集系数的 z 分数与单侧经验 p 值;
# 比较随机网络数 B = 19 与 B = 199 时,8 个不同种子给出的结果离散程度。
# 经验 p 值用 (1 + #{null ≥ obs}) / (B + 1)(Phipson & Smyth 2010),因此最小可达 1/(B+1):
# B = 19 时 p 不可能小于 0.05。p 的蒙特卡洛标准误约为 sqrt(p(1-p)/B)。
# 解读:B 太小时,z 分数随种子明显波动,p 值受分辨率限制;应预先确定足够大的 B,
# 报告 B 和种子,并检查结论在多个种子下是否一致,而不是换种子直到显著。
import numpy as np
import networkx as nx

G = nx.powerlaw_cluster_graph(150, 3, 0.15, seed=42)          # 模拟网络
obs = nx.average_clustering(G)
print(f"观测平均聚集系数 C = {obs:.4f}")

def null_stats(G, B, seed):
    rng = np.random.default_rng(seed); vals = []
    for _ in range(B):
        H = G.copy()
        nx.double_edge_swap(H, nswap=2 * H.number_of_edges(), max_tries=10**6,
                            seed=int(rng.integers(2**31)))
        vals.append(nx.average_clustering(H))
    return np.array(vals)

mc = {}                                                  # 保存各 B 下的 z 与 p 用于作图
for B in [19, 199]:
    zs, ps = [], []
    for seed in range(8):
        null = null_stats(G, B, seed)
        zs.append((obs - null.mean()) / null.std(ddof=1))
        ps.append((1 + np.sum(null >= obs)) / (B + 1))
    print(f"B = {B:3d}: 8 个种子的 z 分数范围 {min(zs):.1f}–{max(zs):.1f};"
          f"经验 p 值范围 {min(ps):.3f}–{max(ps):.3f}(最小可达 {1/(B+1):.3f})")
    mc[B] = (zs, ps)
p_hat = 0.04
for B in [20, 100, 1000, 10000]:
    print(f"若真实 p ≈ {p_hat},B = {B:5d} 时蒙特卡洛标准误 ≈ {np.sqrt(p_hat * (1 - p_hat) / B):.4f}")

# 作图:8 个种子下的 z 分数与经验 p 值(B = 19 vs 199)
import matplotlib.pyplot as plt
fig, ax = plt.subplots(1, 2, figsize=(10, 4))
for j, (B, mk) in enumerate([(19, "o"), (199, "s")]):
    zs, ps = mc[B]
    ax[0].plot(np.full(8, j) + np.linspace(-0.12, 0.12, 8), zs, mk, label=f"B = {B}")
    ax[1].plot(np.full(8, j) + np.linspace(-0.12, 0.12, 8), ps, mk)
    ax[1].hlines(1 / (B + 1), j - 0.3, j + 0.3, color="C3", ls="--")
for a, yl in zip(ax, ["z-score of clustering", "empirical p-value"]):
    a.set_xticks([0, 1]); a.set_xticklabels(["B = 19", "B = 199"]); a.set_xlim(-0.6, 1.6); a.set_ylabel(yl)
ax[0].set_title("z-score varies with the seed (8 seeds per B)", fontsize=10)
ax[1].set_yscale("log"); ax[1].set_title("p cannot go below 1/(B+1) (dashed)", fontsize=10)
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。