Example07 / 08
循环论证(double dipping)——用同一份数据选边又检验边
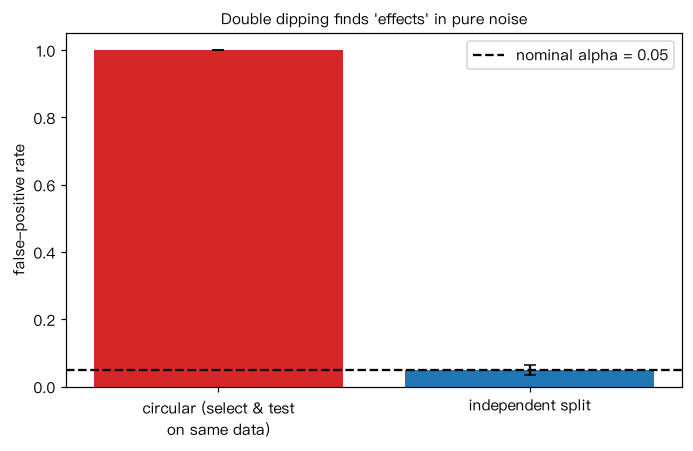
两组被试的数据来自同一分布(不存在任何真实组间差异)。 错误做法:在全部数据上找出组间差异最大的 10 条边,再在同一数据上检验这 10 条边的组间差异。 正确做法:在一半被试上选边,在另一半独立被试上检验。重复 200 次,统计“检出差异”的比例。 解读:循环分析在纯噪声中也几乎总是“显著”;选择和检验必须用独立数据(或把选择步骤放进置换检验)。
Output输出图
Output文字输出
纯噪声数据中“显著”比例:循环分析 1.00;独立分半 0.05(名义水平 0.05)
Code代码
# 两组被试的数据来自同一分布(不存在任何真实组间差异)。
# 错误做法:在全部数据上找出组间差异最大的 10 条边,再在同一数据上检验这 10 条边的组间差异。
# 正确做法:在一半被试上选边,在另一半独立被试上检验。重复 200 次,统计“检出差异”的比例。
# 解读:循环分析在纯噪声中也几乎总是“显著”;选择和检验必须用独立数据(或把选择步骤放进置换检验)。
import numpy as np
from scipy.stats import ttest_ind

rng = np.random.default_rng(11)
n_per, p = 40, 20
iu = np.triu_indices(p, 1)

def subject_edges(n):
    """每个被试 60 个时间点的相关矩阵上三角,作为该被试的“连接向量”(模拟数据)。"""
    out = []
    for _ in range(n):
        X = rng.normal(size=(60, p))
        out.append(np.arctanh(np.corrcoef(X.T)[iu]))
    return np.array(out)

circ, split = 0, 0
for _ in range(200):
    A, B = subject_edges(n_per), subject_edges(n_per)
    t_all = ttest_ind(A, B).statistic
    top = np.argsort(-np.abs(t_all))[:10]; s = np.sign(t_all[top])          # 按差异方向对齐后取平均
    circ += ttest_ind((A[:, top] * s).mean(1), (B[:, top] * s).mean(1)).pvalue < 0.05
    h = n_per // 2
    t_half = ttest_ind(A[:h], B[:h]).statistic
    top = np.argsort(-np.abs(t_half))[:10]; s = np.sign(t_half[top])
    split += ttest_ind((A[h:, top] * s).mean(1), (B[h:, top] * s).mean(1)).pvalue < 0.05
print(f"纯噪声数据中“显著”比例:循环分析 {circ / 200:.2f};独立分半 {split / 200:.2f}(名义水平 0.05)")

# 作图:纯噪声下两种做法的假阳性率(200 次重复,误差线为二项标准误)
import matplotlib.pyplot as plt
fig, ax = plt.subplots(figsize=(6.4, 4.2))
rates = np.array([circ, split]) / 200
ax.bar(["circular (select & test\non same data)", "independent split"], rates,
       yerr=np.sqrt(rates * (1 - rates) / 200), color=["C3", "C0"], capsize=4)
ax.axhline(0.05, color="k", ls="--", label="nominal alpha = 0.05")
ax.set_ylabel("false-positive rate"); ax.set_ylim(0, 1.05); ax.legend()
ax.set_title("Double dipping finds 'effects' in pure noise", fontsize=10)
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。