Example06 / 15
划分之间的比较——NMI、ARI 与信息变差(VI)
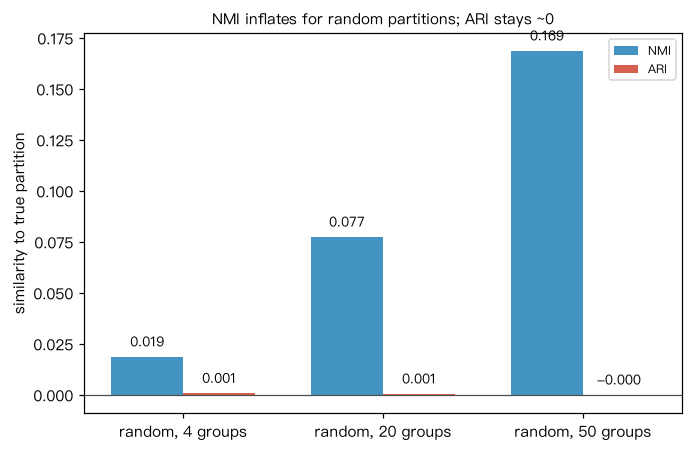
不依赖 scikit-learn,直接由列联表(contingency table)计算三种指标: NMI = 2 I(X;Y) / [H(X)+H(Y)],ARI(Hubert–Arabie 校正),VI = H(X)+H(Y)-2I(X;Y)(以 bit 计)。 (a) 手算例:6 个节点,真实划分 {0,1,2}{3,4,5},检测划分把节点 2 错放到第二组; (b) “随机划分”基线:把节点随机分成很多小组时 NMI 仍明显大于 0,ARI 则接近 0。 输出:(a) NMI≈0.48、ARI≈0.32、VI=1 bit;(b) 随机划分组数越多,NMI 的“虚高”越明显,这是用 ARI 或校正 NMI 的理由。
Output输出图
Output文字输出
(a) NMI = 0.479, ARI = 0.324, VI = 1.000 bit
(b) 随机划分为  4 组: 平均 NMI = 0.019, 平均 ARI = +0.001
(b) 随机划分为 20 组: 平均 NMI = 0.077, 平均 ARI = +0.001
(b) 随机划分为 50 组: 平均 NMI = 0.169, 平均 ARI = -0.000
Code代码
# 不依赖 scikit-learn,直接由列联表(contingency table)计算三种指标:
#   NMI = 2 I(X;Y) / [H(X)+H(Y)],ARI(Hubert–Arabie 校正),VI = H(X)+H(Y)-2I(X;Y)(以 bit 计)。
# (a) 手算例:6 个节点,真实划分 {0,1,2}{3,4,5},检测划分把节点 2 错放到第二组;
# (b) “随机划分”基线:把节点随机分成很多小组时 NMI 仍明显大于 0,ARI 则接近 0。
# 输出:(a) NMI≈0.48、ARI≈0.32、VI=1 bit;(b) 随机划分组数越多,NMI 的“虚高”越明显,这是用 ARI 或校正 NMI 的理由。
import numpy as np


def contingency(x, y):
    xs, xi = np.unique(x, return_inverse=True)
    ys, yi = np.unique(y, return_inverse=True)
    T = np.zeros((len(xs), len(ys)))
    np.add.at(T, (xi, yi), 1)
    return T


def entropy(p):
    p = p[p > 0]
    return -(p * np.log2(p)).sum()


def nmi_vi(x, y):
    T = contingency(x, y)
    P = T / T.sum()
    hx, hy, hxy = entropy(P.sum(1)), entropy(P.sum(0)), entropy(P.ravel())
    mi = hx + hy - hxy
    nmi = 2 * mi / (hx + hy) if hx + hy > 0 else 1.0
    return nmi, hx + hy - 2 * mi


def ari(x, y):
    T = contingency(x, y)
    c2 = lambda v: v * (v - 1) / 2
    s_ij, s_a, s_b, n2 = c2(T).sum(), c2(T.sum(1)).sum(), c2(T.sum(0)).sum(), c2(T.sum())
    expected = s_a * s_b / n2
    return (s_ij - expected) / (0.5 * (s_a + s_b) - expected)


truth = [0, 0, 0, 1, 1, 1]
found = [0, 0, 1, 1, 1, 1]
nmi, vi = nmi_vi(truth, found)
print("(a) NMI = %.3f, ARI = %.3f, VI = %.3f bit" % (nmi, ari(truth, found), vi))

rng = np.random.default_rng(0)
n = 200
truth = np.repeat([0, 1, 2, 3], n // 4)
baseline = []                                  # 存下结果用于作图
for q in [4, 20, 50]:
    vals = [(nmi_vi(truth, rng.integers(0, q, n))[0], ari(truth, rng.integers(0, q, n))) for _ in range(50)]
    vals = np.array(vals)
    print("(b) 随机划分为 %2d 组: 平均 NMI = %.3f, 平均 ARI = %+.3f" % (q, vals[:, 0].mean(), vals[:, 1].mean()))
    baseline.append((q, vals[:, 0].mean(), vals[:, 1].mean()))

# 作图:随机划分与 4 组真实划分比较时的 NMI 与 ARI
import matplotlib.pyplot as plt

qs, nmis, aris = zip(*baseline)
x = np.arange(len(qs))
fig, ax = plt.subplots(figsize=(6.4, 4.2))
ax.bar(x - 0.18, nmis, 0.36, color="#4393c3", label="NMI")
ax.bar(x + 0.18, aris, 0.36, color="#d6604d", label="ARI")
for i in range(len(qs)):
    ax.text(i - 0.18, nmis[i] + 0.005, "%.3f" % nmis[i], ha="center", fontsize=9)
    ax.text(i + 0.18, max(aris[i], 0) + 0.005, "%.3f" % aris[i], ha="center", fontsize=9)
ax.axhline(0, color="0.3", lw=0.8)
ax.set_xticks(x); ax.set_xticklabels(["random, %d groups" % q for q in qs])
ax.set_ylabel("similarity to true partition"); ax.legend(fontsize=8)
ax.set_title("NMI inflates for random partitions; ARI stays ~0", fontsize=10)
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。