Example03 / 11
从窗口相关矩阵到“连接状态”(k-means)
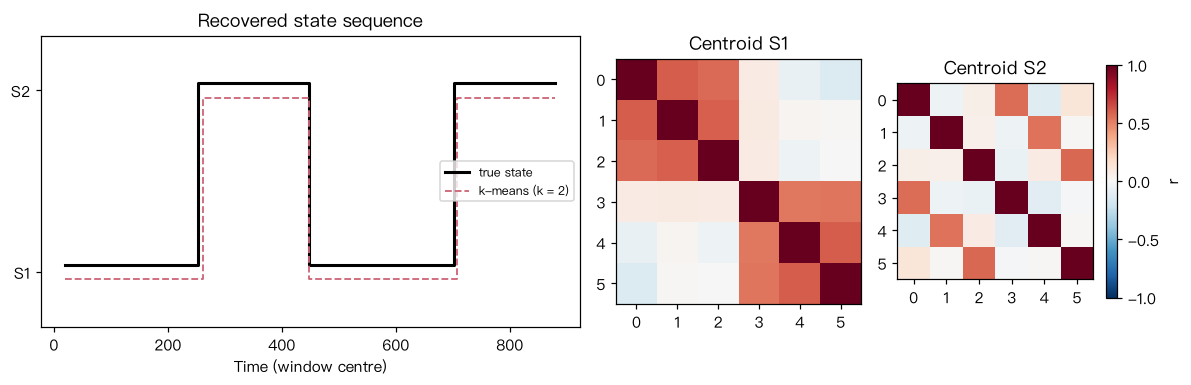
模拟 6 个脑区、900 个时间点,隐藏状态按 S1 → S2 → S1 → S2 交替(段长 250/200/250/200): S1 中脑区 0–2、3–5 各自共享潜在因子;S2 中脑区 0 与 3、1 与 4、2 与 5 两两共享因子。 每个窗口取相关矩阵上三角拉平成 15 维向量,用 k-means 聚类,计算与真实状态的一致率和平均停留时间。 输出解读:k = 2 能较好地恢复状态,交界处的窗口混合两种模式;改用 k = 4 时算法同样给出 4 个“状态”—— 聚类数需要独立的依据(敏感性分析、替代数据比较)。
Output输出图
Output文字输出
窗口数 = 173 ;每个窗口的特征维数 = 15
k = 2:与真实状态一致率 = 0.98,平均停留 = 43.2 个窗口
k = 4:各“状态”窗口数 = [31, 49, 51, 42],平均停留 = 7.9 个窗口
Code代码
# 模拟 6 个脑区、900 个时间点,隐藏状态按 S1 → S2 → S1 → S2 交替(段长 250/200/250/200):
# S1 中脑区 0–2、3–5 各自共享潜在因子;S2 中脑区 0 与 3、1 与 4、2 与 5 两两共享因子。
# 每个窗口取相关矩阵上三角拉平成 15 维向量,用 k-means 聚类,计算与真实状态的一致率和平均停留时间。
# 输出解读:k = 2 能较好地恢复状态,交界处的窗口混合两种模式;改用 k = 4 时算法同样给出 4 个“状态”——
# 聚类数需要独立的依据(敏感性分析、替代数据比较)。
import numpy as np
from scipy.cluster.vq import kmeans2

def ar1_smooth(e, phi=0.8):
    out = np.zeros_like(e)
    for t in range(1, e.shape[-1]):
        out[..., t] = phi * out[..., t - 1] + e[..., t]
    return out

def segment(state, T, rng):
    """模拟数据,仅用于演示方法:用潜在因子生成指定连接模式。"""
    f = rng.standard_normal((3, T))
    X = rng.standard_normal((6, T))
    groups = [[0, 1, 2], [3, 4, 5]] if state == 0 else [[0, 3], [1, 4], [2, 5]]
    for g, members in enumerate(groups):
        for m in members:
            X[m] += 1.2 * f[g]
    return ar1_smooth(X)

def dwell(labels):
    """平均停留时间:连续处于同一状态的平均窗口数。"""
    runs, cur = [], 1
    for a, b in zip(labels[:-1], labels[1:]):
        if a == b:
            cur += 1
        else:
            runs.append(cur)
            cur = 1
    runs.append(cur)
    return np.mean(runs)

rng = np.random.default_rng(3)
lengths, states = [250, 200, 250, 200], [0, 1, 0, 1]
X = np.hstack([segment(s, L, rng) for s, L in zip(states, lengths)])
truth_t = np.concatenate([[s] * L for s, L in zip(states, lengths)])

w, step = 40, 5
iu = np.triu_indices(6, k=1)
starts = list(range(0, X.shape[1] - w + 1, step))
V = np.array([np.corrcoef(X[:, t:t + w])[iu] for t in starts])            # (窗口数, 15)
truth_w = np.array([np.round(truth_t[t:t + w].mean()) for t in starts])   # 以窗口内多数状态为真值
print("窗口数 =", V.shape[0], ";每个窗口的特征维数 =", V.shape[1])

for k in [2, 4]:
    _, lab = kmeans2(V, k, seed=0, minit="++")
    if k == 2:
        acc = max(np.mean(lab == truth_w), np.mean(lab != truth_w))   # 聚类标签与真值的对应关系任意
        print(f"k = 2:与真实状态一致率 = {acc:.2f},平均停留 = {dwell(lab):.1f} 个窗口")
    else:
        print(f"k = 4:各“状态”窗口数 = {np.bincount(lab, minlength=4).tolist()},"
              f"平均停留 = {dwell(lab):.1f} 个窗口")

import matplotlib.pyplot as plt
cen2, lab2 = kmeans2(V, 2, seed=0, minit="++")     # 与上面 k = 2 相同的设置,重新取出中心
if np.mean(lab2 == truth_w) < 0.5:
    lab2, cen2 = 1 - lab2, cen2[::-1]
fig, axes = plt.subplots(1, 3, figsize=(11, 3.6), gridspec_kw={"width_ratios": [2.2, 1, 1]})
tw = np.array(starts) + w / 2
axes[0].step(tw, truth_w + 0.04, where="mid", color="k", lw=2, label="true state")
axes[0].step(tw, lab2 - 0.04, where="mid", color="#CC6677", lw=1.2, ls="--", label="k-means (k = 2)")
axes[0].set(yticks=[0, 1], yticklabels=["S1", "S2"], ylim=(-0.3, 1.3), xlabel="Time (window centre)",
            title="Recovered state sequence")
axes[0].legend(fontsize=8, loc="center right")
for c in range(2):
    M = np.eye(6); M[iu] = cen2[c]; M = M + np.triu(M, 1).T
    im = axes[c + 1].imshow(M, cmap="RdBu_r", vmin=-1, vmax=1)
    axes[c + 1].set(title=f"Centroid S{c + 1}", xticks=range(6), yticks=range(6))
fig.colorbar(im, ax=axes[2], shrink=0.8, label="r")
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。