Example08 / 11
状态数的选择与分半稳定性
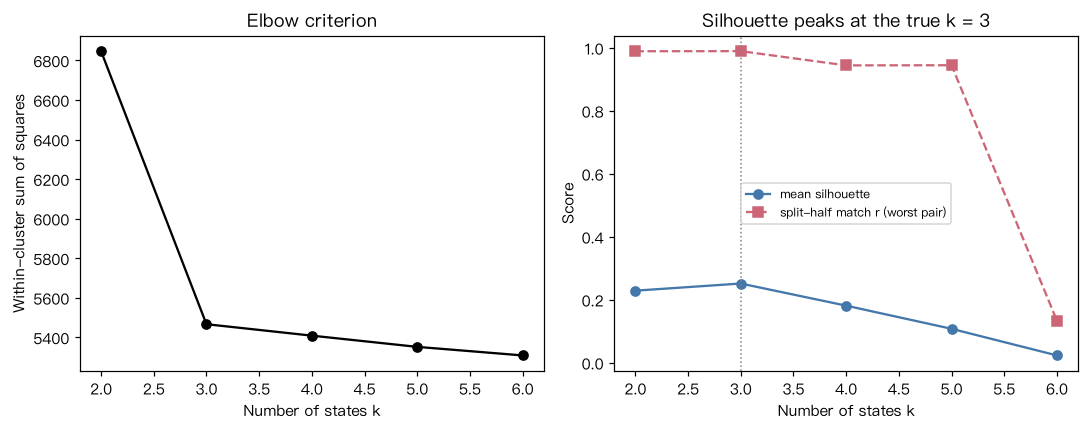
对同一组“窗口连接向量”,比较 k = 2..6 的 k-means:(a) 组内平方和(肘部法则);(b) 平均轮廓系数; (c) 分半稳定性:把窗口随机分成两半分别聚类,用匈牙利算法匹配两半的状态中心,报告匹配后中心的平均相关。 模拟数据有 3 个真实状态(模拟数据,仅用于演示方法)。 输出解读:轮廓系数在 k = 3 最高,组内平方和在 k = 3 之后下降明显变缓(肘部); k 继续增大时多出的“状态”只是把真实状态切碎,k = 6 时分半中心已无法一一对应。 任何单一指标都只是参考,真实数据的“最佳 k”常常不明确,应报告多个 k 下结论是否一致。
Output输出图
Output文字输出
k = 2:组内平方和   6847.2,平均轮廓系数 0.229,分半中心匹配相关(最差一对)0.99
k = 3:组内平方和   5467.0,平均轮廓系数 0.252,分半中心匹配相关(最差一对)0.99
k = 4:组内平方和   5409.2,平均轮廓系数 0.182,分半中心匹配相关(最差一对)0.94
k = 5:组内平方和   5352.5,平均轮廓系数 0.108,分半中心匹配相关(最差一对)0.95
k = 6:组内平方和   5309.3,平均轮廓系数 0.024,分半中心匹配相关(最差一对)0.13
Code代码
# 对同一组“窗口连接向量”,比较 k = 2..6 的 k-means:(a) 组内平方和(肘部法则);(b) 平均轮廓系数;
# (c) 分半稳定性:把窗口随机分成两半分别聚类,用匈牙利算法匹配两半的状态中心,报告匹配后中心的平均相关。
# 模拟数据有 3 个真实状态(模拟数据,仅用于演示方法)。
# 输出解读:轮廓系数在 k = 3 最高,组内平方和在 k = 3 之后下降明显变缓(肘部);
# k 继续增大时多出的“状态”只是把真实状态切碎,k = 6 时分半中心已无法一一对应。
# 任何单一指标都只是参考,真实数据的“最佳 k”常常不明确,应报告多个 k 下结论是否一致。
import numpy as np
from scipy.cluster.vq import kmeans2
from scipy.spatial.distance import cdist
from scipy.optimize import linear_sum_assignment

rng = np.random.default_rng(5)
D, n_per = 45, 200                                    # 45 维 ≈ 10 个脑区的上三角
centers = rng.normal(0, 0.5, (3, D))
V = np.vstack([c + 0.45 * rng.standard_normal((n_per, D)) for c in centers])

def silhouette(V, lab):
    Dm = cdist(V, V)
    s = np.zeros(len(V))
    for i in range(len(V)):
        same = lab == lab[i]
        a = Dm[i, same].sum() / max(same.sum() - 1, 1)
        b = min(Dm[i, lab == c].mean() for c in np.unique(lab) if c != lab[i])
        s[i] = (b - a) / max(a, b)
    return s.mean()

def best_kmeans(V, k, n_init=10):
    best = None
    for s in range(n_init):
        cen, lab = kmeans2(V, k, seed=s, minit="++")
        sse = ((V - cen[lab]) ** 2).sum()
        if best is None or sse < best[0]:
            best = (sse, cen, lab)
    return best

curves = []                                           # 记录各 k 的指标,供作图
for k in range(2, 7):
    sse, cen, lab = best_kmeans(V, k)
    idx = rng.permutation(len(V)); h1, h2 = idx[: len(V) // 2], idx[len(V) // 2:]
    c1 = best_kmeans(V[h1], k)[1]; c2 = best_kmeans(V[h2], k)[1]
    R = np.corrcoef(c1, c2)[:k, k:]
    row, col = linear_sum_assignment(-R)              # 匈牙利算法:最大化匹配相关
    sil = silhouette(V, lab)
    curves.append((k, sse, sil, R[row, col].min()))
    print(f"k = {k}:组内平方和 {sse:8.1f},平均轮廓系数 {sil:.3f},"
          f"分半中心匹配相关(最差一对){R[row, col].min():.2f}")

import matplotlib.pyplot as plt
cv = np.array(curves)
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
axes[0].plot(cv[:, 0], cv[:, 1], "o-", color="k")
axes[0].set(xlabel="Number of states k", ylabel="Within-cluster sum of squares", title="Elbow criterion")
axes[1].plot(cv[:, 0], cv[:, 2], "o-", color="#4477AA", label="mean silhouette")
axes[1].plot(cv[:, 0], cv[:, 3], "s--", color="#CC6677", label="split-half match r (worst pair)")
axes[1].axvline(3, color="gray", ls=":", lw=1)
axes[1].set(xlabel="Number of states k", ylabel="Score", title="Silhouette peaks at the true k = 3")
axes[1].legend(fontsize=8)
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。