Example03 / 09
模块特征基因、模块–性状关联与 hub 基因
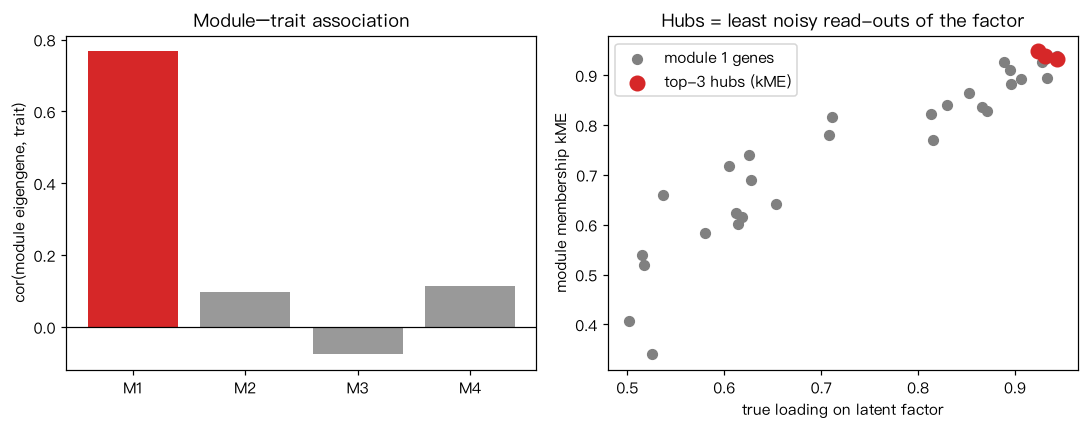
对每个模块计算特征基因 ME(标准化表达的第一主成分,符号与模块平均表达一致)及其解释的方差比例, 计算 ME 与临床性状的相关;再计算模块成员度 kME = cor(基因表达, ME),取 kME 最高的 3 个基因作为 hub。 为突出这一步,这里直接使用真实模块标签;实际分析中用 TOM 聚类得到的模块。 输出解读:模块 1 的 ME 与性状显著相关;hub 基因的真实载荷明显高于模块平均。 在本模拟中,模块 1 的所有基因都只是同一个潜在因子的“读数”,hub 只是噪声最小的读数—— 这正是“hub 适合作标志物、不等于驱动者”的含义。
Output输出图
Output文字输出
模块1: ME 解释方差 = 0.59,ME–性状 r = 0.77, p = 7.9e-13; hub = [12, 29, 18], hub 真实载荷 = [0.92, 0.94, 0.93], 模块平均载荷 = 0.74
模块2: ME 解释方差 = 0.67,ME–性状 r = 0.10, p = 4.6e-01; hub = [32, 33, 30], hub 真实载荷 = [0.87, 0.88, 0.9], 模块平均载荷 = 0.75
模块3: ME 解释方差 = 0.57,ME–性状 r = -0.08, p = 5.6e-01; hub = [57, 65, 60], hub 真实载荷 = [0.93, 0.89, 0.88], 模块平均载荷 = 0.70
模块4: ME 解释方差 = 0.57,ME–性状 r = 0.11, p = 3.8e-01; hub = [76, 85, 82], hub 真实载荷 = [0.89, 0.86, 0.84], 模块平均载荷 = 0.74
Code代码
# 对每个模块计算特征基因 ME(标准化表达的第一主成分,符号与模块平均表达一致)及其解释的方差比例,
# 计算 ME 与临床性状的相关;再计算模块成员度 kME = cor(基因表达, ME),取 kME 最高的 3 个基因作为 hub。
# 为突出这一步,这里直接使用真实模块标签;实际分析中用 TOM 聚类得到的模块。
# 输出解读:模块 1 的 ME 与性状显著相关;hub 基因的真实载荷明显高于模块平均。
# 在本模拟中,模块 1 的所有基因都只是同一个潜在因子的“读数”,hub 只是噪声最小的读数——
# 这正是“hub 适合作标志物、不等于驱动者”的含义。
import numpy as np
from scipy import stats

def simulate(seed=13):
    rng = np.random.default_rng(seed)
    n, sizes = 60, [30, 25, 20, 15]
    trait = rng.normal(size=n)
    factors = [0.8 * trait + 0.6 * rng.normal(size=n)] + [rng.normal(size=n) for _ in sizes[1:]]
    X, labels, load = [], [], []
    for m, (s, f) in enumerate(zip(sizes, factors)):
        for l in rng.uniform(0.5, 0.95, size=s):
            X.append(l * f + np.sqrt(1 - l**2) * rng.normal(size=n))
            labels.append(m + 1); load.append(l)
    for _ in range(30):
        X.append(rng.normal(size=n)); labels.append(0); load.append(0.0)
    return np.array(X).T, np.array(labels), np.array(load), trait

def eigengene(Xm):
    """Xm:样本 x 模块基因(已标准化)。返回 (第一主成分得分, 解释的方差比例),得分符号与模块平均表达一致。"""
    U, S, Vt = np.linalg.svd(Xm, full_matrices=False)
    me = U[:, 0] * S[0]
    if np.corrcoef(me, Xm.mean(axis=1))[0, 1] < 0:
        me = -me
    return me, S[0]**2 / np.sum(S**2)

X, true_lab, true_load, trait = simulate()
Xz = (X - X.mean(0)) / X.std(0)                              # 每个基因标准化

r_trait, kme_by_mod = [], {}
for m in range(1, 5):
    idx = np.where(true_lab == m)[0]
    me, ve = eigengene(Xz[:, idx])
    r, p = stats.pearsonr(me, trait)
    kme = np.array([np.corrcoef(Xz[:, g], me)[0, 1] for g in idx])
    top = idx[np.argsort(-kme)[:3]]
    print(f"模块{m}: ME 解释方差 = {ve:.2f},ME–性状 r = {r:.2f}, p = {p:.1e}; hub = {top.tolist()}, "
          f"hub 真实载荷 = {np.round(true_load[top], 2).tolist()}, 模块平均载荷 = {true_load[idx].mean():.2f}")
    r_trait.append(r); kme_by_mod[m] = (idx, kme, top)

import matplotlib.pyplot as plt
fig, ax = plt.subplots(1, 2, figsize=(10, 4))
ax[0].bar([f"M{m}" for m in range(1, 5)], r_trait, color=["C3"] + ["0.6"] * 3)
ax[0].axhline(0, color="k", lw=0.8); ax[0].set_ylabel("cor(module eigengene, trait)")
ax[0].set_title("Module–trait association")
idx, kme, top = kme_by_mod[1]
ax[1].scatter(true_load[idx], kme, s=40, color="0.5", label="module 1 genes")
ax[1].scatter(true_load[top], kme[np.isin(idx, top)], s=90, color="C3", label="top-3 hubs (kME)")
ax[1].set_xlabel("true loading on latent factor"); ax[1].set_ylabel("module membership kME")
ax[1].set_title("Hubs = least noisy read-outs of the factor"); ax[1].legend()
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。