Example05 / 09
Schäfer–Strimmer 收缩估计偏相关(p > n)
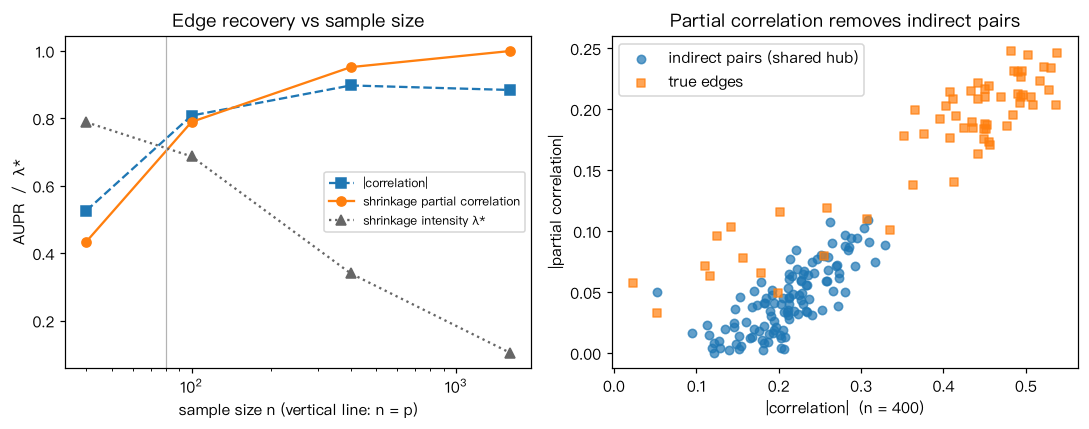
从一个已知的稀疏高斯图模型(80 个基因:8 个枢纽各连 6 个邻居,另加少量随机边)抽取 n 个样本。 n ≤ p 时样本协方差不可逆,普通偏相关无法计算。按 Schäfer & Strimmer(2005)的解析公式估计收缩强度 λ, 把相关矩阵向单位阵收缩 R = λ·I + (1−λ)·R,再求逆得到偏相关;与 |相关| 比较恢复真实边的 AUPR。 输出解读:λ* 随样本量增大而减小。同一枢纽的两个邻居之间没有直接边,却有明显相关;偏相关把这类间接对压到接近 0。 但 n 很小时偏相关估计噪声大、且收缩很强,AUPR 不一定高于相关排序;n 增大后偏相关继续改进,相关排序则停在间接边造成的上限附近。 本示例只演示点估计;GeneNet 还用局部 fdr 判断哪些偏相关显著,这里未实现。
Output输出图
Output文字输出
n =   40(样本协方差奇异):λ* = 0.79;AUPR |相关| = 0.526,AUPR 收缩偏相关 = 0.434(随机 0.020)
n =  100(样本协方差可逆):λ* = 0.69;AUPR |相关| = 0.809,AUPR 收缩偏相关 = 0.790(随机 0.020)
n =  400(样本协方差可逆):λ* = 0.34;AUPR |相关| = 0.898,AUPR 收缩偏相关 = 0.952(随机 0.020)
n = 1600(样本协方差可逆):λ* = 0.10;AUPR |相关| = 0.884,AUPR 收缩偏相关 = 1.000(随机 0.020)
n = 400:间接对平均 |r| = 0.211,平均 |偏相关| = 0.044;真边平均 |r| = 0.395,平均 |偏相关| = 0.176
Code代码
# 从一个已知的稀疏高斯图模型(80 个基因:8 个枢纽各连 6 个邻居,另加少量随机边)抽取 n 个样本。
# n ≤ p 时样本协方差不可逆,普通偏相关无法计算。按 Schäfer & Strimmer(2005)的解析公式估计收缩强度 λ*,
# 把相关矩阵向单位阵收缩 R* = λ*·I + (1−λ*)·R,再求逆得到偏相关;与 |相关| 比较恢复真实边的 AUPR。
# 输出解读:λ* 随样本量增大而减小。同一枢纽的两个邻居之间没有直接边,却有明显相关;偏相关把这类间接对压到接近 0。
# 但 n 很小时偏相关估计噪声大、且收缩很强,AUPR 不一定高于相关排序;n 增大后偏相关继续改进,相关排序则停在间接边造成的上限附近。
# 本示例只演示点估计;GeneNet 还用局部 fdr 判断哪些偏相关显著,这里未实现。
import numpy as np

def sparse_ggm(p=80, seed=7):
    rng = np.random.default_rng(seed)
    K = np.eye(p)
    for h in range(0, p, 10):                               # 枢纽 0, 10, 20, ...,各连 6 个邻居
        for j in range(h + 1, h + 7):
            K[h, j] = K[j, h] = -0.4
    for _ in range(15):
        i, j = rng.choice(p, 2, replace=False); K[i, j] = K[j, i] = 0.2
    K += (abs(np.linalg.eigvalsh(K).min()) + 0.2) * np.eye(p)   # 保证正定
    gold = {(i, j) for i in range(p) for j in range(i + 1, p) if K[i, j] != 0}
    return np.linalg.inv(K), gold

def shrinkage_lambda(X):
    """Schäfer–Strimmer “目标 D”:相关矩阵向单位阵收缩的最优强度 λ*。返回 (λ*, 样本相关矩阵)。"""
    n = X.shape[0]
    Z = (X - X.mean(0)) / X.std(0, ddof=1)
    W = Z[:, :, None] * Z[:, None, :]                       # w_kij = z_ki z_kj
    R = W.sum(0) / (n - 1)
    var_r = n / (n - 1) ** 3 * ((W - W.mean(0)) ** 2).sum(0)
    off = ~np.eye(X.shape[1], dtype=bool)
    return float(np.clip(var_r[off].sum() / (R[off] ** 2).sum(), 0, 1)), R

def pcor_from_corr(R):
    O = np.linalg.inv(R); d = np.sqrt(np.diag(O))
    P = -O / np.outer(d, d); np.fill_diagonal(P, 0); return P

def aupr(S, gold, p):
    iu = np.triu_indices(p, 1); y = np.array([(i, j) in gold for i, j in zip(*iu)])
    ys = y[np.argsort(-np.abs(S[iu]), kind="stable")]
    return np.sum((np.cumsum(ys) / np.arange(1, len(ys) + 1))[ys]) / ys.sum(), y.mean()

Sigma, gold = sparse_ggm()
p = Sigma.shape[0]
rng = np.random.default_rng(3)
ns, curve = [40, 100, 400, 1600], []
for n in ns:
    X = rng.multivariate_normal(np.zeros(p), Sigma, size=n)
    lam, R = shrinkage_lambda(X)
    P = pcor_from_corr(lam * np.eye(p) + (1 - lam) * R)
    Rc = R.copy(); np.fill_diagonal(Rc, 0)
    a_r, base = aupr(Rc, gold, p); a_p, _ = aupr(P, gold, p)
    note = "样本协方差奇异" if n <= p else "样本协方差可逆"
    print(f"n = {n:4d}({note}):λ* = {lam:.2f};AUPR |相关| = {a_r:.3f},AUPR 收缩偏相关 = {a_p:.3f}(随机 {base:.3f})")
    curve.append((lam, a_r, a_p))
# 间接对:同一枢纽的两个邻居(且不是真边)
X = rng.multivariate_normal(np.zeros(p), Sigma, size=400); lam, R = shrinkage_lambda(X)
P = pcor_from_corr(lam * np.eye(p) + (1 - lam) * R)
ind = [(a, b) for h in range(0, p, 10) for a in range(h + 1, h + 7) for b in range(a + 1, h + 7) if (a, b) not in gold]
dirs = sorted(gold)
print(f"n = 400:间接对平均 |r| = {np.mean([abs(R[e]) for e in ind]):.3f},平均 |偏相关| = {np.mean([abs(P[e]) for e in ind]):.3f};"
      f"真边平均 |r| = {np.mean([abs(R[e]) for e in dirs]):.3f},平均 |偏相关| = {np.mean([abs(P[e]) for e in dirs]):.3f}")

import matplotlib.pyplot as plt
lam_, a_r_, a_p_ = np.array(curve).T
fig, ax = plt.subplots(1, 2, figsize=(10, 4))
ax[0].plot(ns, a_r_, "s--", label="|correlation|"); ax[0].plot(ns, a_p_, "o-", label="shrinkage partial correlation")
ax[0].plot(ns, lam_, "^:", color="0.4", label="shrinkage intensity λ*")
ax[0].axvline(p, color="0.7", lw=0.8); ax[0].set_xscale("log")
ax[0].set_xlabel("sample size n (vertical line: n = p)"); ax[0].set_ylabel("AUPR  /  λ*")
ax[0].set_title("Edge recovery vs sample size"); ax[0].legend(fontsize=8)
for pairs, lab, mk in [(ind, "indirect pairs (shared hub)", "o"), (dirs, "true edges", "s")]:
    ax[1].scatter([abs(R[e]) for e in pairs], [abs(P[e]) for e in pairs], s=30, marker=mk, alpha=0.7, label=lab)
ax[1].set_xlabel("|correlation|  (n = 400)"); ax[1].set_ylabel("|partial correlation|")
ax[1].set_title("Partial correlation removes indirect pairs"); ax[1].legend()
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。