Example06 / 09
基于回归的有向推断与先验知识整合(LASSO 路径 + 惩罚因子)
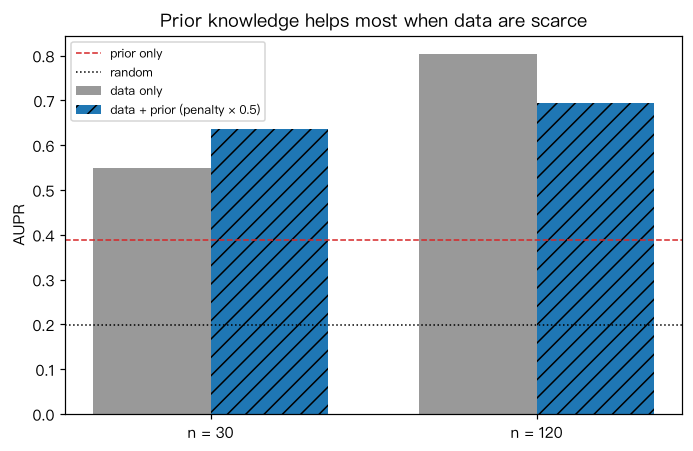
已知 10 个转录因子(TF)与 50 个靶基因,靶基因表达是 1–3 个 TF 的线性组合加噪声(TF 之间彼此相关)。 对每个靶基因用坐标下降求 LASSO 正则化路径,边 TF→靶 的得分 = 该系数首次进入模型时的 λ/λmax(越早进入越可信)。 先验网络含一半真边和同样多的假边(模拟“不完整且有错”的数据库);整合方式是把先验边的惩罚乘以 0.5 (Inferelator 等方法的思路)。在同一真实网络下比较样本少(n = 30)与样本多(n = 120)两种情形。 输出解读:数据弱时,先验明显提高 AUPR;数据强时,先验几乎不再增益,甚至略有拖累。先验中的错误边也会被抬高, 所以整合后的预测仍需独立验证,且评估时不能再用同一个数据库当金标准。
Output输出图
Output文字输出
真边 99 条;先验 98 条(其中正确 49 条);仅先验 AUPR = 0.388
n =  30:仅数据 AUPR = 0.550,数据 + 先验 AUPR = 0.635(随机 0.198);先验错误边的平均得分 0.175 → 0.317
n = 120:仅数据 AUPR = 0.804,数据 + 先验 AUPR = 0.695(随机 0.198);先验错误边的平均得分 0.237 → 0.413
Code代码
# 已知 10 个转录因子(TF)与 50 个靶基因,靶基因表达是 1–3 个 TF 的线性组合加噪声(TF 之间彼此相关)。
# 对每个靶基因用坐标下降求 LASSO 正则化路径,边 TF→靶 的得分 = 该系数首次进入模型时的 λ/λmax(越早进入越可信)。
# 先验网络含一半真边和同样多的假边(模拟“不完整且有错”的数据库);整合方式是把先验边的惩罚乘以 0.5
# (Inferelator 等方法的思路)。在同一真实网络下比较样本少(n = 30)与样本多(n = 120)两种情形。
# 输出解读:数据弱时,先验明显提高 AUPR;数据强时,先验几乎不再增益,甚至略有拖累。先验中的错误边也会被抬高,
# 所以整合后的预测仍需独立验证,且评估时不能再用同一个数据库当金标准。
import numpy as np

def lasso_cd(X, y, lam, w, beta0=None, iters=200):
    """min 1/(2n)||y − Xb||² + lam·Σ w_k|b_k|,X 列已标准化;坐标下降,可用上一个 λ 的解热启动。"""
    n, q = X.shape; b = np.zeros(q) if beta0 is None else beta0.copy(); r = y - X @ b
    for _ in range(iters):
        b_old = b.copy()
        for k in range(q):
            r += X[:, k] * b[k]
            rho = X[:, k] @ r / n
            b[k] = np.sign(rho) * max(abs(rho) - lam * w[k], 0.0)
            r -= X[:, k] * b[k]
        if np.max(np.abs(b - b_old)) < 1e-6:
            break
    return b

def entry_scores(T, y, w, n_lam=40):
    """每个 TF 首次进入 LASSO 路径时的 λ/λmax(从未进入为 0)。"""
    n = len(y); lam_max = np.max(np.abs(T.T @ y) / n / w)
    score = np.zeros(T.shape[1]); b = None
    for lam in lam_max * np.logspace(0, -2, n_lam):
        b = lasso_cd(T, y, lam, w, b)
        score[(b != 0) & (score == 0)] = lam / lam_max
    return score

def aupr(score, gold):
    pairs = [(k, j) for k in range(score.shape[0]) for j in range(score.shape[1])]
    s = np.array([score[e] for e in pairs]); y = np.array([e in gold for e in pairs])
    ys = y[np.argsort(-s, kind="stable")]
    return np.sum((np.cumsum(ys) / np.arange(1, len(ys) + 1))[ys]) / ys.sum(), y.mean()

rng = np.random.default_rng(11)
n_tf, n_tg = 10, 50
L = np.linalg.cholesky(0.5 * np.ones((n_tf, n_tf)) + 0.5 * np.eye(n_tf))   # TF 两两相关约 0.5
B = np.zeros((n_tf, n_tg))                                                  # 真实调控系数
for j in range(n_tg):
    for k in rng.choice(n_tf, size=rng.integers(1, 4), replace=False):
        B[k, j] = rng.choice([-1, 1]) * rng.uniform(0.5, 1.0)
gold = {(k, j) for k in range(n_tf) for j in range(n_tg) if B[k, j] != 0}
true_list = sorted(gold); false_pool = [(k, j) for k in range(n_tf) for j in range(n_tg) if B[k, j] == 0]
half = rng.choice(len(true_list), len(true_list) // 2, replace=False)
prior = {true_list[i] for i in half} | {false_pool[i] for i in rng.choice(len(false_pool), len(half), replace=False)}
S_prior = np.array([[1.0 if (k, j) in prior else 0.0 for j in range(n_tg)] for k in range(n_tf)])
S_prior += 1e-3 * rng.random(S_prior.shape)                 # 仅先验:先验边内部随机排序
print(f"真边 {len(gold)} 条;先验 {len(prior)} 条(其中正确 {len(prior & gold)} 条);仅先验 AUPR = {aupr(S_prior, gold)[0]:.3f}")

res = {}
for n in [30, 120]:
    T = rng.normal(size=(n, n_tf)) @ L.T; T = (T - T.mean(0)) / T.std(0)
    Y = T @ B + 1.5 * rng.normal(size=(n, n_tg)); Y = (Y - Y.mean(0)) / Y.std(0)
    S_data = np.zeros((n_tf, n_tg)); S_both = np.zeros((n_tf, n_tg))
    for j in range(n_tg):
        S_data[:, j] = entry_scores(T, Y[:, j], np.ones(n_tf))
        S_both[:, j] = entry_scores(T, Y[:, j], np.array([0.5 if (k, j) in prior else 1.0 for k in range(n_tf)]))
    (a_d, base), (a_b, _) = aupr(S_data, gold), aupr(S_both, gold)
    wrong = [e for e in prior if e not in gold]
    print(f"n = {n:3d}:仅数据 AUPR = {a_d:.3f},数据 + 先验 AUPR = {a_b:.3f}(随机 {base:.3f});"
          f"先验错误边的平均得分 {np.mean([S_data[e] for e in wrong]):.3f} → {np.mean([S_both[e] for e in wrong]):.3f}")
    res[n] = (a_d, a_b, base)

import matplotlib.pyplot as plt
fig, ax = plt.subplots(figsize=(6.4, 4.2))
x = np.arange(len(res))
ax.bar(x - 0.18, [v[0] for v in res.values()], 0.36, color="0.6", label="data only")
ax.bar(x + 0.18, [v[1] for v in res.values()], 0.36, color="C0", hatch="//", label="data + prior (penalty × 0.5)")
ax.axhline(aupr(S_prior, gold)[0], color="C3", ls="--", lw=1, label="prior only")
ax.axhline(list(res.values())[0][2], color="k", ls=":", lw=1, label="random")
ax.set_xticks(x); ax.set_xticklabels([f"n = {n}" for n in res]); ax.set_ylabel("AUPR")
ax.set_title("Prior knowledge helps most when data are scarce"); ax.legend(fontsize=8)
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。