Example11 / 13
度与必需性的混杂——控制复合物成员身份后度还有预测力吗?
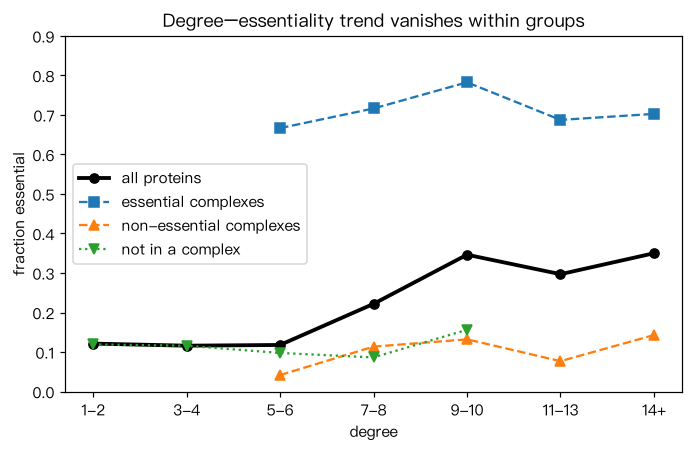
模拟:蛋白分为“必需复合物成员”“非必需复合物成员”“不在复合物中”三类;必需性只由所在复合物决定 (必需复合物成员 70% 必需,其余 10%),而复合物成员因复合物内部稠密而度更高。 用逻辑回归(scipy 最小化负对数似然)比较:只用 log(度) 的模型 vs 同时纳入复合物类别的模型。 输出解读:单独看度,与必需性显著正相关(“中心性–致死性”);控制所在复合物后,度的系数接近 0。 这与 Zotenko 等(2008)的“必需复合物”解释同一逻辑;真实数据还需考虑研究偏倚与检测方法差异。
Output输出图
Output文字输出
只含 log(度):系数 = 0.81 ± 0.08
加入复合物类别:log(度) 系数 = -0.05 ± 0.04;必需复合物系数 = 3.09
度 1–3:必需比例 = 0.12(n = 893)
度 4–8:必需比例 = 0.14(n = 1458)
度 9–100:必需比例 = 0.33(n = 649)
Code代码
# 模拟:蛋白分为“必需复合物成员”“非必需复合物成员”“不在复合物中”三类;必需性只由所在复合物决定
# (必需复合物成员 70% 必需,其余 10%),而复合物成员因复合物内部稠密而度更高。
# 用逻辑回归(scipy 最小化负对数似然)比较:只用 log(度) 的模型 vs 同时纳入复合物类别的模型。
# 输出解读:单独看度,与必需性显著正相关(“中心性–致死性”);控制所在复合物后,度的系数接近 0。
# 这与 Zotenko 等(2008)的“必需复合物”解释同一逻辑;真实数据还需考虑研究偏倚与检测方法差异。
import numpy as np
from scipy.optimize import minimize

rng = np.random.default_rng(5)
n = 3000                                             # 模拟数据,仅用于演示方法
group = rng.choice(3, size=n, p=[0.1, 0.2, 0.7])     # 0 必需复合物,1 非必需复合物,2 不在复合物
lam = np.where(group == 2, 3.0, 9.0)                 # 复合物成员度更高
deg = rng.poisson(lam) + 1
p_ess = np.where(group == 0, 0.7, 0.1)
ess = rng.random(n) < p_ess

def logit_fit(X, y):
    X = np.column_stack([np.ones(len(y)), X])
    nll = lambda b: np.sum(np.logaddexp(0, X @ b)) - y @ (X @ b)
    res = minimize(nll, np.zeros(X.shape[1]), method="BFGS")
    se = np.sqrt(np.diag(res.hess_inv))
    return res.x, se

x = np.log(deg)
b1, se1 = logit_fit(x[:, None], ess.astype(float))
b2, se2 = logit_fit(np.column_stack([x, group == 0, group == 1]).astype(float), ess.astype(float))
print(f"只含 log(度):系数 = {b1[1]:.2f} ± {se1[1]:.2f}")
print(f"加入复合物类别:log(度) 系数 = {b2[1]:.2f} ± {se2[1]:.2f};必需复合物系数 = {b2[2]:.2f}")
for lo, hi in [(1, 3), (4, 8), (9, 100)]:
    m = (deg >= lo) & (deg <= hi)
    print(f"度 {lo}–{hi}:必需比例 = {ess[m].mean():.2f}(n = {m.sum()})")

import matplotlib.pyplot as plt
edges_k = [1, 3, 5, 7, 9, 11, 14, 100]                 # 度分箱
mids = [f"{lo}-{hi - 1}" if hi < 100 else f"{lo}+" for lo, hi in zip(edges_k[:-1], edges_k[1:])]
def frac(mask):
    return [ess[mask & (deg >= lo) & (deg < hi)].mean() if np.sum(mask & (deg >= lo) & (deg < hi)) >= 20 else np.nan
            for lo, hi in zip(edges_k[:-1], edges_k[1:])]
fig, ax = plt.subplots(figsize=(6.4, 4.2))
ax.plot(mids, frac(np.ones(n, bool)), "k-o", lw=2.5, label="all proteins")
for g, lab, st in [(0, "essential complexes", "s--"), (1, "non-essential complexes", "^--"), (2, "not in a complex", "v:")]:
    ax.plot(mids, frac(group == g), st, label=lab)
ax.set_xlabel("degree"); ax.set_ylabel("fraction essential"); ax.set_ylim(0, 0.9)
ax.set_title("Degree–essentiality trend vanishes within groups"); ax.legend()
plt.tight_layout(); plt.show()Run在浏览器中运行
首次加载 Python 环境约需 20–40 秒;可以修改参数后重新运行。